

Что привлекло мое внимание к OpenLedger, так это не качество модели. Это вопрос о том, где на самом деле живет трение согласования, как только система выходит за рамки обучения одной модели и начинает координировать участников, валидаторов, наборы данных и петли обратной связи в масштабе.
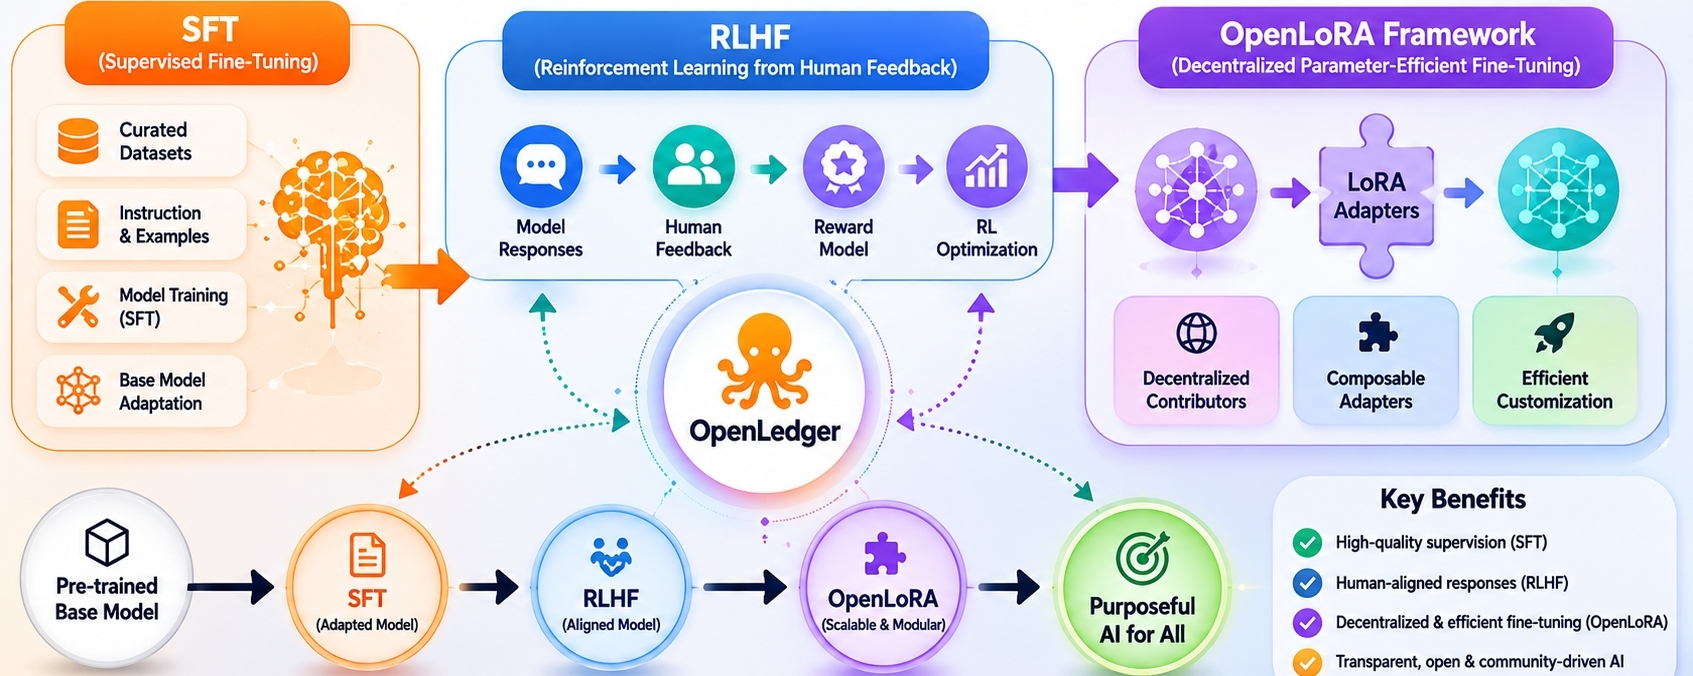
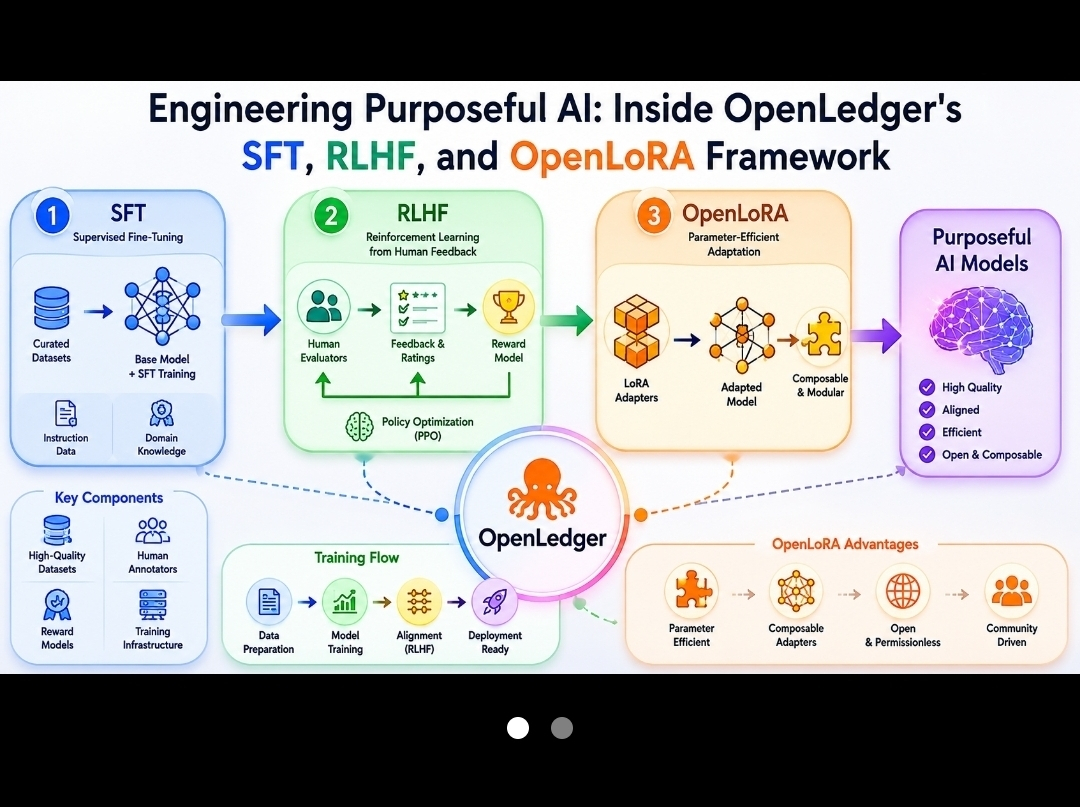
Внутри OpenLedger интересная проблема не в том, работают ли SFT, RLHF или OpenLoRA индивидуально. Большинство людей уже принимают это. Более сложный вопрос — что происходит, когда эти механизмы становятся частью общего производственного окружения, где несколько участников постоянно формируют поведение модели.
Именно здесь начинается операционное напряжение.
Модель может выглядеть надежной во время оценки и при этом стать удивительно нестабильной, когда пути тонкой настройки множатся. Каждый новый набор данных вводит свои предпочтения. Каждый участник добавляет свои предположения. Каждая оптимизация тихо подталкивает модель к другой версии полезности.
Задача не в создании интеллекта.
Задача заключается в сохранении намерения, пока интеллект модифицируется.
Я продолжал замечать это, когда смотрел, как OpenLedger сочетает супервайзинговую тонкую настройку, обучение с подкреплением от человеческой обратной связи и модульную адаптацию через OpenLoRA. На бумаге эти компоненты кажутся взаимодополняющими. На практике они создают конкурирующие давления, которые необходимо управлять где-то.
Сначала возьмите SFT.
Большинство людей рассматривают супервайзинговую тонкую настройку как простой этап. Кураторские примеры попадают внутрь. Улучшенное поведение выходит наружу. Реальность более запутанная. Как только несколько участников начинают предоставлять обучающие данные, проблема смещается с качества на согласованность.
Представьте, что два участника решают одну и ту же задачу поддержки клиентов. Один вознаграждает краткость. Другой вознаграждает исчерпывающие объяснения.
Ни один набор данных не обязательно неправильный.
Но когда оба входят в тренинговый процесс, модель начинает учиться конфликтующим определениям успеха.
Режим сбоя неплавный. Выходы остаются технически правильными, становясь при этом операционно непредсказуемыми.
Пользователь задает один и тот же вопрос дважды и получает резко разные стили ответов.
Ничто не выглядит сломанным.
Тем не менее, доверие начинает eroding.
Здесь акцент OpenLedger на атрибуции становится более интересным, чем само обучение. Если конкретное поведенческое изменение появляется после введения конкретных наборов данных, то прослеживание влияния становится возможным, а не спекулятивным.
Риск, который уменьшается, — это не галлюцинация.
Это неясность относительно того, откуда возникло поведенческое отклонение.
Это звучит незначительно, пока не начинается отладка.
Без атрибуции каждый неожиданный ответ модели становится детективной историей.
С атрибуцией расследование становится более узким и дешевым.
Тем не менее, атрибуция вводит свои собственные затраты. Участники становятся видимыми участниками поведения модели. Видимость создает подотчетность, но также создает и колебание. Некоторые участники становятся более осторожными, потому что их влияние можно измерить.
Этот компромисс кажется реальным.
Лучшая прослеживаемость часто означает более медленные эксперименты.
Затем в картину входит RLHF, и все становится еще менее ясным.
Человеческая обратная связь обычно представляется как слой согласования. Стадия, на которой модели учатся тому, что на самом деле предпочитают люди.
Я не совсем уверен, что это так просто.
Человеческая обратная связь часто более эффективно захватывает непосредственное удовлетворение, чем долгосрочную полезность.
Это различие имеет значение.
Представьте ситуацию, где два ответа отвечают на один и тот же вопрос.
Уверенность становится кратким путем.
Со временем давление оптимизации может подтолкнуть модели к ответам, которые кажутся лучше, прежде чем они станут более правдивыми.
OpenLedger не может полностью устранить это напряжение, потому что ни одна структура не может. То, что она может сделать, это увеличить прозрачность процесса согласования, а не скрывать его за централизованным конвейером.
Это создает интересный тест.
Если две группы обратной связи постоянно не согласны относительно предпочтительных выходов, чьи предпочтения должны доминировать?
Явного ответа нет.
Подозреваю, что многие люди предполагают, что децентрализация автоматически решает эту проблему.
Я не уверен, что это так.
Это просто делает разногласия видимыми.
И видимость отличается от разрешения.
Один механический пример иллюстрирует это ясно.
Предположим, модель получает 1,000 событий обратной связи по задачам финансового анализа.
Семьсот вознаграждают краткие ответы.
Триста вознаграждают детальный анализ рисков.
Путь оптимизации полностью зависит от того, как эти сигналы взвешиваются.
Техническая машина имеет меньшее значение, чем предположения о управлении, встроенные в нее.
В конечном итоге кто-то решает, что "лучше" означает.
Даже если это решение возникает коллективно.
Часть, которая меня больше всего интересует, это OpenLoRA, потому что именно здесь трение согласования становится ощутимым.
Традиционная тонкая настройка часто ведет себя как замена частей двигателя, пока он работает. Каждая модификация несет в себе возможность непредвиденных последствий в другом месте.
OpenLoRA меняет единицу адаптации.
Вместо того чтобы постоянно модифицировать большие фундаментальные модели, участники могут создавать специализированные адаптации, которые остаются более модульными.
Это звучит как чистое улучшение, пока не появляется операционная реальность.
Модульная система снижает одну категорию ошибок, создавая другую.
Теперь задача становится выбором.
Какая адаптация должна быть использована?
Какую версию следует приоритизировать?
Трение не исчезает.
Она движется.
Я думаю, что это движение является одним из самых недооцененных динамиков в инфраструктуре ИИ.
Системы редко устраняют сложность.
Они перемещают это.
OpenLoRA, похоже, перемещает сложность от повторного обучения моделей к координации моделей.
Это часто хороший обмен.
Но это остается обменом.
Представьте себе две специфические для домена LoRA.
Один специализируется на юридическом анализе.
Другой специализируется на поддержке клиентов.
Индивидуально оба показывают хорошие результаты.
Смешанный рабочий процесс внезапно требует решений о маршрутизации, приоритете, совместимости и оценке.
Слой модели становится легче обновлять.
Слой координации становится труднее управлять.
Какое бремя вы предпочли бы нести?
Я искренне думаю, что разумные люди могут ответить по-разному.
Это также объясняет, почему экономический слой OpenLedger в конечном итоге становится актуальным.
Не сразу.
Не как спекуляция.
Как инфраструктура.
Как только атрибуция, обратная связь и адаптация становятся измеримыми действиями, стимулы неизбежно входят в разговор. Участникам нужны причины для поддержания наборов данных. Валидаторам нужны причины для оценки качества. Поставщикам обратной связи нужны причины для честного участия.
В конечном итоге роль токена OPEN появляется почти по необходимости, потому что координация без стимулов обычно распадается под масштабом.
Интересный вопрос не в том, существуют ли стимулы.
Интересный вопрос заключается в том, продолжают ли стимулы вознаграждать полезность после прихода роста.
История показывает, что именно здесь многие системы сталкиваются с трудностями.
Что заставляет меня возвращаться к OpenLedger, так это не обещание открытой разработки ИИ. Множество проектов обещает открытость.
Это готовность показать, где на самом деле накапливаются затраты на согласование.
Не в архитектуре модели.
Не в бенчмарках.
В запутанном пространстве между участниками, пытающимися направить один и тот же интеллект к немного различным целям.
Может быть, настоящий тест удивительно прост.
Если два одинаково квалифицированных участника обучают систему различным определениям качества, может ли структура выявить этот конфликт до того, как пользователи столкнутся с последствиями?
И если это возможно, улучшает ли эта прозрачность результаты или просто облегчает наблюдение за разногласиями?
Я не думаю, что ответ уже решен.
Чем больше я смотрю на SFT, RLHF и OpenLoRA вместе, тем меньше они напоминают техники оптимизации и тем больше они напоминают механизмы переговоров.
Переговоры между наборами данных.
Переговоры между предпочтениями.
Переговоры между открытостью и согласованностью.
Большинство ИИ-систем скрывают эти переговоры за интерфейсом.
OpenLedger, похоже, настроен на то, чтобы выявить их.
Будет ли это в конечном итоге производить лучший интеллект или просто более видимое трение, это все еще то, что я продолжаю тестировать.
