
Вечером, разбирая накопившиеся на компьютере старые проекты и логи, я не удержался и заглянул в несколько страниц своих записей по отладке смарт-контрактов. Там было полно записей о кривых потребления газа в различных крайних ситуациях и мыслях по устранению сбоев синхронизации состояния, что заставило меня слегка усмехнуться. За эти годы я впитал много практического опыта и данных в различные инструменты для проверки своих идей, и в итоге обнаружил, что действительно ценный базовый опыт часто легко собирается на централизованных платформах, в то время как сами вкладчики редко получают адекватное вознаграждение. Это ощущение заставляет меня настороженно относиться к проектам, которые заявляют о намерении реконструировать ценность данных.
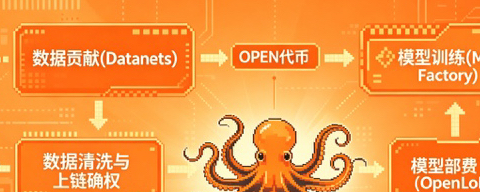
С таким настроением, Кадзу в последнее время обратил внимание на проект OpenLedger, который постепенно упоминается в сообществе. Сначала я не ожидал многого, потому что раньше видел слишком много решений с ярлыком AI, которые лишь поверхностно касались темы. Но когда я потратил несколько дней на тщательное изучение@OpenLedger их кода основного протокола, особенно модуля децентрализованной сетевой данных под названием Datanets, я обнаружил, что они действительно пытаются найти более практичный путь, используя блокчейн для реального отображения потоков ценностей в процессе AI-вывода на проверяемое цепочное расчеты.
Предложенный механизм payable AI в основном основывается на криптоидентификаторах и модульном дизайне смарт-контрактов, что позволяет четко отслеживать каждое обращение к модели, вклад данных или предоставление вычислительной мощности, и получать соответствующее вознаграждение. Представьте себе, разработчик загружает свой обученный модуль извлечения уникальных признаков в сеть, и если какие-то квантовые команды используют этот модуль для помощи в анализе рынка, основной протокол автоматически разбивает и перераспределяет оплату в зависимости от предустановленного веса вклада. Такой подход на уровне идеи довольно чистый, он пытается передать распределительные полномочия, ранее полностью контролируемые крупными платформами, фактическим вкладчикам через децентрализованный метод.
С точки зрения инженера,#OpenLedger эта архитектура вызывает у меня восхищение своей модульной концепцией. Datanets организует слои данных, моделей и расчетов относительно независимо, что упрощает последующие итерации и локальные обновления, не позволяя проблемам в одном из звеньев привести к поломке всей системы. Я сам несколько раз запускал полные вызовы на тестовой сети согласно документации, порог входа не очень низкий, но логика достаточно ясна; для тех, кто имеет опыт с Solidity и распределенными системами, за один-два дня можно настроить основные взаимодействия. После запуска задержки и стоимость оказались более стабильными, чем я ожидал. Конечно, это всего лишь маломасштабное тестирование, а производительность в реальных высоконагруженных сценах потребует более длительного наблюдения.$OPEN
Но я также понимаю, что любые подобные попытки не обойтись без реальных инженерных вызовов. Высокая зависимость от механизма реального расчета в цепочке, сталкиваясь с многомодальными и высокомасштабными задачами AI, может быстро увеличить задержки в сети и давление синхронизации узлов. Ранее я уже сталкивался с проблемами на других публичных блокчейнах в периоды высокой нагрузки, когда частые задержки подтверждения и неожиданные колебания цен напрямую нарушали многие заранее запланированные автоматизированные процессы. Если Datanets не сможет продолжать итерацию по расширению узлов и оптимизации шардирования, этот риск может заставить некоторых пользователей почувствовать, что традиционные централизованные услуги более надежны.$BTC
Кроме того, в настоящее время типы данных, которыми оперирует их сеть, все еще довольно сосредоточены, в основном вокруг структурированных записей, связанных с финансами, и некоторых открытых обучающих наборов. Это, безусловно, позволяет ранней валидации быть более целенаправленной, но также означает, что до поддержки межотраслевых, по-настоящему разнообразных AI-приложений еще есть заметное расстояние. Если в будущем экосистема разработчиков не сможет быстро обогатиться и продолжать внедрять новые высококачественные данные, то весь цикл распределения ценностей может легко оказаться в низкой активности, став самодостаточным для немногих узлов.
Несмотря на эти потенциальные проблемы, я все же с осторожностью одобряю это направление. Вернуть права на ценообразование со стороны AI-поставщиков от немногих гигантов, используя технологии блокчейн, чтобы снизить порог для обычных разработчиков, чтобы монетизировать свои уникальные ресурсы, — это само по себе стоит серьезного испытания. По крайней мере, это дает возможность тем, кто держит нишевые наборы данных или оптимизированные модели, открыть новый возможный путь.
В следующие месяцы я планирую продолжать следить за их фактической активностью в цепочке в роли наблюдателя: реальным объемом вызовов смарт-контрактов, кривой роста независимых адресов загрузки данных в сети Datanets и стабильностью межмодульных расчетов. Эти данные будут более честными, чем любой белый документ. По окончании периода наблюдения я решу, стоит ли мне инвестировать больше усилий на основе фактических результатов. В целом, я сохраняю сдержанный оптимизм по поводу таких исследований, которые воплощают техническую искренность на уровне кода — не потому, что это звучит революционно, а потому, что оно не избегает реальной сложности мира в инженерных деталях.