в последнее время я изучал архитектуру openledger, в основном вокруг системы атрибуции и стимулов для участников
большинство людей думает, что openledger — это просто еще один токен AI плюс крипта, но честно говоря, более интересная часть — это попытка построить инфраструктуру координации вокруг данных AI
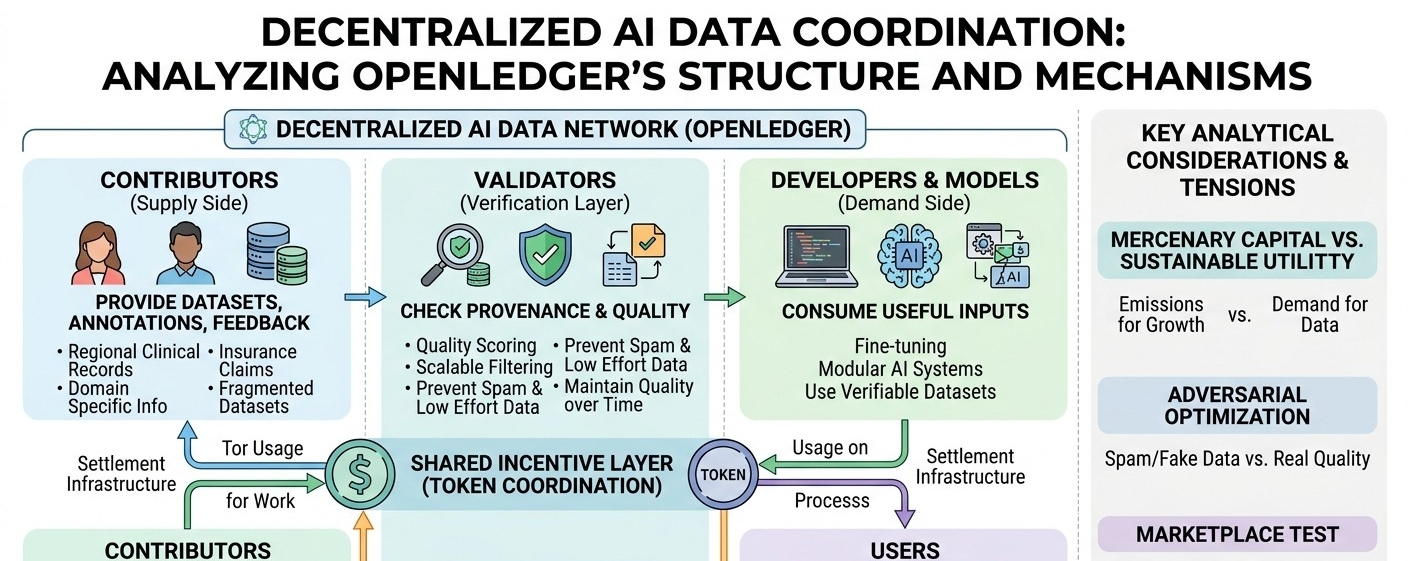
что привлекло мое внимание, так это как сеть пытается соединить участников, валидаторов, разработчиков и пользователей через один общий слой стимулов
участники предоставляют наборы данных, аннотации, обратные связи или специфическую для домена информацию
валидаторы проверяют происхождение и качество
разработчики используют полезные входные данные для моделей
пользователи генерируют спрос через приложения или выводы
теоретически токен координирует ценность во всех них
децентрализованная система вклада на самом деле имеет смысл в определенных областях
модель здравоохранения, обученная на региональных клинических записях или аннотациях страховых требований, вероятно, нуждается в фрагментированных наборах данных, которые централизованные системы не всегда приоритизируют
openledger, похоже, спроектирован с учетом этого предположения
что будущие ai системы станут более модульными и внешне координированными, а не полностью вертикально интегрированными
затем есть слой атрибуции, который, честно говоря, кажется самой сложной частью всей архитектуры
если вкладчики вознаграждаются на основе полезности, как протокол знает, какие данные действительно имели значение
и это та часть, о которой я продолжаю думать
ai модели впитывают паттерны из смешанных входных данных
один маленький высококачественный набор данных может иметь большее значение, чем миллионы общих примеров
поэтому атрибуция быстро становится вероятностной
может быть, это приемлемо
вкладчики, вероятно, не нуждаются в идеальной точности
им просто нужна система, которая кажется достаточно справедливой и трудной для манипуляций
но как только токеновые вознаграждения становятся значимыми, люди начинают оптимизировать вокруг любых метрик, которые измеряет протокол
вот где проявляется напряжение стимулов
если эмиссия доминирует до того, как возникнет реальный спрос, вкладчики могут загружать дублированные наборы данных, синтетические заполнители, аннотации с низким уровнем усилий или спам-взаимодействия просто потому, что система вознаграждений это позволяет
поэтому слой верификации важен так же, как и слой вклада
openledger нуждается в отслеживании происхождения, оценке качества и масштабируемой фильтрации без уклонения в централизованную модерацию
слишком мало фильтрации, и сеть становится шумной
слишком много фильтрации, и декомпозированная основа ослабевает
сторона рынка, вероятно, является настоящим долгосрочным тестом
в идеале разработчики платят за проверенные наборы данных или доступ к моделям, пользователи генерируют спрос на выводы, а вкладчики зарабатывают на фактическом использовании сети, а не только на эмиссии
в этой версии токен становится инфраструктурой для расчетов, а не просто топливом для стимулов
но вся архитектура зависит от того, станет ли будущий спрос на ai достаточно фрагментированным, чтобы нуждаться в этом виде координационного слоя
если крупные платформы продолжат контролировать обучение, развертывание и обратную связь от пользователей внутри, децентрализованные ai рынки данных могут оставаться относительно нишевыми
наблюдая
реальные сборы за использование против эмиссий
качество предоставленных наборов данных с течением времени
спрос разработчиков на атрибутивные внешние данные
как споры по атрибуции масштабируются с участием
пока нет четкого вывода
openledger, возможно, строит устойчивый координационный слой для распределенных ai систем
или это может быть тестом того, могут ли токеновые стимулы создать рынок до того, как сторона спроса полностью возникнет