

Одно, что я постоянно замечаю в крипто AI, это то, что все говорят о моделях, но почти никто не говорит о репутации.
Это странно, потому что в трейдинге репутация — это, по сути, всё.
Я не доверяю сигналу только потому, что он звучит умно. Я доверяю ему, когда знаю:
откуда пришли данные,
кто это предоставил,
были ли эти участники точны раньше,
и согласованы ли стимулы.
Вот почему архитектура OpenLedger кажется более важной, чем многие осознают.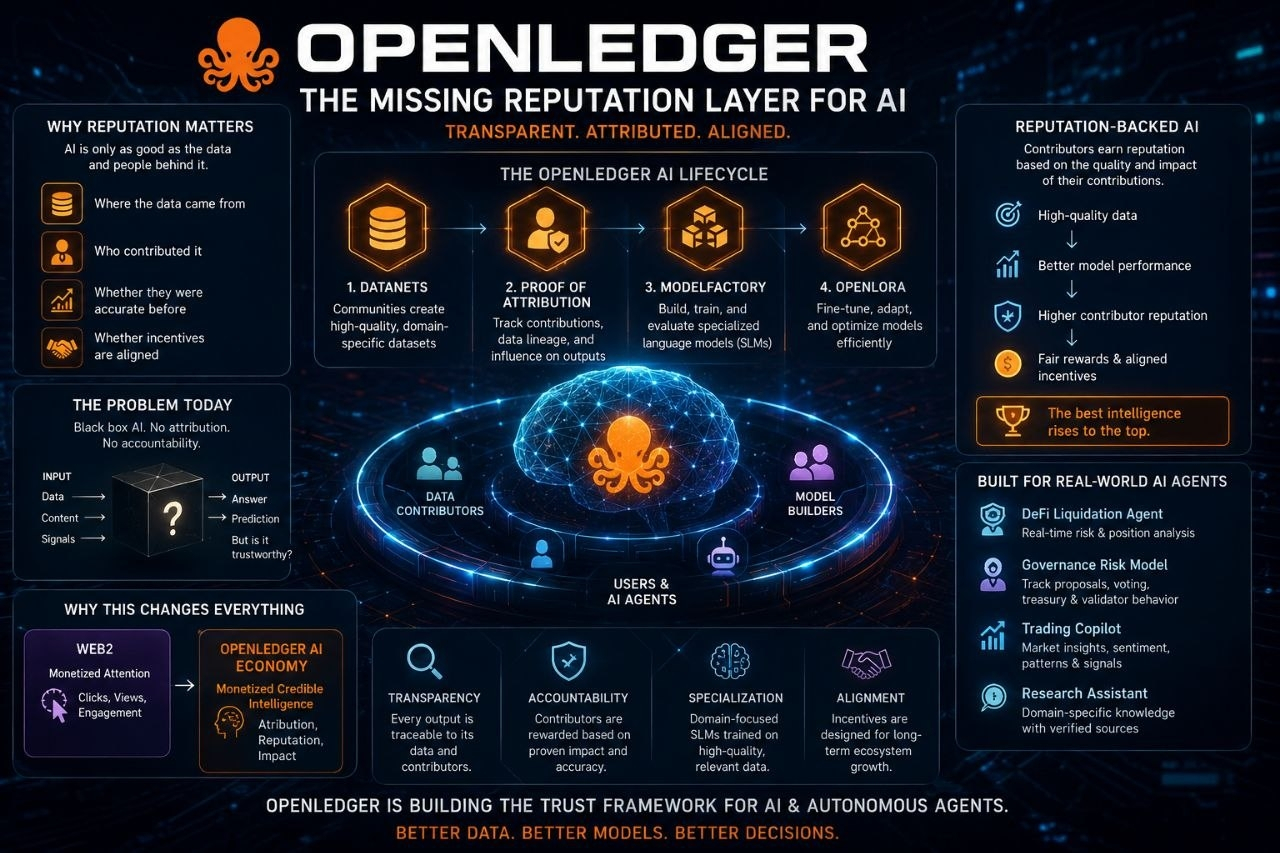
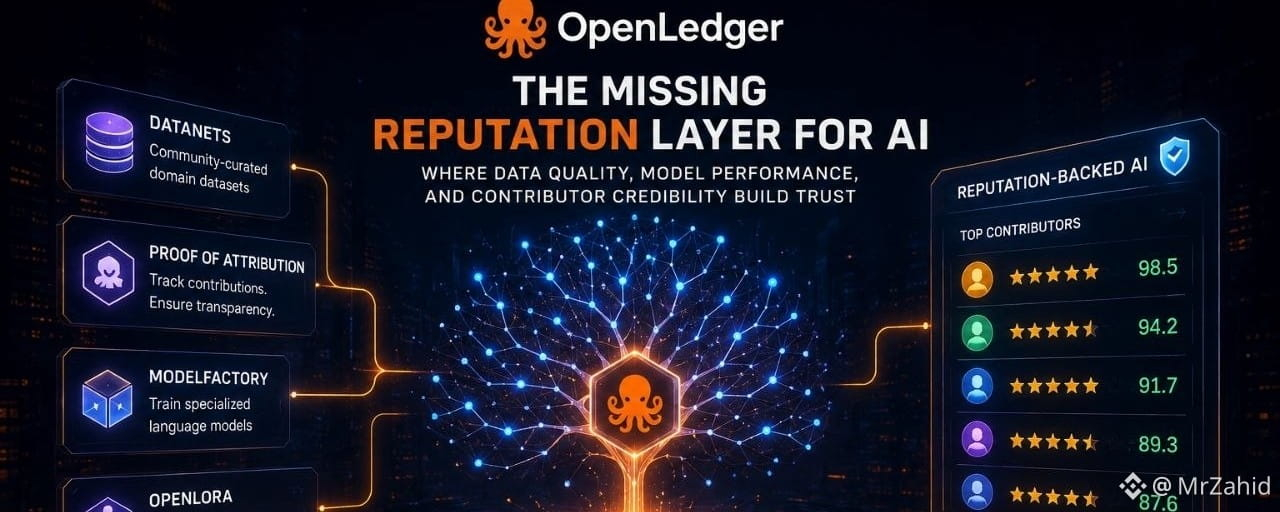
OpenLedger не только пытается разместить AI модели в блокчейне. Большая игра, похоже, заключается в создании экономической системы, где качество данных, производительность моделей и надежность участников связаны через прозрачную атрибуцию. Их инфраструктура сочетает в себе Datanets, Proof of Attribution, ModelFactory и OpenLoRA в полный стек жизненного цикла AI.
Самое интересное? Это закладывает основу для AI, подкреплённого репутацией.
И честно, я думаю, что сейчас этот нарратив сильно недооценён.
Большинство систем ИИ сегодня работают как чёрные ящики. Ты задаёшь вопрос, получаешь ответ и просто надеешься, что исходные данные не были мусором. Но механизм Proof of Attribution у OpenLedger предназначен для того, чтобы отслеживать, какие датасеты и участники повлияли на выходные результаты модели.
Это полностью меняет стимулы.
Представьте крипто-исследовательскую Datanet-сеть, сфокусированную только на риске в управлении. Участники загружают обзоры по управлению, изменения в казначействе, поведение валидаторов, обсуждения по предложениям и аномалии голосований. Со временем система может определить, какие участники стабильно дают информацию с высоким сигналом, которая улучшает дальнейшие выходные данные AI.
И вот вдруг вкладчики — это уже не просто «пользователи».
Они становятся поставщиками интеллекта, несущего репутацию.
Это огромный сдвиг.
Потому что будущая AI-экономика, вероятно, не будет вознаграждать просто объём сырого контента. Она будет вознаграждать подтверждённую полезность.
Как трейдеру, мне это очень важно. Самые сильные инсайты рынка, которые я когда-либо находил, приходили от нишевых исследователей с крошечной аудиторией, но невероятно точным распознаванием паттернов. Сейчас системы ИИ сводят всю информацию в один и тот же «один бульон». Структура OpenLedger потенциально позволяет приоритизировать вклад в зависимости от качества атрибуции и ценности исторического вклада.
Это ближе к тому, как реально работает принятие решений.
Я также думаю, что фокус OpenLedger на специализированных языковых моделях (SLM) разумнее, чем то, как рынок отдаёт ему должное. Исследования вокруг OpenLedger снова и снова подчёркивают интеллект, заточенный под домен, вместо попытки собрать одну гигантскую универсальную модель.
И честно… это действительно соответствует тому, как альфа работает на практике.
Общая эрудиция редко создаёт преимущество. Специализированный контекст — да.
Децентрализованному агенту для ликвидаций в DeFi не нужно понимать поэзию.
Модель, оценивающая риск в управлении, не нуждается в киношных мелочах.
Торговому копилоту не нужен широкий «интернет-шума»
Им нужен чёткий, сфокусированный контекст, обученный на качественных данных из домена.
Datanets в OpenLedger по сути созданы на основе этого принципа. Сообщества создают адресные датасеты, участники улучшают их, модели специализируются на них, а механизмы атрибуции распределяют награды обратно через систему.
То, что я считаю перспективным, — это не только технология. Это экономический замысел.
Если OpenLedger добьётся успеха, AI-рынок может перестать вознаграждать только масштаб и начать вознаграждать проверяемую экспертность.
Это совершенно другая интернет-экономика.
Платформы, которые доминировали в Web2, монетизировали внимание.
Следующее поколение инфраструктуры ИИ может монетизировать проверяемую интеллектоёмкую информацию.
И если это произойдёт, OpenLedger может стать куда больше, чем просто AI-цепочкой. Он может превратиться в рамку доверия, которой пользуются автономные агенты, чтобы оценивать, какая информация — и какие участники — действительно заслуживают влияния 🤝