

Слушай, сначала скажу одну вещь - когда ты смотришь на такие системы, ты думаешь: "все под контролем, жесткие правила, ограничения..." Но если копнуть глубже, можно понять, что здесь не хаос, а попытка создать намеренную структуру - именно так.
Если я скажу правду от всего сердца.... То, как я читаю @OpenLedger документацию, в одном предложении - это не просто ИИ или платформа данных, а эксперимент над самой идеей того, как данные могут быть "прибылями активами". Теперь давай разберем это, потому что если ты все соберешь вместе, это не влезет в твою голову - никак не влезет.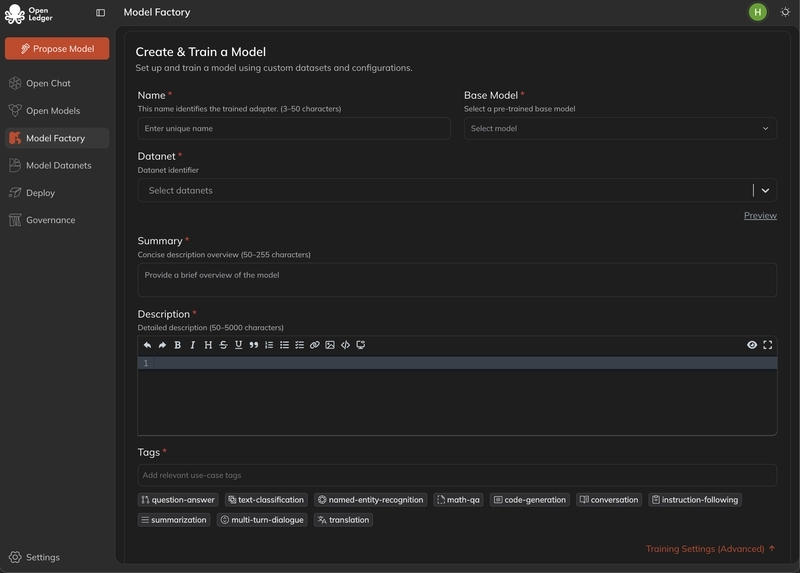
Сначала идёт слой «вклада» от Datanets.
Самое интересное здесь — это ограничения. Текст, изображения, аудио — нельзя смешивать всё подряд. Поначалу это немного странно, потому что когда мы говорим про Web3, обычно думаем обо всём без разрешений. Но здесь наоборот — строгий формат, строгая валидация. Лимит 10 МБ в день, 20 файлов — это тоже кажется небольшим, но на самом деле это не контроль спама, а попытка сохранить правильное соотношение сигнал/шум. Потому что если будет безлимит, то все будут вносить вклад, но будет трудно найти реальную ценность.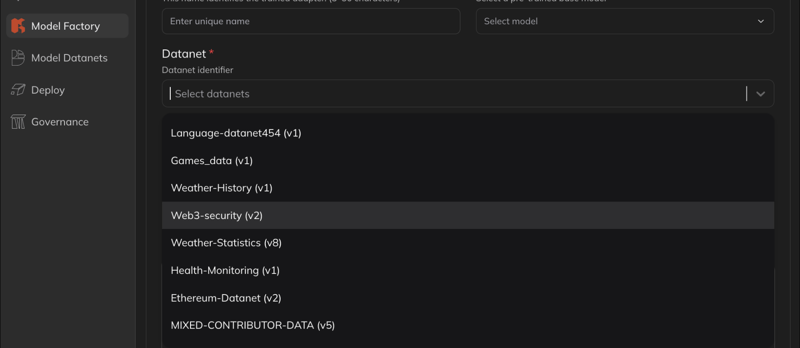
Ещё одна вещь, которая кажется немного забавной — система лидерборда.
Вы можете думать: «чем больше я загружаю, тем выше я буду» — но нет, ни в коем случае. Здесь дело не в количестве, а в принятии. То есть, если вы дадите 10 неправильных данных — ваше эго может быть и довольно, но системе вы вообще не будете интересны. Немного жёстко, но справедливо. А самое интересное — отклонённые файлы не снижают рейтинг. Это выглядит странно здорово. Потому что здесь поощряется экспериментирование, а не вклад, движимый страхом.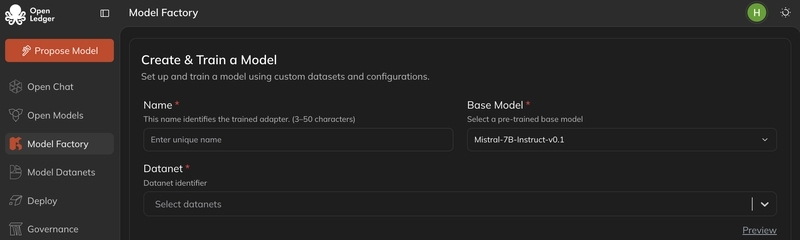
Вот тут и начинается механика ModelFactory.
Это, по сути, самая серьёзная часть OpenLedger. Она полностью меняет вайб здесь. Они пытаются превратить файнтюнинг LLM в рабочий процесс, управляемый интерфейсом, вместо того чтобы просто держать это как инструмент для исследований. Это значит, что вам не нужно быть терминальным воином. Ставка обучения, размер батча, эпоха — всё можно настраивать визуально. На первый взгляд кажется: ну да, удобно для новичков, но на самом деле за этим стоит более глубокая идея — демократизировать разработку ИИ, не теряя при этом контроль.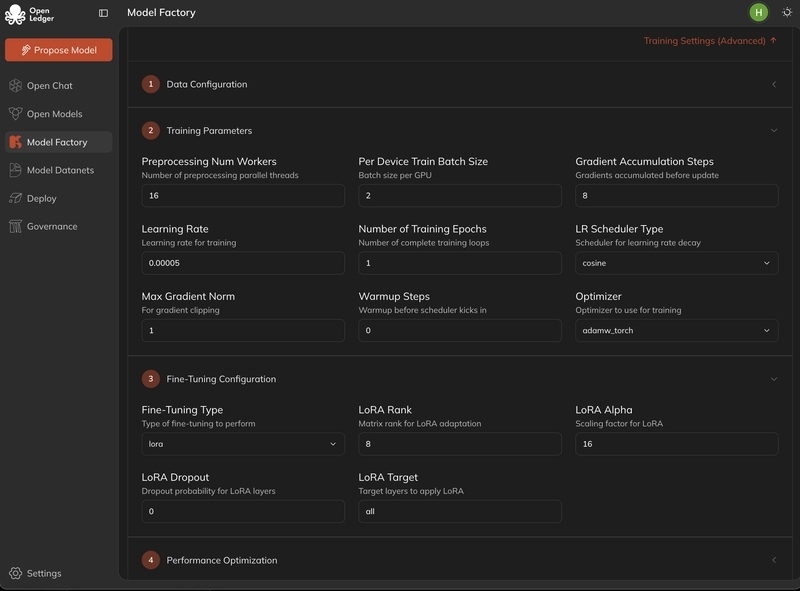
Поддержка LoRA и QLoRA — это здесь практичное движение. Потому что полноценный файнтюнинг в реальности сегодня дорогой. Так что они идут по пути лёгкой адаптации. Реальная работа в реальном времени и посттренинговое взаимодействие — штука довольно интересная, потому что они хотят делать обучение моделей непрерывным циклом, не оставляя конечной точки. Это значит: тренировать ⇨ тестировать ⇨ взаимодействовать ⇨ уточнять.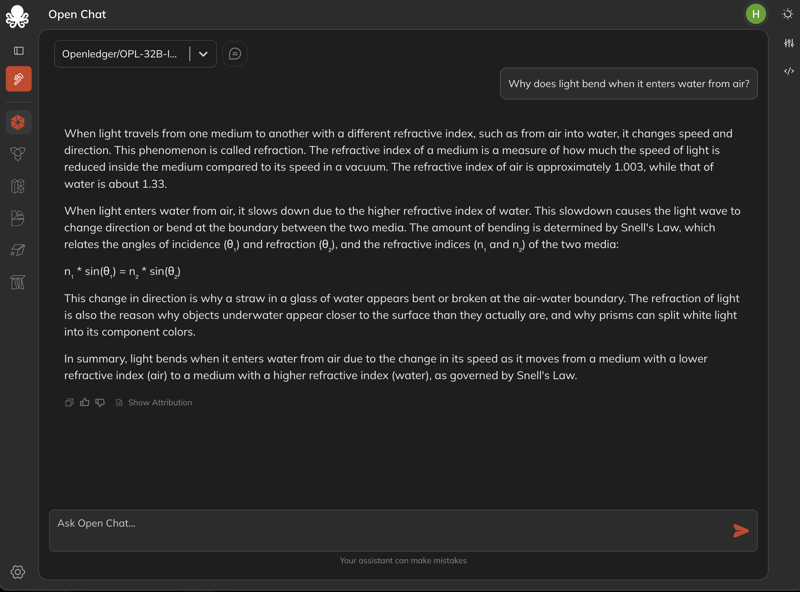
Теперь давайте поговорим о поддерживаемых LLM.
Deepseek, Mistral, Qwen, серия LLaMA — все большие открытые экосистемы здесь. Даже GPT-2, BLOOM, ChatGLM поддерживаются. На первый взгляд может показаться, что они просто включили всё, но на самом деле это стратегия покрытия экосистем. Потому что если держать только модели уровня «элита», будет ограничение. А широкая поддержка означает большой простор для экспериментов.
Теперь расскажу тебе одну забавную деталь
Когда вижу всю эту систему, у меня вспоминается образ — очень дисциплинированная кухня, где никто не может раскидывать ингредиенты как попало. Но когда готовка заканчивается, все могут пробовать и оценивать. Это значит, что здесь нельзя выжить только на одних «хороших вибрациях», даже если хочется.
Последняя часть «Инструкций агенту» — на самом деле самая недооценённая.
Потому что здесь говорится: для углублённых запросов можно получать динамические ответы, используя URL GitBook. Это не совсем статичные документы — скорее, система знаний, к которой можно обращаться через запросы.
Теперь, если мыслить об этом в целом, становится ясно..... на самом деле истина лежит между двумя напряжениями: с одной стороны — децентрализация + открытый вклад, с другой — строгая валидация + контролируемая структура. Не так просто удерживать вместе эти две вещи. Но если баланс будет верным, то можно создать настоящую экономику данных вместо шума. И, честно говоря, именно здесь вопрос становится интересным — данные действительно станут активом будущего, или мы просто пытаемся решить старую проблему валидации, но под новым названием?
Не уверен, что сейчас есть окончательный ответ. Но как слой экспериментов — игнорировать это не стоит... Но правда🚀