#openledger $OPEN $BTC #Почему OpenLedger изменил мой взгляд на инфраструктуру ИИ
Несколько вечеров назад я тестировал платформы искусственного интеллекта, о которых говорили на Crypto Twitter. Большинство из них были для меня запутанными. Одна платформа требовала, чтобы я настроил её определённым образом. Другая платформа требовала от меня знаний в программировании. Некоторые платформы выглядели хорошо на первый взгляд. Но потом они становились сложными через несколько минут.
Этот опыт заставил меня осознать одну вещь: искусственный интеллект всё ещё кажется сложным для понимания, потому что он запутан. Возможно, поэтому OpenLedger привлёк моё внимание. Дело не в том, что они громче всех говорили. А в том, что они сосредоточены на создании базы для искусственного интеллекта, а не просто на разговоре о том, какой он классный.
Чем больше я изучал проект OpenLedger, тем больше я замечал одну вещь. Большинство людей просто используют продукт искусственного интеллекта. Они видят интеллектуального помощника, инструмент искусственного интеллекта или агента искусственного интеллекта. Почти никто не говорит о системах, которые работают за этими продуктами. Эта скрытая часть заставила OpenLedger казаться мне другим.
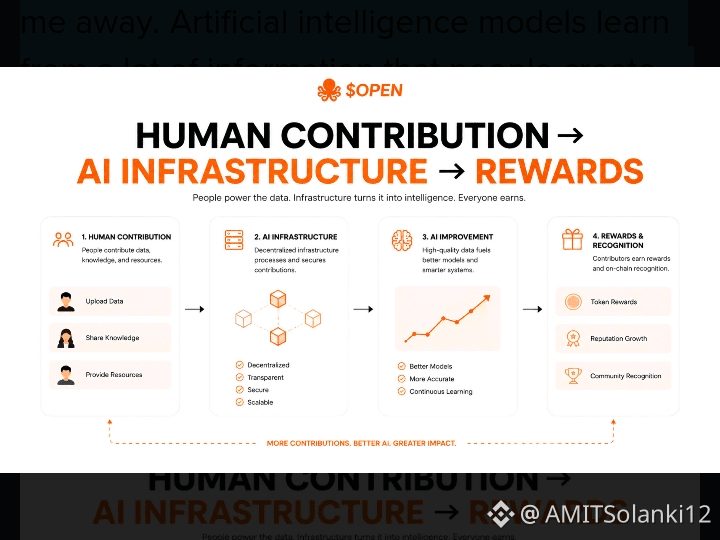
Когда я впервые прочитал о их системе Proof of Attribution, идея сразу показалась мне логичной. Модели искусственного интеллекта учатся на большом количестве информации, которую создают люди. Как только эти модели становятся ценными, люди, создавшие эту информацию, часто оказываются забытыми. Это кажется несправедливым, если задуматься. OpenLedger пытается построить систему, где людей, которые вносят свой вклад, можно отслеживать и вознаграждать за то, что они не забыты.