
OpenLedger и странное чувство, что ИИ, наконец, может столкнуться с той же стеной.
Я уже давно в крипте, чтобы перестать реагировать каждый раз, когда проект утверждает, что он "переписывает" что-то.
В большинстве случаев эти слова — просто переработанная упаковка вокруг тех же старых стимулов. Новый токен, новый брендинг, та же самая реальность: несколько инсайдеров захватывают ценность, толпа предоставляет ликвидность, и в конечном итоге нарратив уходит куда-то ещё.
Наверное, поэтому я стал медленнее реагировать на всё, что связано с ИИ в последнее время. Эта сфера уже кажется переполненной громкими обещаниями. Каждую неделю появляется новый протокол, который утверждает, что он децентрализует интеллект, токенизирует агентов, переосмысляет вычисления или заменяет сам интернет. Со временем всё это сливается в один фоновый шум.
Но время от времени меня что-то цепляет — не потому, что я внезапно начинаю верить, а потому что это кажется сфокусированным на проблеме, которая действительно существует.
OpenLedger — один из таких проектов для меня.
Я не говорю, что это работает. Я не говорю, что это побеждает. Я даже не говорю, что эта модель жизнеспособна. Честно, я пока не знаю.
Но я всё время замечаю, что лежащий в основе вопрос звучит более по-настоящему, чем большинство AI-нарративов, которые сейчас носятся вокруг крипто.
Вопрос простой: если AI-модели становятся одними из самых ценных систем в мире, почему почти никто больше не знает, откуда на самом деле берётся эта ценность?
Поначалу это звучит очевидно, но чем глубже вы об этом думаете, тем страннее начинает выглядеть вся экономика AI.
Большинство современных AI-систем построены на океанах данных, собранных у людей, которые обычно даже не видят компенсации, владения или хотя бы признания. Писатели, художники, исследователи, участники форумов, разработчики, узкие сообщества, случайные интернет-архивы — всё это поглощается моделями, которые в итоге превращаются в продукты стоимостью в миллиарды.
И как-то все просто приняли, что это нормально.
Возможно, потому что системы стали слишком большими, чтобы их можно было оспаривать. Возможно, потому что компании, которые их создают, двигались быстрее, чем регулирование. Возможно, потому что никто не мог реально отследить, кому что приписывается, как только модели достигли определённого масштаба.
Вот эта часть важна.
Годами одной из самых больших проблем в AI была именно атрибуция. Как только модель обучается на достаточно больших массивах данных, прослеживать влияние становится туманно. Всё превращается в чёрный ящик. Иногда полезный, но всё равно чёрный ящик.
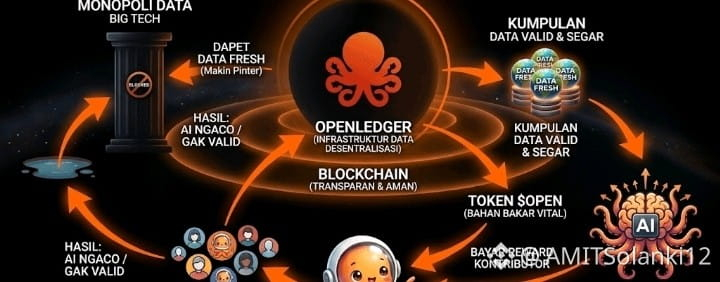
Вот вокруг чего OpenLedger постоянно крутится с этой идеей Proof of Attribution.
Идея звучит почти слишком амбициозно, когда читаешь её в первый раз. Протокол пытается связать выходные данные модели с данными, которые на неё повлияли, а затем вознаграждать вкладчиков пропорционально через сеть.
Я уже видел, как крипто пыталась делать похожие вещи раньше — в разных формах. Роялти за музыку. Экономики создателей. Стимулы хранения. Рынки внимания. Площадки данных.
В конце концов многие из них упирались в ту же стену: осмысленно измерять вклад — это невероятно тяжело.#OpenAIToConfidentiallyFileForIPO $OPEN
#