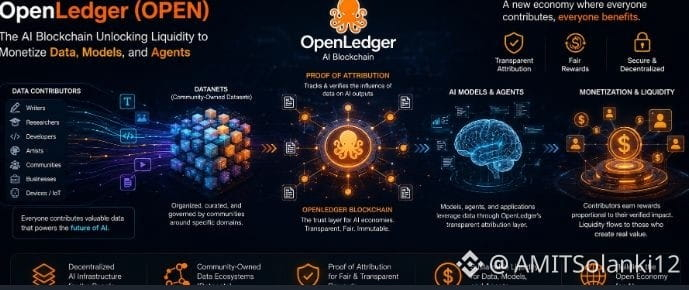
$OPEN
#OpenAIToConfidentiallyFileForIPO OpenLedger и странное ощущение, что ИИ, наконец, может упереться в ту же стену.
Я в крипте достаточно долго, чтобы перестать реагировать каждый раз, когда проект заявляет, что он «переопределяет» что-то.
Чаще всего эти слова — это просто переработанная упаковка вокруг тех же старых стимулов. Новый токен, новый брендинг, та же самая основная реальность: несколько инсайдеров захватывают ценность, толпа предоставляет ликвидность, а в итоге повествование уходит куда-то еще.
Наверное, поэтому я стал медленнее восторгаться чем-либо, связанным с ИИ в последнее время. Пространство уже кажется переполненным чрезмерными обещаниями. Каждую неделю появляется еще один протокол, который утверждает, что он децентрализует интеллект, токенизирует агентов, переосмысляет вычисления или заменяет сам интернет. Со временем все это сливается в один и тот же фоновый шум.
Но время от времени что-то привлекает мое внимание, не потому что я внезапно в это верю, а потому что это кажется сосредоточенным на реальной проблеме.
OpenLedger — один из таких проектов для меня.
Я не говорю, что это работает. Я не говорю, что это выигрывает. Я даже не говорю, что модель устойчива. Честно говоря, я пока не знаю.
Но я продолжаю замечать, что основной вопрос, который он задает, кажется более реальным, чем большинство нарративов ИИ, которые сейчас плавают в крипте.
Вопрос прост: если модели ИИ становятся одними из самых ценных систем в мире, почему почти никто больше не знает, откуда на самом деле берется ценность?
Сначала это звучит очевидно, но чем глубже ты об этом думаешь, тем страннее начинает выглядеть вся экономика ИИ.
Большинство систем ИИ сегодня построены на океанах данных, собранных от людей, которые обычно никогда не видят компенсации, собственности или даже признания. Писатели, художники, исследователи, пользователи форумов, разработчики, нишевые сообщества, случайные интернет-архивы — все это поглощается в модели, которые в конечном итоге становятся продуктами, стоящими миллиарды.
И каким-то образом все просто приняли, что это нормально.
Может быть, потому что системы стали слишком большими, чтобы их ставить под сомнение. Может быть, потому что