

В эпоху взрывного роста искусственного интеллекта (ИИ) вы задумывались над вопросом: кормим ли мы технологическое будущее, которое будет доступно всему человечеству, или же это супермонополия немногих технологических гигантов?
В настоящее время развитие ИИ сильно зависит от трех основных факторов: вычислительной мощности, алгоритмов и данных. Однако качественные данные постепенно становятся собственностью централизованных гигантов, которые возводят высокие стены. Для разработчиков становится все сложнее получать чистые, качественные и соответствующие требованиям данные для тренировки ИИ.
Наша цель — разрушить эту "данные в изоляции" и монопольную стагнацию, и именно для этого появился OpenLedger (открытый реестр). Это не просто технологическая архитектура, а революция в области суверенитета данных и децентрализованного сотрудничества в эпоху ИИ.$OPEN
Что такое OpenLedger?
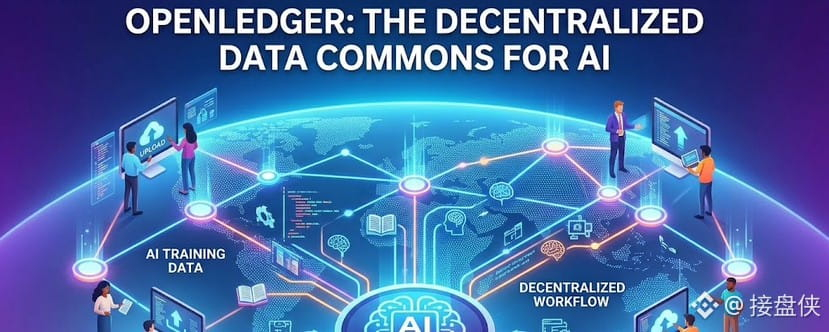
Проще говоря, OpenLedger — это сеть децентрализованного «data commons» (общего информационного ресурса), созданная специально для искусственного интеллекта.#openledger
Он использует неизменяемость данных блокчейна, токен-механизмы стимулов и вычисления с защитой приватности, чтобы создать безопасную, прозрачную и масштабируемую децентрализованную инфраструктуру данных (DePIN). В экосистеме OpenLedger данные больше не являются чьей-то частной собственностью, запертой на серверах гигантов: они становятся цифровыми активами, которые совместно создают вкладчики по всему миру и делят полученную выгоду.#OpenLedger
Его ключевая миссия предельно ясна: запустить потоки высококачественных AI-данных, одновременно гарантируя абсолютное уважение прав поставщиков данных.
Ключевые преимущества: чем OpenLedger меняет AI-экосистему?
Почему OpenLedger так привлекает внимание технологического сообщества и сферы Web3 — потому что он решает ключевые болевые точки в традиционной цепочке поставок AI-данных:
Децентрализованный data pipeline высокого качества: традиционный сбор данных полон шума и низкой эффективности. OpenLedger с помощью децентрализованных рабочих процессов поручает глобальным пользователям и автоматизированным узлам сбор, очистку, разметку и проверку данных. Эта модель «краудсорсинг + AI» позволяет производить высококачественные датасеты, подходящие для обучения больших языковых моделей (LLM), с очень низкой стоимостью и с высокой скоростью.
Абсолютное подтверждение прав на данные и прослеживаемость: в OpenLedger каждый вклад в данные, каждое изменение и каждое использование навсегда фиксируются в бухгалтерской книге блокчейна. Это означает, что каждая ваша запись данных получает цифровой «паспорт». При обучении AI-моделей сразу видно, чьи данные были использованы, что в корне решает споры по авторским правам и вопросам соответствия требованиям.
«Восстановление суверенитета» вкладчиков данных и система стимулов: раньше данные о наших действиях в соцсетях и в интернете бесплатно забирали крупные компании для обучения AI, а мы не получали ни копейки. В OpenLedger «данные — это актив». Пользователи, которые вносят данные, участвуют в их маркировке или запускают узлы верификации, получают стимулы в виде токенов экосистемы. Вы становитесь настоящим владельцем своих данных.
Идеальный баланс приватности и безопасности: благодаря внедрению передовых криптографических технологий, таких как доказательства с нулевым разглашением (ZKP), OpenLedger позволяет обучать AI-модели, не вступая напрямую с исходными персональными данными пользователей. Это открывает дверь для внедрения AI в крайне чувствительных к приватности сферах, таких как медицина и финансы.
Как это работает?
Логику работы экосистемы OpenLedger можно упростить до следующих трех шагов:
Вклад и очистка (Supply): поставщики данных (физические лица или организации) загружают исходные данные, а децентрализованные узлы выполняют очистку и подавление шума.
Проверка и хранение (Validate & Store): узлы-верификаторы оценивают качество данных, убеждаясь, что они реальны и соответствуют требованиям, после чего безопасно распространяют их и сохраняют в децентрализованной сети хранения.
Потребление и обучение (Consume): AI-разработчики и исследовательские организации, оплачивая токены, получают доступ к этим высококачественным наборам данных для обучения и дообучения моделей.
Это идеальная экосистема с замкнутым циклом. Чем богаче данные, тем больше привлекается AI-разработчиков; чем больше разработчиков, тем больше ценности производит экосистема, что, в свою очередь, мотивирует еще больше людей предоставлять качественные данные.
Почему сейчас самое лучшее время обратить внимание на OpenLedger?
В 2026 году AI уходит из «эры универсальных больших моделей» в глубины «вертикальных прикладных отраслей». Универсальные интернет-данные уже почти «съедены» большими моделями. В будущем конкуренция в AI будет строиться на уникальных, высококачественных и соответствующих требованиям профессиональных данных.
OpenLedger как раз попал в волну этого времени. Он не только добавляет Web3 реальные сценарии практического применения, но и предоставляет всей AI-индустрии путь развития, не зависящий от централизованных гигантов: полностью открытый и децентрализованный.@OpenLedger
Будущее AI не должно определяться лишь немногими людьми — его должны совместно формировать вкладчики данных со всего мира. Именно такой новый век AI-самоуправления — прозрачный, справедливый и открытый — строит OpenLedger.