

花儿不在
17 Publicações
花儿不在
Denunciar
Bloquear Utilizador
2 A seguir
5 Seguidores
3 Gostaram
Publicações
·
--
Ver tradução
#opg $OPG
今天必须得唠唠OpenGradient——不是因为它画饼画得圆,是因为币安HODLer空投今天刚上线。我翻了一下午白皮书,发现这项目确实有点东西
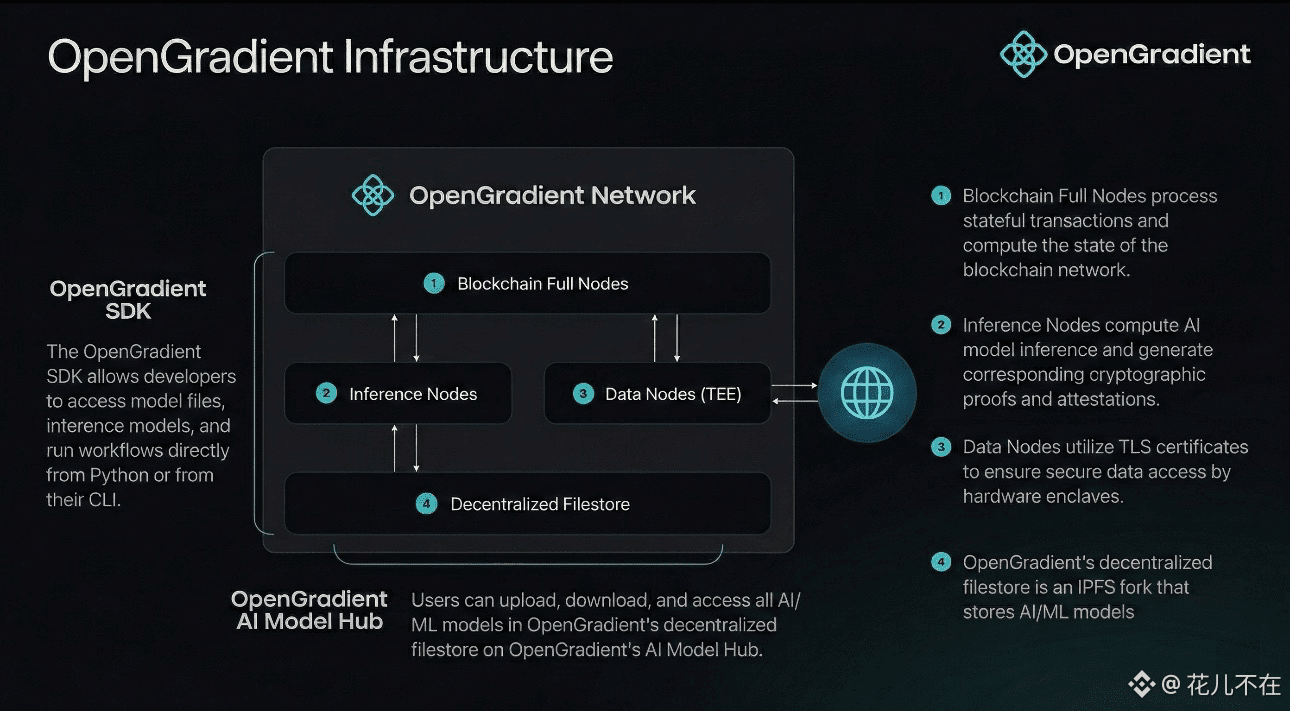
先说技术。如果让链上每个节点都去跑一遍大模型,网络直接瘫痪。OpenGradient白皮书里有句原话特别实在——“让每个验证节点独立重跑模型推理是不切实际的”。所以他们搞了套混合AI计算架构(HACA) ,把“执行”和“验证”彻底分开。推理节点用GPU和TEE跑模型、干重活;全节点只管验证TEE认证和ZKML证明、记个账。你不需要重跑一遍模型,只需要验证它跑对了。验证节点可以很轻量——就这么一个简单的认知转换,把性能和信任全解决了
再说产品。他们家那个Opg Chat,能直接用ChatGPT、Claude、Gemini、Grok这些模型,还能生成图片、传文件。关键是设备端加密——信息在离开浏览器之前就本地加密了,密钥只在你设备上。经过Oblivious HTTP中继时,中继能看到你的IP但只有密文;下游网关能看到明文但永远看不到你的IP。到了TEE隔离网关里才解密处理。而且TEE带远程认证,你可以自己验证这些隐私承诺。这相当于给你配了辆全封闭的超级运钞车——除了你自己,没人知道里面装了啥。Opg Chat上线两周已经服务超200万用户,处理了200多万次可验证推理。Model Hub上还集成了2000多个模型
在算经济账。OPG总量10亿枚,流通约1.98亿枚。a16z crypto领投、Coinbase Ventures、SV Angel、Foresight Ventures等24家机构累计投了950万美元。币安第66期HODLer空投今天刚上线。但我也得说句实在话——空投是机会,可别光盯着糖果忘了脚下的荆棘。当前价格$0.15左右,全流通市值(FDV)超1.5亿美元,80%的代币还没解锁呢。项目还在测试网阶段,技术没大规模验证
我的结论很简单——技术叙事能打,空投机会真实,但80%未解锁的代币是悬在头顶的剑 @OpenGradient
1
127
·
--
Passei a noite consultando a documentação do OpenGradient até 1 da manhã. Quando vi as quatro palavras “validação assíncrona”, pressionei Ctrl+F de forma automática, digitando “validação falhou”.
0 resultados.
Tentei também “failure”, “settlement”, “rollback”. Não havia nada.
O design da HACA, na verdade, é bem inteligente. Blockchains tradicionais fazem com que cada validador reexecute cada transação; a inferência por IA é cara e não determinística, então simplesmente não dá para rodar. A solução do OpenGradient é separar execução e validação: os nós de inferência rodam o modelo, retornando resultados em nível de milissegundos; os nós completos validam assincronamente as provas do TEE. Os nós de validação não precisam saber qual é o prompt ou qual é o modelo; só precisam confirmar que o código não foi adulterado no enclave.
O problema está justamente aqui. A documentação oficial diz claramente que a prova do TEE valida “enclave was not tampered with”, não se o resultado em si está correto. O nó de inferência pode “rodar corretamente” o modelo dentro do TEE e devolver um resultado errado — a prova ainda assim passa. A documentação admite uma “lacuna temporária de confiança”, mas não diz como essa lacuna é preenchida. Não há uma única palavra sobre isso. $OPG
A Gate Academy tem um artigo que menciona “validação falhou, o resultado será rejeitado ou recalculado”. Quem paga o dinheiro do recalculo? Como reverter as transações já executadas? A documentação oficial nem deixa um TODO
Dê uma olhada no DeFi: quando a validação falha, há liquidação e apreensão como garantia; no caso de um Optimistic Rollup, existe o período de desafio e provas de fraude. O OpenGradient vende “primeiro sai o resultado, depois valida” como argumento — e pelo que parece, quem vai lidar com o desastre é o próprio usuário. #OPG
A direção da arquitetura está certa. Mas antes que o modelo econômico da mainnet seja publicado por completo e o mecanismo de tratamento de falha de validação seja descrito na documentação, eu preciso deixar essa conta bem fechada. @OpenGradient
1
78
·
--
Ver tradução
别猜大模型有没有在后台给你换蒸馏版了,这事我踩过坑。调了两周的prompt,上线后结果忽高忽低,平台拍胸脯说版本一致,你连自证清白的手段都没有。
OpenGradient破局的手法不玩虚的,直接把推理关进CPU的TEE安全区里跑。这铁笼子狠在哪?算力跑起来那一刻,连云厂商的root管理员都扒不开数据帘子,输入输出全程物理级隔离。但这只解决了一半问题——你怎么保证跑的是GPT-4而不是GPT-3.5?它把模型权重哈希提前写死在链上Registry里,推理完硬件吐个签名凭证,两边对不上暗号直接作废。执行归执行,审计归审计,双人互检,缺一个就翻车。$OPG
OPG在这闭环里就是个“计价器”。每次调用走x402协议自动划扣,开发者接个Python SDK就不用管后头签名校验那些破事,只管写业务。OPG不值钱才怪,网络今天处理10万次推理它就流转10万次费用,处理100万次它就硬通货翻倍——这估值逻辑比画PPT的MEME币硬核多了#OPG
对比下市面:中心化API纯靠信任,zkML验证一步等三秒,商用直接劝退。OpenGradient选了个折中路线,牺牲点极致去中心化,换毫秒级可验证。别跟我扯什么去中心化AI的理想,当这玩意真开始替人批贷款、管私募的时候,“可验证”不是加分项,是叩门砖。谁先把硬件级的清白证明攥手里,谁就卡住下一代金融AI的脖子。吹概念的,靠边站。
@OpenGradient
82
·
--
Ver tradução
99%的人把质押当存钱罐,但@OpenGradient 白皮书第4.3节有一行被划过去的“魔鬼细节”——错误证明罚没(Slash)。读到这里我后背发凉:质押根本不是生息工具,而是AI推理的“信用保险金”。
验证者质押OPG,不是在挖矿,是在给网络写“欠条”:我对这次验证负责,错了,真金白银赔。OpenGradient每一次AI推理返回结果,背后都有人在用资产担保它的准确性。
对比传统AI就扎心了。 OpenAI、Claude、Gemini,全建立在“无成本证词”之上——模型没篡改?硬件没问题?全靠口头承诺。OpenGradient把道德约束换成了经济约束,把“我相信你”变成了“你不敢骗我,因为骗我有成本”。
这引出一个多数人没算过的供应侧推论:
质押中的OPG退出需要解绑期,Slash风险悬顶时,轻率退出的机会成本比留着更高。所以链上那批OPG,不是因为持有人看好,是因为被机制焊死在那里——被动锁仓和主动持有,是两码事。
如果Slash真实运行,OPG的供需模型将彻底重构:网络越繁荣→验证者需求越多→被责任锁死的筹码比例越高→自由流通盘越稀缺。这是一个非线性的通缩斜率。
当然,风险也摆在那: 验证者节点是否真实增长?Slash是否真实发生?这两组数据目前还是黑盒。但市场往往在“看不清”的时候定价最狠。
当别人还在卷TEE和ZKML技术名词时,聪明钱已经开始计算罚没机制带来的天然买盘压力。质押量决定网络的安全上限,而安全上限决定估值天花板——这个叙事,比单纯的AI Meme硬核十倍。
方向对了,数据会说话。静待验证者地址公开的那天。$OPG #opg @OpenGradient
1
94
·
--
Ver tradução
#opg $OPG 周末在咖啡店被店员安利“隐藏菜单”,满怀期待点了一杯——不过是普通拿铁加了焦糖糖浆。这让我想起币圈那些号称“AI革新”的项目,大多只是给大模型套了个发币的壳。但深度体验@OpenGradient后,确实让我改观不少。
它的HACA混合AI计算架构打破了我对“区块链+AI=慢”的刻板印象。 传统区块链靠每个验证节点重复执行每笔交易达成共识,跑大模型在计算上完全不可行。HACA将网络拆分为三个专业角色:推理节点跑模型并生成可验证证明,全节点只验证证明的密码学有效性,数据节点获取可信外部输入。用户先拿结果,验证和结算异步完成——既保住Web2级速度,又锁死链上信任。
更让我觉得“真不一样”的是它的隐私设计。 OpenGradient Chat处理敏感信息时,消息在浏览器端就完成加密,密钥只存在你的设备上;通过Oblivious HTTP匿名中继后,在TEE可信环境中解密处理——运营方既看不到你是谁,也读不懂内容。对比ChatGPT们拿对话喂模型的套路,这才是真正的“架构级隐私”。
数据印证落地速度:4月上线Base以来,已托管超2000个模型、验证超50万份证明、处理超200万次推理。但我心里始终有个结:AI的“黑盒幻觉”与区块链的“透明契约”天生冲突。若模型推理出错,链上自动决策的风险谁来担?目前我只拿小仓位参与观望,既不盲目押注,也不愿错过。
当AI既能极速服务又能锁死隐私,它会是巨头的劲敌,还是一场技术豪赌?且看它下一步怎么解题@OpenGradient
88
·
--
Ver tradução
#opg $OPG 异步结算的代价@OpenGradient OpenGradient x402机制下被转嫁的节点资金效率风险
Opg的x402支付协议常被包装为“Web2级低延迟”体验,但其核心机制暗含结构性缺陷:异步结算模式将资金效率与价格波动风险完全转嫁给算力节点,在商用批量推理场景下存在先天不适配
机制拆解:预授权≠即时结算 用户发起推理前通过Permit2完成链上预授权,批准OPG额度给结算合约;节点消耗GPU算力返回结果后,OPG代币的正式扣款与划转才在Base链上异步完成。执行与结算在时空上被彻底剥离——节点“先干活”资金“后到账”
对比基准:前置扣款vs后置结算的范式冲突。AWS、GCP等主流云平台均执行“资金到位,算力启动”,或预冻结余额,或实时扣费;去中心化竞品也多采用“预付充值、按秒扣费、余额耗尽即停机”的硬约束。x402的Permit2预授权仅解决“防用户跑单”,却回避了“钱在路上”的账期与汇损问题,本质是将流动性杠杆强行加给硬件提供者
量化视角:三重压力下的收益侵蚀。 面向B端批量推理时:Base链结算拥堵致资金到账窗口延长至12-15个区块(约3-5分钟)此窗口内OPG价格波动带来0.5%-2%的隐性滑点;月均10万次推理的中型节点,未到账资金日均沉淀约5000枚OPG,折算链上借贷成本,每月侵蚀4%以上净利润。GPU电费与折旧是刚性支出,收入却存在不确定延迟,节点现金流安全边际被持续压缩
破局推演:协议层必须补齐的“解药”。 若要保持算力供给稳定,x402须引入动态汇率锚定机制(如按5分钟TWAP均价结算),或设立节点流动性预支池对冲账期风险。否则,Web2级的响应速度与Web3级的结算摩擦之间,终将形成算力供给失血的“成本无底洞”。先服务、后结算,看似保障用户体验,实则将财务风险全额转嫁——这套经济设计的长期可持续性,值得每个算力提供者审慎重估
1
1
80
·
--
#opg $OPG
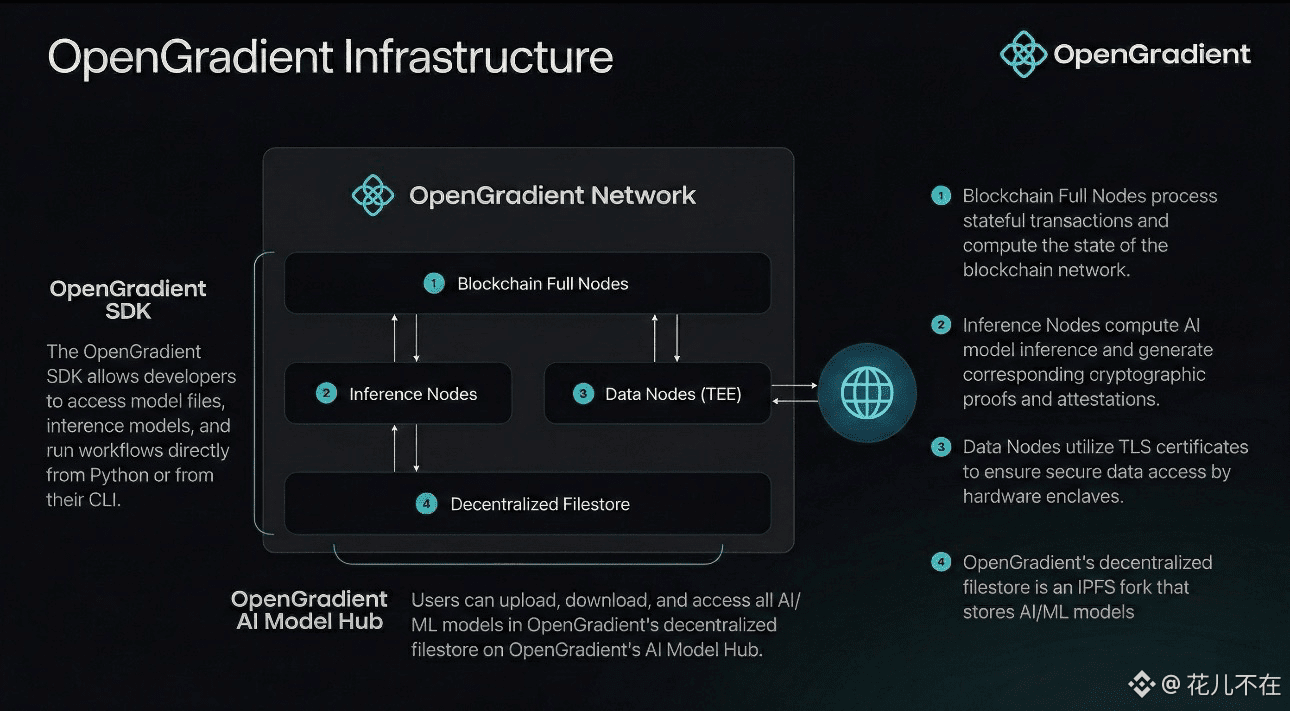
Hoje não vou puxar papo furado. Aquele troço do OpenGradient, eu só entendi direito recentemente. Antes, quando eu via termos como “nós completos” e “provas de conhecimento zero”, minha cabeça ficava zumbindo, parecia longe demais da nossa realidade. Mas se você tiver paciência e olhar como funciona por baixo, é simples: basicamente um bando de contadores muito meticulosos serve como porteiro pra você. Em qualquer máquina na rede, rodando um modelo de IA — seja para inferência ou para treinamento — assim que sai o resultado, você tem que entregar o “livro-caixa” pra esse pessoal dos nós completos. Eles têm na mão fórmulas de criptografia e relatórios de hardware TEE; conferem ponto por ponto com você. Não bate? Aí é alto e bom som, broadcast pra rede inteira: o “esquema” de fraude que você tentou fica escancarado. E além disso, eles ainda se chamam entre si pra fazer reconciliação, com medo de deixar escapar qualquer detalhe. As grandes empresas tradicionais, quando dá errado com os dados, no máximo mandam uma carta de desculpas e te deixam continuar acreditando na “boa índole” deles. E aqui? Índole não serve; a matemática diz que não está em conformidade, você chora pra quem for — nó completo não carimba. Não rola.
Você provavelmente vai perguntar: e se os próprios nós completos fizerem sacanagem? Eles não são bobos. Eles têm que colocar garantia, travar uma grande quantia de tokens OPG pra poder operar. O sistema fica monitorando o tempo todo. Quem ousar se aproveitar do cargo ou agir com preguiça — se for descoberto, perde os seus “chips”, dói até na carne. Por outro lado, quando verificam as contas com mais frequência e pegam a fraude, o sistema recompensa com OPG: preço na etiqueta, sem rodeio. Quem vai querer ficar contra o dinheiro? A sacada desse esquema é genial: joga fora todo aquele jogo de relações humanas e faz com que benefício e matemática se encaixem. O usuário comum nem precisa gastar dezenas de milhares de reais pra configurar uma máquina top como nó. Você só faz a chamada na interface e, lá embaixo, esses teimosos ficam segurando tudo. Tranquilo de verdade. Eu já testei algumas vezes: não precisa implorar como quem pede a bênção do “vovô”; chama direto e o resultado vem certinho.
No futuro, quando a IA lidar com dados sensíveis, contar com esse grupo que fica preso aos detalhes pra dar cobertura é mais firme do que qualquer CEO prometendo com peito estufado. Carimbar com matemática substitui compromisso falado. E como esses nós querem ganhar OPG, eles verificam com muito mais rigor do que qualquer outro. Você quer “dar um jeitinho”? Nem pensar. Eu gosto desse jeito limpo e direto: não preciso ver cara de ninguém; é só algoritmo e hardware, exigindo rigor. Você tem que admitir: isso é muito melhor do que aqueles projetos que vivem gritando “transparência”, mas não dá pra ver nada de verdade. De qualquer forma, eu vou usar IA daqui pra frente e vou ficar de olho exatamente nessa camada de baixo — fico tranquilo por dentro. @OpenGradient
67
·
--
Ver tradução
#opg $OPG 你有没有想过,每次调用一个AI风控模型,真正危险的其实不是它“读”你的输入,而是它去后台取数据的那一瞬间?
我做过系统运维,见过太多日志里明晃晃地躺着用户ID、账户余额、最近几笔交易的触发原因。排查问题嘛,免不了翻请求参数和返回结果,可翻着翻着,一些不该看的东西就进了眼。这不是谁坏,是架构本身就没把“取数”当回事——应用服务器一手握着接口权限,一手把数据喂给模型,中间所有痕迹全留在普通日志里。外部数据源越多,这摊水就越浑,运维人员不知不觉就成了隐私的隐形观察者。
OpenGradient 的 Data Nodes 切的就是这个入口。它不是简单加个代理,而是把“拉数据”这个动作单独拎出来,塞进一个隔离的执行环境里。任务只告诉它“去查什么”和“按什么规则查”,真正的读取在 TEE 里头完成——那个环境连主机操作系统都插不进手,节点运营者想翻日志?翻到的全是乱码
但这还不够。我最在意的是它怎么证明自己没换料。Data Node 返回数据时,会附带一份远程认证凭据,相当于一个加密的“收货单”,写着:这份数据是某时某刻在指定环境里按指定条件取的。后面的推理节点拿着数据干活,验证节点只检查这张单子真不真。想偷换数据?单子对不上,全链驳回。验证的人自始至终不用看明文,这才是闭环
这套东西解决了一个很实在的困局:实时数据用越多,造假空间就越大;权限越集中,信任就越脆弱。以前我们靠“相信运维不会偷看”,现在把信任替换成可验证的流程——取数有隔离,结果有证明,追责有依据。隐私不再是一句承诺,而是被拆进架构里的硬条件。就这么简单@OpenGradient
81
·
--
#opg $OPG Na última vez, pedi para a IA calcular o rendimento do meu DCA, e o resultado foi que ela inflacionou a taxa anual em dobro. Quase fiquei empolgado e joguei tudo. Depois me toquei que essa coisa é um mistério, não tinha onde consultar, parecia uma caixa-preta. Por isso, quando vi que a OpenGradient ia abrir o jogo e trazer transparência, eu, que já fui enganado, fui o primeiro a aplaudir.
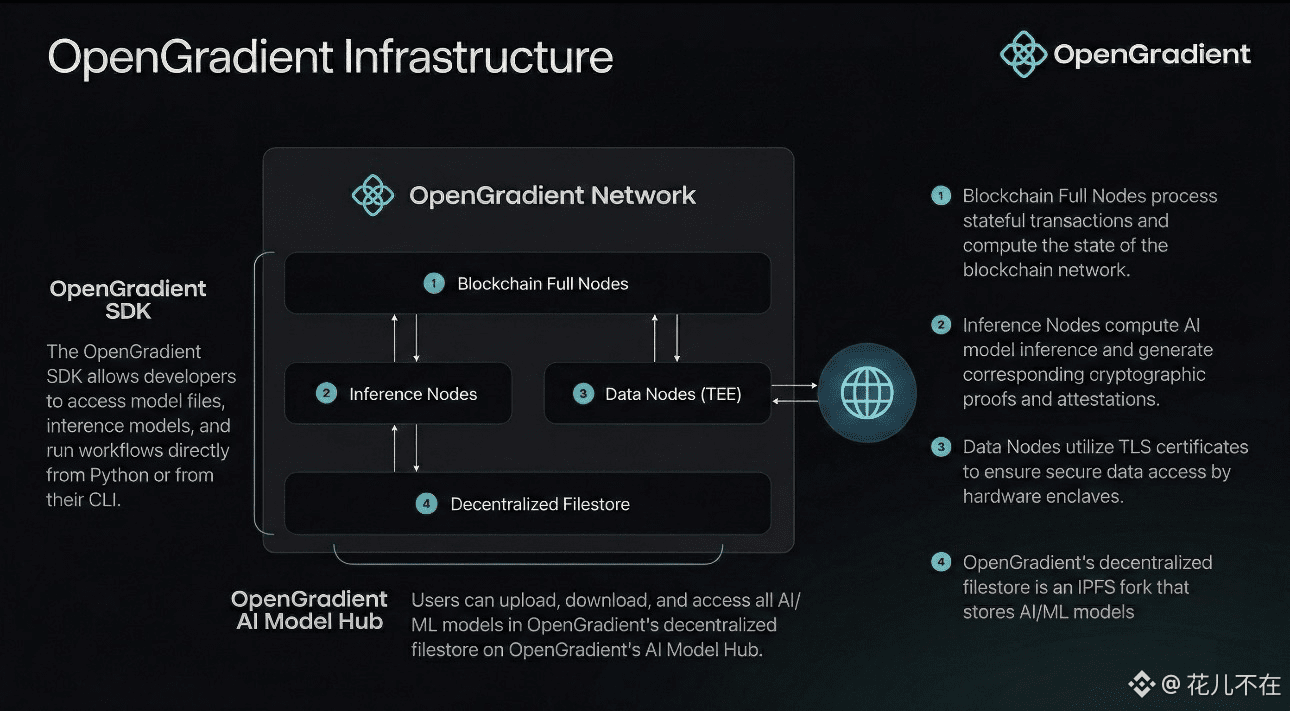
Eles são diferentes dessas grandes empresas que só sabem enrolar com parâmetros e vídeos realistas. O foco deles é fazer uma coisa: transformar o processo de inferência da IA em um "livro-razão público" que todo mundo pode verificar. Como eles fazem isso? Precisamos desmontar a arquitetura de cálculo de IA híbrida (HACA). Resumindo em quatro palavras: execução e verificação separadas.
Antes, tentar colocar a IA na blockchain era um nó górdio — fazer 100 nós recalcular o grande modelo, o custo era exorbitante e, além disso, o grande modelo tinha um "coeficiente de temperatura" e cada resposta era diferente, tornando impossível chegar a um consenso. A HACA trocou a abordagem: os nós de inferência executam o modelo rapidamente para obter resultados (caminho rápido), enquanto geram assinaturas criptográficas de forma assíncrona (caminho lento), usando ambientes confiáveis TEE ou provas de conhecimento zero ZKML. Os nós na blockchain não recalculam o modelo, apenas levam alguns milissegundos para validar se a prova é válida, usando o consenso CometBFT para decidir na blockchain, ninguém pode adulterar. Com essa combinação, já temos mais de 4400 modelos hospedados na blockchain, foram mais de 2 milhões de inferências verificáveis produzindo mais de 500 mil provas, tudo baseado em dados reais na blockchain.
E o combustível que faz essa "monitorização transparente" funcionar é o token OPG. Nós, os investidores de varejo, usamos OPG para acionar as inferências, enquanto os nós ganham taxas de serviço; para se tornar um nó, é preciso primeiro stakar OPG para entrar, e se alguém tentar manipular os dados, a garantia é confiscada. Esse modelo de "pagar para trabalhar, e se fizer errado, perde grana" transforma o "não fazer o mal" em uma conta econômica, muito mais confiável do que esperar que as grandes empresas tenham consciência.
Daqui para frente, quando usar IA, vou me certificar de que seja algo com monitoramento transparente. Máquinas inteligentes, mas com segundas intenções, eu, como novo investidor, não consigo lidar. @OpenGradient
99
·
--
#opg $OPG O whitepaper da OpenGradient, olhando de novo e de novo, o x402 settlement layer é o verdadeiro ponto crítico. Essa coisa faz o trabalho de levar a inferência de IA para a cadeia, e o $OPG é usado para pagar Gas e fazer staking. Mas o ponto principal não é a tecnologia; é que ele joga três opções para os desenvolvedores — PRIVATE, BATCH_HASHED, INDIVIDUAL_FULL — que parecem atenciosas, mas na verdade colocam uma bomba de conformidade na sua mão, com o momento da explosão definido por você.
PRIVATE: não deixa rastros on-chain. A privacidade fica preservada, mas a placa de “IA verificável” quebra em pedaços. Se o regulador vier auditar, como você prova que o Agent não trapaceou? Com o ar?
INDIVIDUAL_FULL: logs completos permanentemente on-chain. O whitepaper diz que é adequado para “DeFi Agents publicamente auditáveis”; em linguagem simples: limite de empréstimo do usuário, limiar de liquidação, raciocínio da estratégia — tudo nu e exposto. Basta o concorrente vasculhar a cadeia para mirar seu posicionamento com precisão, mais gostoso que insider trading.
BATCH_HASHED: agregação por Merkle, opção padrão. Custo baixo, verificação viável, privacidade mais ou menos — mas é um compromisso que não resolve nada. O regulador diz “entregue os logs brutos”, e você apresenta um hash; será que o juiz aceita?
Vou contar uma história real: suponha que você rode um Agent de lending e escolha o modo FULL; o processo de inferência de um usuário perguntando “quanto posso pegar emprestado no máximo” vai todo para a cadeia. O adversário, com isso, calcula sua exposição ao risco e dispara a liquidação antes de você. Você perde dinheiro de verdade, e o usuário te processa por vazamento de privacidade. E a OpenGradient já teria lavado as mãos do problema — no SDK, um parâmetro settlement_mode, o desenvolvedor marca sozinho; se der ruim, não vá atrás do time do projeto.
Minha estratégia prática, sem firula: nos três primeiros meses após o mainnet ir ao ar, só rodar negócios não centrais, forçando BATCH_HASHED. Ao mesmo tempo, acompanhar dois indicadores — a frequência de pedidos de auditoria on-chain e o volume de reclamações/disputas em cada modo. No fim do terceiro mês, ver qual modo teve a menor taxa de incidentes e a menor fricção regulatória, e então decidir quanto da lógica de negócio migrar para lá. Até lá, toda a inferência crítica é feita localmente; apenas o hash de verificação vai para a cadeia.
Lembre-se: nos registros de inferência de IA on-chain, não é quanto mais se guarda que é mais seguro, e sim guardar exatamente o suficiente para se autojustificar e, ao mesmo tempo, não violar regras. Ninguém vai traçar essa linha por você; você precisa testá-la com sua própria posição. Mas, antes de testar, delimite bem a linha de sobrevivência — se você ainda não entendeu para onde os dados vão, não jogue sua carta final toda de uma vez@OpenGradient
2
91
·
--
#opg $OPG
Fale sobre o OpenGradient, vamos parar de inventar aquelas histórias cheias de firulas; vamos olhar direto para a arquitetura HACA dele.
Qual é o problema das blockchains tradicionais? Cada nó precisa reenviar e executar as transações de novo. Você transfere sem problemas, mas pedir para 100 nós rodarem, cada um, um modelo grande de 70B? O custo vira 100 vezes, o tempo não dá, e o resultado ainda não é necessariamente diferente. A jogada do OpenGradient é separar execução e verificação — nós de inferência fazem o trabalho pesado com GPU; depois, enviam uma certificação TEE ou uma prova ZKML. Assim, os nós completos só validam a prova, sem ficar reexecutando o modelo de forma “burra”.
Sinceramente, a ideia não tem nada de errado tecnicamente. Os nós se dividem em quatro grupos: nós de inferência rodam o modelo; nós completos registram e verificam as provas; nós de dados alimentam informações externas; e o armazenamento vai para o Walrus. Mas onde está a pegadinha? Os nós TEE precisam de registro com autenticação de hardware — isso não roda em qualquer computador caseiro. Quem compra H100? Quem paga a conta de energia do data center?
Eu dei uma olhada bem de perto no modelo econômico do whitepaper. A oferta total de tokens é de 1 bilhão; o incentivo de staking só corresponde a 10%, liberado linearmente ao longo de 96 meses. 96 meses é o quê? Oito anos. Com a avaliação atual do OPG, a quantidade média liberada por mês, será que dá para pagar a conta de ar-condicionado de algumas máquinas? Operar nós não é fazer caridade. Se o subsídio acabar, a capacidade de processamento vai correr mais rápido do que qualquer um.
O time diz que, após o lançamento na mainnet, foram feitos 2 milhões de inferências. Mas quantos nós de inferência existem de fato e quais configurações eles têm, até hoje não foi divulgado. A narrativa técnica é sensual; mas a conta econômica consegue fechar, ou não? Eu, pelo menos, já salvei a lista de nós nos favoritos e volto para conferir daqui a três meses. Agora entrar na correria? Eu ainda vou olhar para @OpenGradient
1
94
·
--
Ver tradução
#opg $OPG 测了四天OpenGradient Chat,前后七八十条对话,从简单问答到多轮逻辑推理都试了,说点实操感受。
第一反应是快。晚上十一点和下午两三点都测过,高峰期也没明显卡顿,问完基本两秒内开始出字。翻白皮书第二章,他们把推理和验证拆成两条路径——GPU节点只管跑模型,结果单独走加密验证。这个设计实际体验中能感受到区别,不像有些项目,推理快了验证跟不上,或者验证做全了响应就拖垮。
但也有翻车。第三天晚上一条合约安全问题,推理很快,三秒出结果,但验证卡了快十秒,状态一直pending,差点以为断线。后来查链上记录,是某个验证节点出块慢了。白皮书不会写这种细节,但实际跑起来就是会遇到,这才是真实的链上AI。
再说节点分布。我找了两个跑过OPG节点的人聊,他们算了一笔账——目前OPG价格下,电费和机器折旧算进去,回本周期比官方说的长将近一倍。其中一个原话:“除非币价翻倍,不然扩机器就是赌。”目前全网推理节点就那么些,头部几个集中了大部分算力,这让我有点犹豫。
我的判断:拿它当中心化AI工具用,体验过关,甚至算好用。但链上验证那部分,暂时不会放大资金。等节点分散度从目前头部集中降到60%以下,再重新评估。OpenGradient的下限是验证路径在极端情况下会卡,上限看节点激励能否持续。用着爽和投着稳是两码事,我现在就盯着节点分布图看
@OpenGradient
102
·
--
Verificado
Ver tradução
#opg OPG代币到底值不值得拿?说点实在的
先说结论:OPG不是那种让你无脑冲的币,但它的价值逻辑比大多数AI项目要硬。
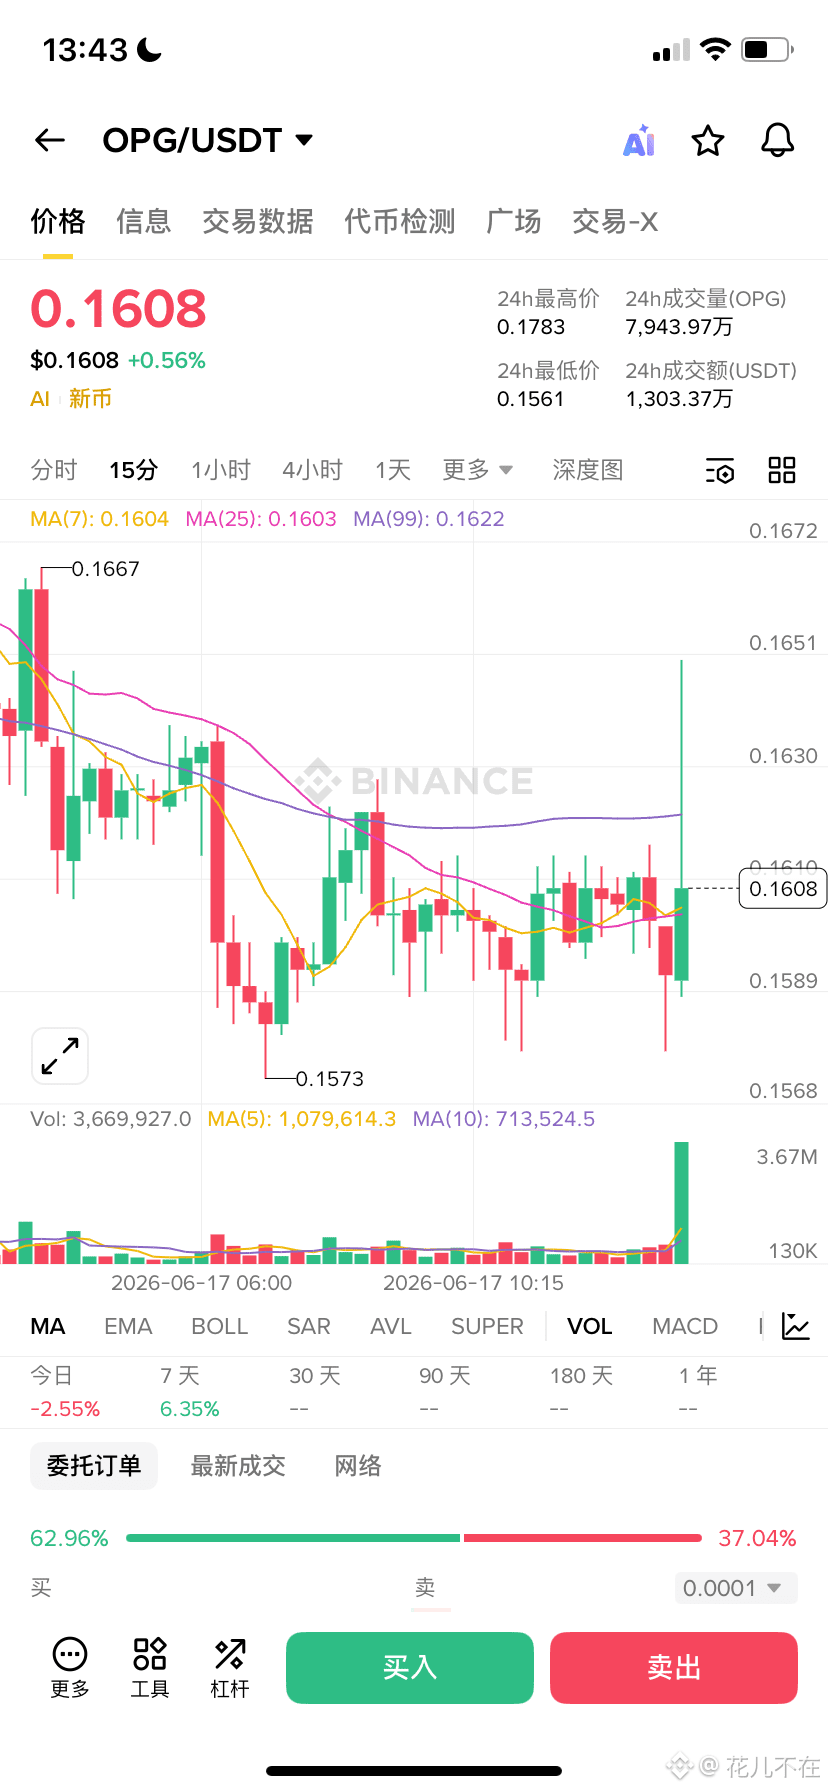
很多人一上来就问价格,我告诉你,6月16号OPG是0.1618美元,市值3000万出头。但这都不重要。你得先搞清楚一件事——这个代币到底有没有人用?
需求是真的还是假的?
OpenGradient现在跑了200多万次可验证AI推理,托了2000多个模型在上面。每次推理调用都要烧OPG。这不是那种项目方自己刷的数据,是可验证的链上记录。
币安5月22号上了现货,韩国Upbit也跟进。说白了大交易所愿意接,说明尽调过了,不是空气。
代币分配里有玄机
总量10亿,现在流通不到1.9亿,19%左右。乍一看有解锁压力对不对?但你仔细看:生态40%要60个月慢慢放,贡献者和投资者那25%都锁12个月才开始放,一放就是36个月。这意味着什么?大仓位被摁住了,短期内不会砸盘。
四层价值捕获
OPG不是治理币那种虚头巴脑的东西。它是支付工具,你调AI模型就得花OPG;节点要干活得先质押OPG,搞鬼了直接罚没;开发者上传模型也能赚OPG。四层需求叠在一起,比那种只会投票的空气币强太多了。
风险也得说清楚
TEE依赖AWS,这是个中心化风险。项目方自己也清楚,但没办法,短期没有比Nitro更好的选择。另外ZKML那套对LLM成本太高,大部分场景还是靠TEE顶着。
最后说句实在话$OPG
这个赛道真正的考验是:当可验证AI推理成为刚需,OPG的消耗速度能不能跑赢代币解锁。现在盘子小,波动大,自己掂量着来。@OpenGradient
1
1
439
·
--
Ver tradução
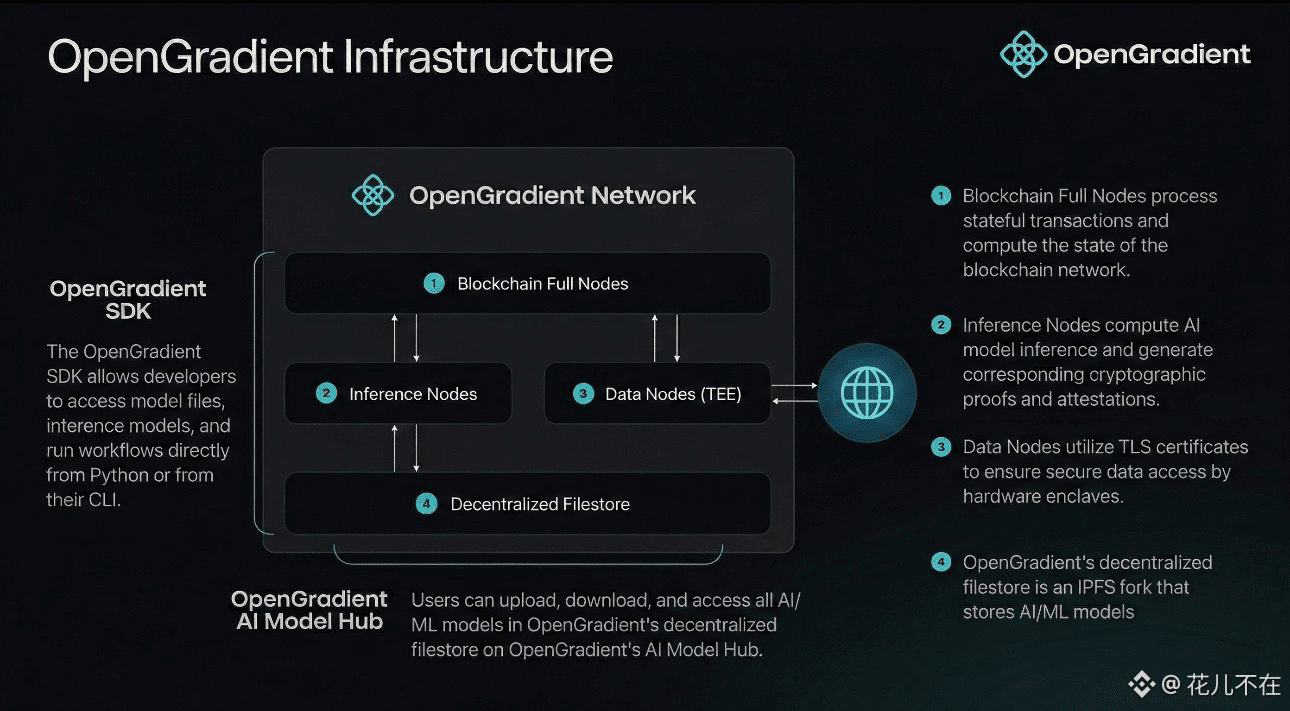
#opg $OPG 先说一个反直觉的判断:OpenGradient要解决的不是“AI不够强”,而是“AI不可信”。LLM输出的投资建议或交易信号,用户无法独立验证计算过程是否被篡改。白皮书的核心思路就是把这个过程变成“可审计的计算”。
一、HACA:执行与验证解耦
传统区块链要求每个验证节点重新执行每笔交易,这对AI推理不现实。OpenGradient的HACA架构把网络拆成三层:推理节点(GPU+TEE执行模型,返回结果,区块链不在关键路径上)、全节点(验证TEE/ZKML证明,同时用CometBFT共识维护账本)、数据节点(TEE内安全获取外部数据)。验证节点不跑模型,只检查证明——这是性能优化的核心。
二、验证框架:信任等级菜单
白皮书设计了三种验证路径:TEE(AWS Nitro Enclaves,认证文档证明环境未被篡改,覆盖LLM和大部分ML场景)、ZKML(零知识证明,数学级别确定性,但成本高,仅用于高风险ML推理)、Vanilla(无证明,低要求场景)。x402支付协议已嵌入每个TEE实例,消除中心化中间件,支持异步结算,预充值后推理请求不被链上阻塞。
三、代币与现状
OPG总供应量10亿枚,2026年4月TGE于Base链,当前流通约19%。代币用于支付推理费、质押罚没、治理投票。生态、贡献者、投资者份额均有长期锁仓(12个月cliff+36个月线性释放),短期抛压受控。网络目前处于测试网阶段,已处理200万+可验证推理,托管2000+模型,生成50万+证明。
值得观察的风险:TEE依赖AWS Nitro,去中心化存在集中化张力;ZKML对LLM尚不现实,验证的“成本-安全”权衡由开发者承担;未来两年供给释放持续,需网络收入增长匹配。
当“可验证”成为AI输出的默认要求,OpenGradient的架构取舍才有真正的护城河。
#OPG $OPG @OpenGradient
113
·
--
#opg $OPG Vamos falar do que realmente importa. Muita gente está de olho no preço do token OPG, mas não entendeu o que a estrutura HACA está realmente resolvendo.
As blockchains tradicionais não conseguem lidar com a IA, e a razão é bem simples. O esquema do Ethereum faz com que cada nó de validação execute a mesma transação novamente, e se o resultado for consistente, eles chegam a um consenso. Transferências não são problema, mas e a inferência em IA? Executar um modelo de 700 bilhões de parâmetros requer GPU, tempo, e a cada execução a saída é diferente. Fazer 100 nós de validação executarem isso? O custo multiplica por 100, e o tempo vai a zero.
Alguns enxergam a IA como um "oráculo" e alimentam dados, o que na verdade transfere a confiança do fornecedor de IA para o fornecedor do oráculo, é a mesma coisa com um nome diferente.
A ideia do OpenGradient é simples: dividir. O núcleo da HACA: separa execução e validação. Três tipos de nós, cada um fazendo sua parte:
· Nós de inferência — GPU rodando modelos, resultados entregues diretamente ao usuário, com latência comparável ao ChatGPT.
· Nós completos — não rodam modelos, apenas validam a prova criptográfica enviada pelos nós de inferência (TEE ou ZKML). Se a validação for aprovada, registra na blockchain, sem precisar saber quais são as palavras-chave, modelo ou resultado, apenas operações criptográficas.
· Nós de dados — especializados em capturar dados externos, operando dentro do TEE, garantindo que os dados não tenham sido manipulados.
Qual é a sacada desse design? A inferência segue o "caminho rápido" — você faz o pedido, a GPU calcula, e o resultado volta para você em segundos, sem a blockchain interferindo. A validação segue o "caminho lento" — provas submetidas de forma assíncrona, validação pelos nós completos e registro na blockchain. A velocidade é nível Web2, a confiança é nível Web3. Quanto mais nós de inferência, maior a capacidade de processamento, enquanto a pressão na camada de validação não aumenta — a validação da prova ocorre em milissegundos, independentemente de você ter rodado o modelo em 5 segundos ou 50.
Falando em português claro: você recebe os resultados tão rápido quanto com o ChatGPT, mas cada resultado pode ser validado de forma independente e rastreável permanentemente — sem precisar confiar em ninguém.
Atualmente, a mainnet já executou mais de 2 milhões de inferências verificáveis, mais de 500 mil provas e mais de 2000 modelos. a16z e Coinbase Ventures já estão a bordo. Esse mecanismo desmonta a "IA caixa-preta" em uma "linha de produção transparente", a direção está certa, agora resta saber se o ecossistema consegue decolar @OpenGradient
95
·
--
#bedrock $BR No atual círculo, a promoção da liquidez total da Bedrock está em toda parte, com a airdrop e altos retornos constantemente estimulando o mercado. Muitos traders de varejo estão seguindo a onda, fazendo empréstimos para aumentar a interação, tentando lucrar com as recompensas. Após uma experiência prática de meio mês, saí do pacote publicitário e vou compartilhar a verdadeira face do projeto sob a perspectiva de um investidor comum.
A estrutura de rendimento cross-chain baseada na uniBTC é o principal destaque do projeto. Antigamente, para que os ativos BTC pudessem ser geridos em múltiplos ecossistemas, era necessário realizar várias transferências entre pontes, o que não só consumia tempo, mas também acumulava várias taxas de rede. Agora, com a plataforma, você pode gerar um certificado de liquidez com um único staking, permitindo que os ativos transitem flexivelmente entre os principais protocolos de rendimento, com uma eficiência de rotação de capital que supera em muito os produtos de staking tradicionais no mercado, sendo a arquitetura muito amigável para grandes volumes de capital.
Entretanto, para simplificar a operação, o projeto encapsulou internamente toda a gestão de nós subjacentes, controle de risco de ativos e regras de agregação de fundos. Os usuários só conseguem ver os rendimentos em tempo real na interface, sem a possibilidade de consultar os detalhes do custódia dos ativos subjacentes. Para os veteranos que valorizam a transparência na blockchain, isso é um risco difícil de ignorar.
Atualmente, muitos traders de varejo estão se movendo em ciclos de staking com volumes de centenas de U, onde todo o modelo econômico tende a favorecer as baleias. As taxas de Gas e slippage das operações frequentes com pequenos volumes vão lentamente consumir as escassas recompensas do ecossistema, e a maioria dos participantes acaba não conseguindo lucrar, mas acaba elevando indiretamente o TVL do projeto.
Aconselho a manter a calma, abandonar a ideia de enriquecer rapidamente com airdrops, e tratar o projeto apenas como uma ferramenta de liquidez. Use os certificados obtidos com o staking para uma alocação sólida com DeFi estabelecidos, considerando airdrops como um bônus extra. Assim que o frisson do mercado diminuir, observe a real retenção de capital do ecossistema antes de planejar investimentos futuros.
#Bedrock #btcfire @Bedrock
65
·
--
Ver tradução
#bedrock $BR 个月社群里晒BR积分的人越来越多,有个朋友甚至把榜单前10截图当头像,逢人就说"这才是BTCFi的真本事"。说实话我当时差点笑出声——在DeFi基建圈摸爬六年,从MakerDAO到现在的再质押赛道,这种把"资金门槛"包装成"用户激励"的戏码,我看了不下十遍。
说白了,Bedrock能在BTCFi赛道异军突起,靠的从来不是单纯让BTC跨链那么简单。你发现没有,它真正的护城河,是那套看似公平的非线性积分衰减模型。项目方聪明得很,不搞明面上的"资金量不足者勿扰",而是用积分公式悄悄完成资本分级:同样质押1个BTC,大户锁仓一年的积分产出,能顶散户频繁进出三个月的总和。两种资金,两套贴现体系,中间隔着一道永远跨不过的收益穹顶。
这套设计对协议的好处太明显了:TVL像吹气球一样从5亿冲到30亿,资本粘性被锁进层层套娃的合约里,连巨鲸都舍不得轻易离场。但代价全由散户买单——我亲眼见群里有人每天定三个闹钟,凌晨两点爬起来换池刷分,手续费烧了几千U,积分排名却纹丝不动。为什么?因为在那个由存入时长和资金体量共同决定的模型里,小散的周转资金,永远比不上大户的休眠资产。
更讽刺的是,平台还在刻意营造"勤劳就能增收"的幻觉。你每天盯着APY波动,把资金在不同池子间搬来搬去,为那0.01%的积分增量自我感动,这种西西弗斯式的重复,真的算公平参与吗?我们不过是从传统金融的食物链底层,迁徙到了链上积分体系的附庸层。每一个被机构溢价收割的$BR 积分,底层都垫着无数小资金被时间加规模双重稀释的沉没成本。
#bedrock $BR @Bedrock
104
Inicia sessão para explorar mais conteúdos
Junta-te a utilizadores de criptomoedas de todo o mundo na Binance Square
⚡️ Obtém informações úteis e recentes sobre criptomoedas.
💬 Com a confiança da maior exchange de criptomoedas do mundo.
👍 Descobre perspetivas reais de criadores verificados.
E-mail/Número de telefone
Tópicos em Tendência
ADAGains10%Above$0.27
8,281 visualizações
142 a discutir
$ADA está avançando com força hoje, subindo mais de 10% para cerca de 027 e atingindo uma nova máxima de 90 dias
O volume de negociação também disparou, ultrapassando 1 bilhão, o que demonstra forte atividade no mercado
O movimento ocorre enquanto $ADA continua sua recuperação desde as mínimas de junho, ao mesmo tempo que sua estrutura técnica recente se tornou mais otimista
A zona entre 027 e 028 é agora a principal área a observar. Um rompimento sustentado pode abrir caminho para níveis de resistência mais altos
Mas, após uma alta diária tão acentuada, a volatilidade pode continuar elevada
#ADAGains10%Above$0.27 #crypto #ADA #Cardano #crypto #Write2Earn
AbdullahAbid_7
·0 gostos
·282 visualizações
ETHUp70%InQ3ButLiquidityFalls
97,163 visualizações
871 a discutir
EthStakingExitQueueHits2026High
36,251 visualizações
644 a discutir