
打铁兔
983 Publicações
打铁兔
Denunciar
Bloquear Utilizador
打铁兔调研日记分享自己的投资策略.
Aberto ao trading
Trader Frequente
1.2 ano(s)
26 A seguir
6.8K+ Seguidores
2.3K Gostaram
Publicações
Portfólio
·
--
#sxt $SXT @SpaceandTimeDB Ativos tokenizados precisam informar posições, fluxos de caixa e avaliações; protocolos DeFi precisam determinar a elegibilidade para recompensas ou descontos nas taxas com base no histórico de comportamento. Nada disso deveria depender apenas de um relatório impossível de verificar.
@SpaceandTimeDB reúne dados on-chain e conjuntos de dados off-chain personalizados em um mesmo sistema de consultas verificáveis: por exemplo, pode consolidar transações de vários pools em um cálculo comprovável do volume negociado ou fornecer resultados de cálculos verificáveis para relatórios como o valor patrimonial líquido (NAV); contratos inteligentes também podem usar resultados comprovados de consultas históricas para determinar a elegibilidade para recompensas ou executar lógicas de desconto nas taxas baseadas em dados históricos, como as dos hooks da Uniswap.
$SXT é usado para pagar essas cargas de trabalho da rede e é colocado em staking para apoiar a segurança dos validadores. Em resumo: a Space and Time fornece suporte de dados verificáveis para IA, tokenização e DeFi.
#sxt $SXT @SpaceandTime Ativos tokenizados precisam informar posições, fluxos de caixa e avaliações; protocolos DeFi precisam determinar a elegibilidade para recompensas ou descontos nas taxas com base no histórico de comportamento. Nada disso deveria depender apenas de um relatório impossível de verificar.
@SpaceandTime reúne dados on-chain e conjuntos de dados off-chain personalizados em um mesmo sistema de consultas verificáveis: por exemplo, pode consolidar transações de vários pools em um cálculo comprovável do volume negociado ou fornecer resultados de cálculos verificáveis para relatórios como o valor patrimonial líquido (NAV); contratos inteligentes também podem usar resultados comprovados de consultas históricas para determinar a elegibilidade para recompensas ou executar lógicas de desconto nas taxas baseadas em dados históricos, como as dos hooks da Uniswap.
$SXT é usado para pagar essas cargas de trabalho da rede e é colocado em staking para apoiar a segurança dos validadores. Em resumo: a Space and Time fornece suporte de dados verificáveis para IA, tokenização e DeFi.
@SpaceandTime reúne dados on-chain e conjuntos de dados off-chain personalizados em um mesmo sistema de consultas verificáveis: por exemplo, pode consolidar transações de vários pools em um cálculo comprovável do volume negociado ou fornecer resultados de cálculos verificáveis para relatórios como o valor patrimonial líquido (NAV); contratos inteligentes também podem usar resultados comprovados de consultas históricas para determinar a elegibilidade para recompensas ou executar lógicas de desconto nas taxas baseadas em dados históricos, como as dos hooks da Uniswap.
$SXT é usado para pagar essas cargas de trabalho da rede e é colocado em staking para apoiar a segurança dos validadores. Em resumo: a Space and Time fornece suporte de dados verificáveis para IA, tokenização e DeFi.
142
·
--
#币安神算子 Quando quis assistir ao vídeo do Weibo do meu irmão mais velho, fui ver um filme. Quando terminei de assistir ao filme, achei
#币安神算子 Quando quis assistir ao vídeo do Weibo do meu irmão mais velho, fui ver um filme. Quando terminei de assistir ao filme, achei
15
·
--
Desta vez, ao ler a documentação de desenvolvimento do Dusk, não foi o ZK, nem a privacidade, o que realmente me fez parar.
Foi um detalhe bem pequeno de uma interface:
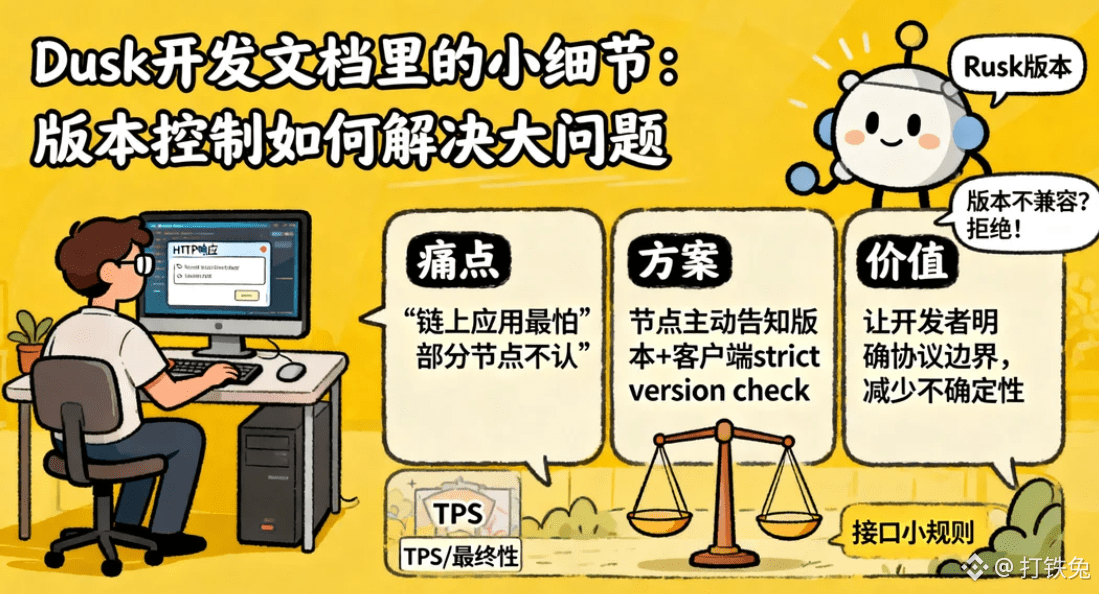
**O nó informa ao cliente a própria versão do Rusk, e o cliente também pode solicitar ativamente um intervalo de versões.**
Se a versão não for compatível, simplesmente recusa.
À primeira vista, isso não tem nada a ver com a grande narrativa das blockchains.
Mas quando eu coloquei isso dentro de um fluxo real de desenvolvimento, achei bem interessante.
Porque o que muitos aplicativos on-chain temem não é só uma interface mais lenta.
E sim:
Hoje funciona, mas depois de um upgrade, de repente começam a aparecer situações como “alguns nós reconhecem, outros não”.
Se o desenvolvedor não souber exatamente qual versão está rodando no nó ao qual ele está se conectando, fica muito difícil determinar se o problema vem do código, do nó, ou do próprio protocolo.
Agora, o Dusk coloca essas informações de versão diretamente na resposta HTTP, e também permite que o cliente faça um check estrito de versão (strict version check).
Antes, eu estava mais acostumado a avaliar se um L1 é utilizável olhando para TPS e para a finalidade (finalidade).
Agora, porém, passei a achar que essas pequenas regras na camada de interface deixam mais evidente se uma rede realmente considerou os problemas que os desenvolvedores de fato vão enfrentar.
Porque a infraestrutura não teme a complexidade.
O que ela teme é a **incerteza**.
Se um aplicativo depende de uma capacidade de um nó, e após o upgrade o comportamento do nó muda, o infortúnio maior muitas vezes não recai sobre a equipe do protocolo — e sim sobre os aplicativos que já estão em produção.
Então, essa “gestão de versão” que parece tão, digamos, de engenheiro, na verdade resolve um problema bem real:
Fazer com que o desenvolvedor saiba com que conjunto de regras de protocolo ele está falando.
Esse é também um ponto do Dusk que eu acho que vale a pena estudar agora.
Um L1 realmente maduro não é apenas “fazer a cadeia rodar”.
Tem também que deixar claro, para quem vai se conectar depois, onde estão os limites.
#dusk $DUSK @Dusk
Desta vez, ao ler a documentação de desenvolvimento do Dusk, não foi o ZK, nem a privacidade, o que realmente me fez parar.
Foi um detalhe bem pequeno de uma interface:
**O nó informa ao cliente a própria versão do Rusk, e o cliente também pode solicitar ativamente um intervalo de versões.**
Se a versão não for compatível, simplesmente recusa.
À primeira vista, isso não tem nada a ver com a grande narrativa das blockchains.
Mas quando eu coloquei isso dentro de um fluxo real de desenvolvimento, achei bem interessante.
Porque o que muitos aplicativos on-chain temem não é só uma interface mais lenta.
E sim:
Hoje funciona, mas depois de um upgrade, de repente começam a aparecer situações como “alguns nós reconhecem, outros não”.
Se o desenvolvedor não souber exatamente qual versão está rodando no nó ao qual ele está se conectando, fica muito difícil determinar se o problema vem do código, do nó, ou do próprio protocolo.
Agora, o Dusk coloca essas informações de versão diretamente na resposta HTTP, e também permite que o cliente faça um check estrito de versão (strict version check).
Antes, eu estava mais acostumado a avaliar se um L1 é utilizável olhando para TPS e para a finalidade (finalidade).
Agora, porém, passei a achar que essas pequenas regras na camada de interface deixam mais evidente se uma rede realmente considerou os problemas que os desenvolvedores de fato vão enfrentar.
Porque a infraestrutura não teme a complexidade.
O que ela teme é a **incerteza**.
Se um aplicativo depende de uma capacidade de um nó, e após o upgrade o comportamento do nó muda, o infortúnio maior muitas vezes não recai sobre a equipe do protocolo — e sim sobre os aplicativos que já estão em produção.
Então, essa “gestão de versão” que parece tão, digamos, de engenheiro, na verdade resolve um problema bem real:
Fazer com que o desenvolvedor saiba com que conjunto de regras de protocolo ele está falando.
Esse é também um ponto do Dusk que eu acho que vale a pena estudar agora.
Um L1 realmente maduro não é apenas “fazer a cadeia rodar”.
Tem também que deixar claro, para quem vai se conectar depois, onde estão os limites.
#dusk $DUSK @Dusk
Foi um detalhe bem pequeno de uma interface:
**O nó informa ao cliente a própria versão do Rusk, e o cliente também pode solicitar ativamente um intervalo de versões.**
Se a versão não for compatível, simplesmente recusa.
À primeira vista, isso não tem nada a ver com a grande narrativa das blockchains.
Mas quando eu coloquei isso dentro de um fluxo real de desenvolvimento, achei bem interessante.
Porque o que muitos aplicativos on-chain temem não é só uma interface mais lenta.
E sim:
Hoje funciona, mas depois de um upgrade, de repente começam a aparecer situações como “alguns nós reconhecem, outros não”.
Se o desenvolvedor não souber exatamente qual versão está rodando no nó ao qual ele está se conectando, fica muito difícil determinar se o problema vem do código, do nó, ou do próprio protocolo.
Agora, o Dusk coloca essas informações de versão diretamente na resposta HTTP, e também permite que o cliente faça um check estrito de versão (strict version check).
Antes, eu estava mais acostumado a avaliar se um L1 é utilizável olhando para TPS e para a finalidade (finalidade).
Agora, porém, passei a achar que essas pequenas regras na camada de interface deixam mais evidente se uma rede realmente considerou os problemas que os desenvolvedores de fato vão enfrentar.
Porque a infraestrutura não teme a complexidade.
O que ela teme é a **incerteza**.
Se um aplicativo depende de uma capacidade de um nó, e após o upgrade o comportamento do nó muda, o infortúnio maior muitas vezes não recai sobre a equipe do protocolo — e sim sobre os aplicativos que já estão em produção.
Então, essa “gestão de versão” que parece tão, digamos, de engenheiro, na verdade resolve um problema bem real:
Fazer com que o desenvolvedor saiba com que conjunto de regras de protocolo ele está falando.
Esse é também um ponto do Dusk que eu acho que vale a pena estudar agora.
Um L1 realmente maduro não é apenas “fazer a cadeia rodar”.
Tem também que deixar claro, para quem vai se conectar depois, onde estão os limites.
#dusk $DUSK @Dusk
101
·
--
Nos últimos dias, ao ver as atualizações do protocolo do Dusk, fiquei preso por uma mudança bem fácil de ignorar:
**Boreas começa a exigir que exchanges tenham consciência de versão nas transações.**
Essa frase soa bem “de engenheiro”.
Mas, quando eu a desmontei, percebi que ela resolve um problema bem real:
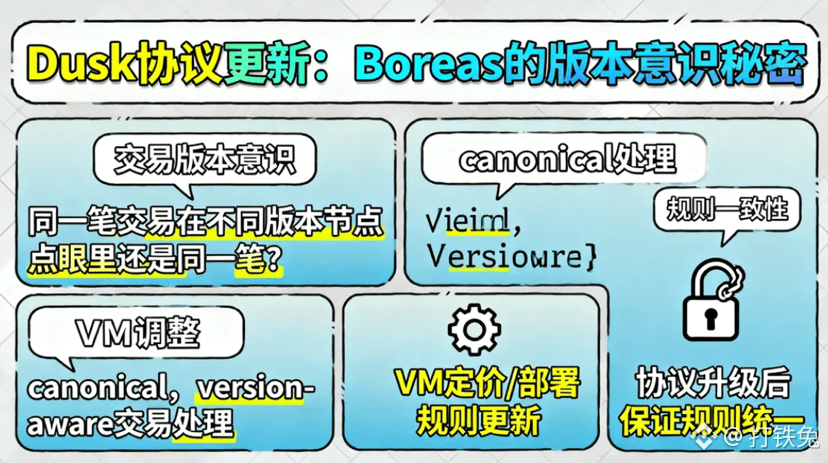
Se uma cadeia fizer upgrade das regras do protocolo, a mesma transação — para nós em versões diferentes — ainda pode ser considerada “a mesma transação”?
Agora o Boreas introduz o processamento canônico, ciente de versão, ajusta também o preço e as regras de implantação da VM, e ainda redefine a semântica de transições de estado e de eventos revertidos. A documentação oficial chega a listar explicitamente essas mudanças como partes centrais de um hard fork.
Antes, eu olhava para o L1 e era mais fácil focar em TPS, finalização e Gas.
Agora, pelo contrário, sinto que **depois de um upgrade do protocolo, manter “todo mundo entendendo o mesmo conjunto de regras”** pode ser ainda mais importante.
Porque o problema de verdade não é o upgrade em si.
Mas sim:
Como os nós interpretam?
Como a validação interpreta?
Como interpretar o replay de transações históricas?
E como as aplicações interpretam?
Enquanto uma dessas camadas tiver uma compreensão diferente, o que vem depois não é apenas performance — é quem, afinal, é reconhecido como o estado “correto”.
Então o Boreas me fez entender, pela primeira vez com mais concretude, por que blockchains maduras gastam tanto tempo lidando com regras que parecem “não empolgantes”.
Isso não é adicionar um novo recurso ao usuário.
É traçar limites com antecedência para desenvolvedores, nós e aplicações no futuro.
Antes, eu achava que esse tipo de atualização era difícil de transformar em conteúdo, porque não tem números bonitos, nem um novo produto.
Mas agora eu penso o contrário: é justamente aqui que dá para ver o amadurecimento de engenharia de uma cadeia.
**Um protocolo realmente confiável não só precisa conseguir lidar com as transações de hoje, como também precisa garantir que, depois do upgrade de amanhã, as transações de ontem não ganhem de repente uma interpretação diferente.**
Talvez seja isso que torne o Boreas realmente digno de ser observado.
#dusk $DUSK @Dusk
Nos últimos dias, ao ver as atualizações do protocolo do Dusk, fiquei preso por uma mudança bem fácil de ignorar:
**Boreas começa a exigir que exchanges tenham consciência de versão nas transações.**
Essa frase soa bem “de engenheiro”.
Mas, quando eu a desmontei, percebi que ela resolve um problema bem real:
Se uma cadeia fizer upgrade das regras do protocolo, a mesma transação — para nós em versões diferentes — ainda pode ser considerada “a mesma transação”?
Agora o Boreas introduz o processamento canônico, ciente de versão, ajusta também o preço e as regras de implantação da VM, e ainda redefine a semântica de transições de estado e de eventos revertidos. A documentação oficial chega a listar explicitamente essas mudanças como partes centrais de um hard fork.
Antes, eu olhava para o L1 e era mais fácil focar em TPS, finalização e Gas.
Agora, pelo contrário, sinto que **depois de um upgrade do protocolo, manter “todo mundo entendendo o mesmo conjunto de regras”** pode ser ainda mais importante.
Porque o problema de verdade não é o upgrade em si.
Mas sim:
Como os nós interpretam?
Como a validação interpreta?
Como interpretar o replay de transações históricas?
E como as aplicações interpretam?
Enquanto uma dessas camadas tiver uma compreensão diferente, o que vem depois não é apenas performance — é quem, afinal, é reconhecido como o estado “correto”.
Então o Boreas me fez entender, pela primeira vez com mais concretude, por que blockchains maduras gastam tanto tempo lidando com regras que parecem “não empolgantes”.
Isso não é adicionar um novo recurso ao usuário.
É traçar limites com antecedência para desenvolvedores, nós e aplicações no futuro.
Antes, eu achava que esse tipo de atualização era difícil de transformar em conteúdo, porque não tem números bonitos, nem um novo produto.
Mas agora eu penso o contrário: é justamente aqui que dá para ver o amadurecimento de engenharia de uma cadeia.
**Um protocolo realmente confiável não só precisa conseguir lidar com as transações de hoje, como também precisa garantir que, depois do upgrade de amanhã, as transações de ontem não ganhem de repente uma interpretação diferente.**
Talvez seja isso que torne o Boreas realmente digno de ser observado.
#dusk $DUSK @Dusk
**Boreas começa a exigir que exchanges tenham consciência de versão nas transações.**
Essa frase soa bem “de engenheiro”.
Mas, quando eu a desmontei, percebi que ela resolve um problema bem real:
Se uma cadeia fizer upgrade das regras do protocolo, a mesma transação — para nós em versões diferentes — ainda pode ser considerada “a mesma transação”?
Agora o Boreas introduz o processamento canônico, ciente de versão, ajusta também o preço e as regras de implantação da VM, e ainda redefine a semântica de transições de estado e de eventos revertidos. A documentação oficial chega a listar explicitamente essas mudanças como partes centrais de um hard fork.
Antes, eu olhava para o L1 e era mais fácil focar em TPS, finalização e Gas.
Agora, pelo contrário, sinto que **depois de um upgrade do protocolo, manter “todo mundo entendendo o mesmo conjunto de regras”** pode ser ainda mais importante.
Porque o problema de verdade não é o upgrade em si.
Mas sim:
Como os nós interpretam?
Como a validação interpreta?
Como interpretar o replay de transações históricas?
E como as aplicações interpretam?
Enquanto uma dessas camadas tiver uma compreensão diferente, o que vem depois não é apenas performance — é quem, afinal, é reconhecido como o estado “correto”.
Então o Boreas me fez entender, pela primeira vez com mais concretude, por que blockchains maduras gastam tanto tempo lidando com regras que parecem “não empolgantes”.
Isso não é adicionar um novo recurso ao usuário.
É traçar limites com antecedência para desenvolvedores, nós e aplicações no futuro.
Antes, eu achava que esse tipo de atualização era difícil de transformar em conteúdo, porque não tem números bonitos, nem um novo produto.
Mas agora eu penso o contrário: é justamente aqui que dá para ver o amadurecimento de engenharia de uma cadeia.
**Um protocolo realmente confiável não só precisa conseguir lidar com as transações de hoje, como também precisa garantir que, depois do upgrade de amanhã, as transações de ontem não ganhem de repente uma interpretação diferente.**
Talvez seja isso que torne o Boreas realmente digno de ser observado.
#dusk $DUSK @Dusk
113
Inicia sessão para explorar mais conteúdos
Junta-te a utilizadores de criptomoedas de todo o mundo na Binance Square
⚡️ Obtém informações úteis e recentes sobre criptomoedas.
💬 Com a confiança da maior exchange de criptomoedas do mundo.
👍 Descobre perspetivas reais de criadores verificados.
E-mail/Número de telefone
Tópicos em Tendência
CryptoSelloffTriggersMultipleWhaleLiquidations
200,818 visualizações
1,864 a discutir
Liquidações de criptomoedas superam US$ 2 bilhões em 24 horas, com 329 mil traders eliminados
Binance News
·40 gostos
·58k visualizações
USSpotXRPETFsSeeLargestWeeklyOutflowIn8Months
173,521 visualizações
1,601 a discutir
WillFOMCMinutesReinforceRateHikeExpectations?
53,081 visualizações
785 a discutir