
ME News
51.9k Publicações

ME News
 Square verificado+
Denunciar
Bloquear Utilizador
ME Group 是全球领先的金融资讯与科技平台。总部位于香港,纽约设有北美办公室。核心业务涵盖媒体服务(ME News)、品牌会展(ME Event)、视频服务(BTV)、及AI 驱动的媒体、营销与数据服务。致力于为全球用户提供精准的资讯内容、专业的市场服务和AI智能化解决方案。
1 A seguir
2.5K+ Seguidores
7.9K+ Gostaram
Publicações
Tudo
Vídeos
Em direto
·
--
Artigo
Ver tradução
把「因果思维链」焊进世界模型,它凭什么登顶?AI生成的摘要:Aether AI发布首个因果世界模型CausalWM(16B参数),引入因果思维链技术,通过先推演物体运动和几何变化、再生成未来画面的方式,让模型理解「未来是怎样一步一步发生的」。
文章作者:机器之心
文章来源:火星财经
把一个杯子从桌子左边推到右边,对人来说再自然不过。但如果把这个过程拆开,会发现所谓的「未来」其实并不是凭空出现的:手臂先移动,接触发生后杯子才开始滑动,运动又改变物体的位置和空间关系,最终才形成那一刻我们看到的画面。
对于世界模型来说,问题也在这里。
现在不少模型已经很擅长直接从「当前画面」生成「未 来画面」。但如果中间这些运动、接触、几何变化全部藏在模型内部,我们很难知道,它究竟理解了世界如何变化,还是仅仅根据训练数据,「猜」出了一个看起来合理的未来。
最近,Aether AI正式发布了第一版因果世界模型 CausalWM(16B 参数)。它尝试把原本藏在模型内部的这段过程显式写出来,并引入了一种新的技术范式 ——Causal Chain-of-Thought,因果思维链。
来源: Aether AI 创始人黄碧薇 X 官方账号
简单来说,CausalWM 不急着直接生成未来,而是先推演物体如何运动、三维几何关系怎样变化,再根据这些中间结果继续生成未 来画面。
Aether AI 希望借此回答一个更难的问题:世界模型能不能不只预测「未来长什么样」,还进一步理解「未来是怎样一步一步发生的?」
这套方法目前也已经得到了一些阶段性的实验验证。
在最新更新的机器人世界模型基准 TriWorldBench 上,CausalWM 登顶 Leaderboard,取得 Top-1。这个榜单专门考察世界模型对机器人任务的预测能力,尤其是头部相机、左腕相机、右腕相机的三视角一致性。该榜单总共包含六个评测维度、19 项具体指标,只是「看起来合理」很难拿高分,需要理解机制才行。
这条思路与团队此前发布的 RSIAgent 一脉相承。RSIAgent 让智能体进入陌生软件,通过主动探索和反复验证,摸清操作与结果之间的关系,再把经验沉淀进 Memory。它没有更新模型参数,却推动 Kimi -K3、GLM-5.3 等开源模型在 OSWorld 2.0、Agents' Last Exam 上超过 GPT-6 Astra 等闭源模型。RSIAgent 处理的是数字环境,CausalWM 将问题推进到了机器人所在的物理世界。
相比「又一个榜单第一」,更值得讨论的是:CausalWM 为什么要在世界模型里加入这样一条因果思维链,以及这条链究竟是怎样工作的?
世界模型也开始写「解题过程」
目前不少世界模型采用一条很直接的路径:输入当前画面和动作指令,生成未来视频。这种方法在数据规模足够大时很有效。模型见过大量「手推杯子」的视频,自然能猜出杯子接下来大概率会移动。
但运动、接触和空间变化都被压进了模型内部,我们很难判断它究竟理解了物理过程,还是从训练数据中找到某种 shortcut。
场景一复杂,问题也容易暴露出来。机器人连续操作多个物体,预测时间拉长,中间一次接触判断失误,后面的画面就可能越偏越远。
CausalWM 的思路,有点像让一个只写答案的学生补上解题过程。它并不直接从当前画面跳到未 来画面,而是在生成未来视频前,先把其中一部分物理变化显式地预测出来。
团队选取了几类可以从视频中自动提取的物理变量:
Optical Flow,也就是光流,描述画面中的物体往哪里移动、移动了多少。
Depth,描述物体与相机之间的距离。
Pointmap,则进一步为画面中的像素补上三维空间位置,让模型获得更明确的三维几何关系。
但真正关键的,并不是 CausalWM 使用了 Flow、Depth 或 Pointmap。这些变量过去已经被大量用于视频预测和视觉理解,有时也会作为辅助监督信号出现。CausalWM 真正不同的地方,是把它们组织成一条有顺序的 reasoning chain。
还是以推杯子为例。模型并非先回答:几帧之后,杯子会在哪里?而是先思考:画面中什么东西正在运动,它正在往哪里运动?这对应的是 Physical Motion。CausalWM 可以通过 Optical Flow 表达这一步变化。
接下来,模型继续推演:这样的运动,会让场景中的三维空间关系发生什么改变?杯子的位置发生了变化,机械臂与杯子的相对距离发生变化,整个场景的三维结构也跟着变化。这一步对应 Geometry,可以通过 Depth、Pointmap 等变量表达。
到这一步之后,模型才真正去生成:在这样的运动与几何变化之后,未 来面应该是什么样子?
于是,一条典型的推理链形成:
Observation → Physical Motion → Geometry → Future Observation
这里还有一个很重要的区别。传统方法即使预测 Flow、Depth 或 Pointmap,也可能只是把它们当作训练阶段的辅助目标。模型做完这道「辅助题」,未来视频仍然可以走另一条内部路径生成。
CausalWM 则不一样。模型预测出 Flow 后,会把这一步结果重新放进上下文,继续用来判断三维几何关系;随后得到的 Pointmap 又进一步进入上下文,参与未 来面的生成。因此每一步既是预测目标,也是下一步推理的条件。这也是为什么团队把它称作 Causal Chain-of-Thought。它利用现实世界本身就存在的运动与几何变化,搭出一条真正参与未来生成的 reasoning trajectory。
为了避免模型训练时「偷看答案」,CausalWM 还加入了 stage-ordered attention mask。简单理解,就是给不同推理阶段规定阅读权限:前面的步骤只能看到已经发生的信息,不能提前读取后面的 Pointmap 或未 来面。否则,模型虽然表面上完成了 Motion、Geometry 等中间预测,实际上可能已经从「最终答案」中反推出前面的变量,这条所谓的因果链也就失去了意义。
因此,无论训练还是实际推理,模型都必须按照同样的方向往下走:Motion → Geometry → Future。
3 万小时视频,分三步把因果链训出来
要让模型真正沿着这条链推演,光有架构设计还不够。Aether AI 为 CausalWM 构建了约 3 万小时的具身视频混合数据,覆盖机器人操作、第一视角视频、多视角机器人数据,以及其他物理交互场景。
整个训练过程分为三步:
Pixel-level Pre-training → Causal CoT Mid-training → Multi-objective RL Post-training
第一阶段:先建立足够强的世界生成能力
CausalWM 以 LTX-2.3-22B 为基座,在大规模视频上学习语言条件下的未来预测。给它一段当前画面和任务描述,模型首先要能生成连贯、可信的后续视频。没有这层基础,后面的物理推理也无从谈起。
现实数据还有一个麻烦:大量视频没有对应的机器人动作标注。即使有,不同机器人的关节数量、控制方式和动作空间也差别很大,很难放在一起直接训练。
团队为此引入 CD-LAM,从视频中提取统一的 latent action。它可以把画面中发生的变化压缩成一种潜在动作表示,让模型在缺少真实控制指令的情况下,仍能学习 “什么动作带来了什么变化”。来自不同机器人的视频,也可以通过这套统一表示共同用于 action-conditioned dynamics,也就是动作条件下的世界演化建模。
考虑到机器人通常同时拥有头部、手腕等多个摄像头,团队还在这一阶段训练了多视角版本。模型需要从不同位置观察同一次操作,并保持物体状态和机器人动作的一致。这为后续参加 TriWorldBench 的三视角评测打下了基础。
第二阶段,模型开始正式学习 Causal CoT
团队选取 Optical Flow、Depth 和 Pointmap 作为中间物理变量。它们分别描述画面中的运动、物体与相机的距离,以及更明确的三维空间关系。这几类信息都可以从原始视频中自动提取,因此不需要逐条人工标注,也更容易扩展到大规模数据。
训练过程中,模型按照预设的物理依赖关系逐步生成中间变量。典型顺序是:
Flow → Pointmap → Future RGB
模型先预测物体如何运动,再推演三维几何如何变化,最后生成未 来面。前一步的预测结果会重新放回上下文,继续指导下一步。这样一来,Flow 和 Pointmap 既是需要预测的目标,也是后续推理直接使用的条件。
为了防止模型在训练中提前看到后面的答案,CausalWM 使用了 stage-ordered attention mask。每个阶段只能读取当前步骤之前的信息,后面的 Pointmap 和未来视频无法向前泄露。模型在训练和实际推理时都遵循相同顺序,这条 CoT 才会真正参与未来视频的生成。
第三阶段:用最终结果反过来优化整条推理链
视频生成具有很强的开放性。同一个初始场景可能存在多个合理未来,很难像分类任务一样依靠唯一标准答案训练。单纯使用监督学习,也很难同时照顾物理一致性、时序质量和任务完成情况。
CausalWM 因此加入多目标强化学习。针对同一个上下文,模型会采样多个未来结果,再从物理一致性、视觉质量和任务完成度等维度获得奖励,通过 group-based optimization 比较和优化这些候选结果。
这一步优化的范围还包括中间的 Causal CoT。模型会根据最终视频的质量,探索哪些推理路径更有效:能够产生合理未来的中间过程得到强化,容易把运动和几何关系带偏的路径受到抑制。
经过这一阶段,Causal CoT 从一条固定的监督链,进一步变成可以探索和优化的物理推理过程。模型学习的不只有未 来面应该长什么样,还包括怎样经过一组更合理的中间变化走到那个未来。
当 Causal CoT 变成 In-context Learning 的控制接口
Causal CoT 还带来了一个额外能力。
训练过程中,CausalWM 不断接收光流、深度和 Pointmap 等视觉变量,再利用它们生成下一阶段结果。久而久之,模型学会了一种更通用的操作:只要新的条件能够表示成视觉信息,就有机会被放进上下文,参与未来生成。
这给控制留下了入口。
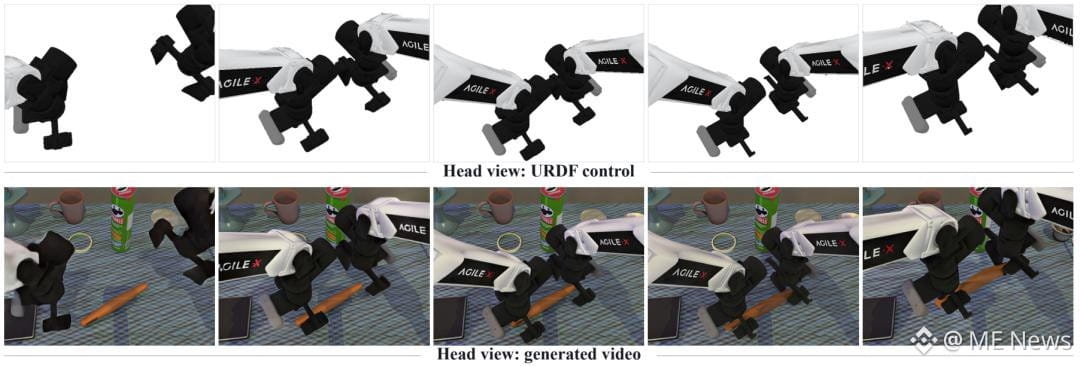
假设研究人员已经在仿真器中规划好机械臂的关节运动轨迹。利用机器人的 URDF 结构信息和正向运动学,这串关节数据可以被渲染成画面中的动作轨迹,再编码成视觉 token,送进 CausalWM。
经过少量微调,模型便能识别这种原本不在 Causal CoT 中的条件,并生成与指定轨迹一致的未来视频。人工绘制的物体路径、几何约束等视觉信号,也可以沿着同一个接口输入。
原本用来解释未来如何发生的中间变量,由此成了可以拨动的 “控制旋钮”。
这一点很接近因果问题的核心。普通预测问的是:按照已有画面,接下来大概率出现什么?加入轨迹,相当于主动改变一个条件,再观察未来怎样随之变化。模型开始处理 “如果让机械臂这样运动,杯子会怎样移动” 这类带有干预意味的问题。
当然,这距离严格意义上的反事实推理还有距离。但它已经让世界模型从观看未来,向操纵条件、比较结果迈出了一步。
Causal CoT 真的有效吗?
Causal CoT 真的能让世界模型更好地预测未来吗?
Aether AI 在多类具身世界模型 Benchmark 上对 CausalWM 进行了评测,覆盖语言条件、动作条件、单视角和多视角预测。其中包括在线 Benchmark TriWorldBench,以及离线 Benchmark PAI-Bench 等。结果显示,CausalWM 在多个设置下取得了领先结果。
其中,TriWorldBench 提供了一个比较直观的观察窗口。
和很多只评单个外部视角的视频 Benchmark 不同,它要求模型同时生成头部、左腕和右腕三个视角。这很接近机器人真实工作时的观察方式:头部相机看全局任务进展,腕部相机关注局部接触与抓取。
因此,三个画面不只要分别「看起来像」,还必须描述同一个物理世界:机器人什么时候运动、物体有没有被正确抓取、不同视角里的状态能不能对应起来。
在最新排名中,CausalWM 以 66.04 的 TWB-Score 排在第一。其中三视角一致性、任务对齐、运动质量、透视合理性和图像质量等多项指标均进入前列或取得领先。
它并没有包揽所有单项第一。最终总分领先,更像是在说明:在这套评测下,CausalWM 能较好地同时处理多视角一致性、任务理解、物理交互和视频生成质量。
TriWorldBench 之外,团队还在 PAI-Bench 等不同设置下进行了测试,并在最新排名中位列第一。
和 TriWorldBench 侧重机器人多视角一致性不同,PAI-Bench 拷问的是一个更底层的问题:模型预测的未来,符合物理规律吗?这个基准的全部案例都来自行车记录仪、工业相机等真实世界采集,横跨自动驾驶、机器人操作、工业场景、人类活动、物理常识等领域。评测时不只看画面质量,还引入「Domain Score」,让多模态大模型当裁判,对着生成视频逐条追问物理细节。因此,模型也不能只靠「画面生成得像」拿高分。
单看一个榜单的榜首,偶然因素总是存在。但如果同一套方法在多种任务设置下都能取得较好的结果,至少提供了一个方法层面的信号:
相比只让模型直接从 Observation 跳到 Future,把中间的 Motion 和 Geometry 显式建模出来,可能确实能帮助世界模型更稳定地预测物理世界的变化。
Aether AI 的 CausalWM:从 “预测世界” 到 “理解世界”
过去几年,世界模型的主线很清晰:更多数据、更大模型、更长视频、更高分辨率。这条 Scaling 路线教会了模型回答一个问题 —— 未来长什么样。而 Aether AI 更关心的是另一个问题:未来为什么会这样发生,以及什么真正决定了未来。
这也是 Aether AI 持续推进因果智能(Causal Intelligence) 的核心出发点。对于世界模型而言,现有方法往往把运动、几何和物理知识隐式压缩进隐表示中。模型可能生成一个看起来合理的未来,却很难判断它是否真正识别了关键因果变量,还是依赖数据中的 shortcut correlation 直接 “猜” 出了结果。随着预测时间变长、物体交互变复杂,这种隐式建模的局限也会更加明显,误差会在看不到的地方层层累积。
CausalWM 是 Aether AI 在因果世界模型方向上的第一版尝试。 它试图把原本隐藏在模型内部的物理变化显式化:将光流、深度、三维几何等变量组织成有顺序的 Causal CoT,让模型沿着 Motion → Geometry → Future 的因果链逐步推演,再生成未 来面。换句话说,模型不再只是学习 “输入到结果” 的相关性,而开始显式建模哪些中间变化导致了哪些后续结果。
实验也验证了这条路线的潜力:CausalWM 登顶 TriWorldBench,并在 PAI-Bench 多项指标上超过 SOTA 模型,其中不乏参数规模更大的方法。相比单纯继续扩大模型规模,Aether AI 更想验证的是另一条路径:通过建模 causal variables、causal dependencies 和 causal transitions,提升世界模型对物理世界的理解能力。
更进一步,Causal CoT 也让 “因果推理” 和 “控制” 开始共享同一套接口。原本用于解释未来的中间变量,也可以反过来作为 intervention 通过 in-context learning 形式注入模型。例如,将 simulator 中规划的机械臂轨迹渲染成视觉信号后加入 context,模型就可以生成与该 intervention 一致的未来。这意味着,世界模型开始从单纯观察 “世界会发生什么”,进一步走向建模:当我们改变某个变量、施加某个行动之后,世界将如何变化。
当然,CausalWM 仍然只是这条路线的起点,距离更完整的因果发现和反事实推理仍有很长距离。但这也正是 Aether AI 希望持续推进的问题:从因果表示学习、因果推理到因果干涉,逐步实现更完整的因果智能。(注:图灵奖得主 Judea Pearl 把智能分为三层:关联、干预、反事实,按 Pearl 的因果之梯划分,现有主流模型大多停留在第一层 “关联”,触不到 “干预” 与 “反事实”)。
把视野放宽,CausalWM 只是这条长期路线的一个阶段性成果。RSIAgent 让智能体在数字环境里主动探索、验证操作与结果的关系,CausalWM 则把同一个问题搬进物理世界:一个处理软件里的因果,一个处理物理世界里的因果。
这也是 Aether AI “Towards Real-World Causal Intelligence” 所指向的方向 —— 让 AI 从预测相关性,进一步走向发现因果、理解因果、利用因果,并最终通过因果作用于世界。
该团队的下一份成果,值得期待!
把「因果思维链」焊进世界模型,它凭什么登顶?
AI生成的摘要:Aether AI发布首个因果世界模型CausalWM(16B参数),引入因果思维链技术,通过先推演物体运动和几何变化、再生成未来画面的方式,让模型理解「未来是怎样一步一步发生的」。
文章作者:机器之心
文章来源:火星财经
把一个杯子从桌子左边推到右边,对人来说再自然不过。但如果把这个过程拆开,会发现所谓的「未来」其实并不是凭空出现的:手臂先移动,接触发生后杯子才开始滑动,运动又改变物体的位置和空间关系,最终才形成那一刻我们看到的画面。
对于世界模型来说,问题也在这里。
现在不少模型已经很擅长直接从「当前画面」生成「未 来画面」。但如果中间这些运动、接触、几何变化全部藏在模型内部,我们很难知道,它究竟理解了世界如何变化,还是仅仅根据训练数据,「猜」出了一个看起来合理的未来。
最近,Aether AI正式发布了第一版因果世界模型 CausalWM(16B 参数)。它尝试把原本藏在模型内部的这段过程显式写出来,并引入了一种新的技术范式 ——Causal Chain-of-Thought,因果思维链。
来源: Aether AI 创始人黄碧薇 X 官方账号
简单来说,CausalWM 不急着直接生成未来,而是先推演物体如何运动、三维几何关系怎样变化,再根据这些中间结果继续生成未 来画面。
Aether AI 希望借此回答一个更难的问题:世界模型能不能不只预测「未来长什么样」,还进一步理解「未来是怎样一步一步发生的?」
这套方法目前也已经得到了一些阶段性的实验验证。
在最新更新的机器人世界模型基准 TriWorldBench 上,CausalWM 登顶 Leaderboard,取得 Top-1。这个榜单专门考察世界模型对机器人任务的预测能力,尤其是头部相机、左腕相机、右腕相机的三视角一致性。该榜单总共包含六个评测维度、19 项具体指标,只是「看起来合理」很难拿高分,需要理解机制才行。
这条思路与团队此前发布的 RSIAgent 一脉相承。RSIAgent 让智能体进入陌生软件,通过主动探索和反复验证,摸清操作与结果之间的关系,再把经验沉淀进 Memory。它没有更新模型参数,却推动 Kimi -K3、GLM-5.3 等开源模型在 OSWorld 2.0、Agents' Last Exam 上超过 GPT-6 Astra 等闭源模型。RSIAgent 处理的是数字环境,CausalWM 将问题推进到了机器人所在的物理世界。
相比「又一个榜单第一」,更值得讨论的是:CausalWM 为什么要在世界模型里加入这样一条因果思维链,以及这条链究竟是怎样工作的?
世界模型也开始写「解题过程」
目前不少世界模型采用一条很直接的路径:输入当前画面和动作指令,生成未来视频。这种方法在数据规模足够大时很有效。模型见过大量「手推杯子」的视频,自然能猜出杯子接下来大概率会移动。
但运动、接触和空间变化都被压进了模型内部,我们很难判断它究竟理解了物理过程,还是从训练数据中找到某种 shortcut。
场景一复杂,问题也容易暴露出来。机器人连续操作多个物体,预测时间拉长,中间一次接触判断失误,后面的画面就可能越偏越远。
CausalWM 的思路,有点像让一个只写答案的学生补上解题过程。它并不直接从当前画面跳到未 来画面,而是在生成未来视频前,先把其中一部分物理变化显式地预测出来。
团队选取了几类可以从视频中自动提取的物理变量:
Optical Flow,也就是光流,描述画面中的物体往哪里移动、移动了多少。
Depth,描述物体与相机之间的距离。
Pointmap,则进一步为画面中的像素补上三维空间位置,让模型获得更明确的三维几何关系。
但真正关键的,并不是 CausalWM 使用了 Flow、Depth 或 Pointmap。这些变量过去已经被大量用于视频预测和视觉理解,有时也会作为辅助监督信号出现。CausalWM 真正不同的地方,是把它们组织成一条有顺序的 reasoning chain。
还是以推杯子为例。模型并非先回答:几帧之后,杯子会在哪里?而是先思考:画面中什么东西正在运动,它正在往哪里运动?这对应的是 Physical Motion。CausalWM 可以通过 Optical Flow 表达这一步变化。
接下来,模型继续推演:这样的运动,会让场景中的三维空间关系发生什么改变?杯子的位置发生了变化,机械臂与杯子的相对距离发生变化,整个场景的三维结构也跟着变化。这一步对应 Geometry,可以通过 Depth、Pointmap 等变量表达。
到这一步之后,模型才真正去生成:在这样的运动与几何变化之后,未 来面应该是什么样子?
于是,一条典型的推理链形成:
Observation → Physical Motion → Geometry → Future Observation
这里还有一个很重要的区别。传统方法即使预测 Flow、Depth 或 Pointmap,也可能只是把它们当作训练阶段的辅助目标。模型做完这道「辅助题」,未来视频仍然可以走另一条内部路径生成。
CausalWM 则不一样。模型预测出 Flow 后,会把这一步结果重新放进上下文,继续用来判断三维几何关系;随后得到的 Pointmap 又进一步进入上下文,参与未 来面的生成。因此每一步既是预测目标,也是下一步推理的条件。这也是为什么团队把它称作 Causal Chain-of-Thought。它利用现实世界本身就存在的运动与几何变化,搭出一条真正参与未来生成的 reasoning trajectory。
为了避免模型训练时「偷看答案」,CausalWM 还加入了 stage-ordered attention mask。简单理解,就是给不同推理阶段规定阅读权限:前面的步骤只能看到已经发生的信息,不能提前读取后面的 Pointmap 或未 来面。否则,模型虽然表面上完成了 Motion、Geometry 等中间预测,实际上可能已经从「最终答案」中反推出前面的变量,这条所谓的因果链也就失去了意义。
因此,无论训练还是实际推理,模型都必须按照同样的方向往下走:Motion → Geometry → Future。
3 万小时视频,分三步把因果链训出来
要让模型真正沿着这条链推演,光有架构设计还不够。Aether AI 为 CausalWM 构建了约 3 万小时的具身视频混合数据,覆盖机器人操作、第一视角视频、多视角机器人数据,以及其他物理交互场景。
整个训练过程分为三步:
Pixel-level Pre-training → Causal CoT Mid-training → Multi-objective RL Post-training
第一阶段:先建立足够强的世界生成能力
CausalWM 以 LTX-2.3-22B 为基座,在大规模视频上学习语言条件下的未来预测。给它一段当前画面和任务描述,模型首先要能生成连贯、可信的后续视频。没有这层基础,后面的物理推理也无从谈起。
现实数据还有一个麻烦:大量视频没有对应的机器人动作标注。即使有,不同机器人的关节数量、控制方式和动作空间也差别很大,很难放在一起直接训练。
团队为此引入 CD-LAM,从视频中提取统一的 latent action。它可以把画面中发生的变化压缩成一种潜在动作表示,让模型在缺少真实控制指令的情况下,仍能学习 “什么动作带来了什么变化”。来自不同机器人的视频,也可以通过这套统一表示共同用于 action-conditioned dynamics,也就是动作条件下的世界演化建模。
考虑到机器人通常同时拥有头部、手腕等多个摄像头,团队还在这一阶段训练了多视角版本。模型需要从不同位置观察同一次操作,并保持物体状态和机器人动作的一致。这为后续参加 TriWorldBench 的三视角评测打下了基础。
第二阶段,模型开始正式学习 Causal CoT
团队选取 Optical Flow、Depth 和 Pointmap 作为中间物理变量。它们分别描述画面中的运动、物体与相机的距离,以及更明确的三维空间关系。这几类信息都可以从原始视频中自动提取,因此不需要逐条人工标注,也更容易扩展到大规模数据。
训练过程中,模型按照预设的物理依赖关系逐步生成中间变量。典型顺序是:
Flow → Pointmap → Future RGB
模型先预测物体如何运动,再推演三维几何如何变化,最后生成未 来面。前一步的预测结果会重新放回上下文,继续指导下一步。这样一来,Flow 和 Pointmap 既是需要预测的目标,也是后续推理直接使用的条件。
为了防止模型在训练中提前看到后面的答案,CausalWM 使用了 stage-ordered attention mask。每个阶段只能读取当前步骤之前的信息,后面的 Pointmap 和未来视频无法向前泄露。模型在训练和实际推理时都遵循相同顺序,这条 CoT 才会真正参与未来视频的生成。
第三阶段:用最终结果反过来优化整条推理链
视频生成具有很强的开放性。同一个初始场景可能存在多个合理未来,很难像分类任务一样依靠唯一标准答案训练。单纯使用监督学习,也很难同时照顾物理一致性、时序质量和任务完成情况。
CausalWM 因此加入多目标强化学习。针对同一个上下文,模型会采样多个未来结果,再从物理一致性、视觉质量和任务完成度等维度获得奖励,通过 group-based optimization 比较和优化这些候选结果。
这一步优化的范围还包括中间的 Causal CoT。模型会根据最终视频的质量,探索哪些推理路径更有效:能够产生合理未来的中间过程得到强化,容易把运动和几何关系带偏的路径受到抑制。
经过这一阶段,Causal CoT 从一条固定的监督链,进一步变成可以探索和优化的物理推理过程。模型学习的不只有未 来面应该长什么样,还包括怎样经过一组更合理的中间变化走到那个未来。
当 Causal CoT 变成 In-context Learning 的控制接口
Causal CoT 还带来了一个额外能力。
训练过程中,CausalWM 不断接收光流、深度和 Pointmap 等视觉变量,再利用它们生成下一阶段结果。久而久之,模型学会了一种更通用的操作:只要新的条件能够表示成视觉信息,就有机会被放进上下文,参与未来生成。
这给控制留下了入口。
假设研究人员已经在仿真器中规划好机械臂的关节运动轨迹。利用机器人的 URDF 结构信息和正向运动学,这串关节数据可以被渲染成画面中的动作轨迹,再编码成视觉 token,送进 CausalWM。
经过少量微调,模型便能识别这种原本不在 Causal CoT 中的条件,并生成与指定轨迹一致的未来视频。人工绘制的物体路径、几何约束等视觉信号,也可以沿着同一个接口输入。
原本用来解释未来如何发生的中间变量,由此成了可以拨动的 “控制旋钮”。
这一点很接近因果问题的核心。普通预测问的是:按照已有画面,接下来大概率出现什么?加入轨迹,相当于主动改变一个条件,再观察未来怎样随之变化。模型开始处理 “如果让机械臂这样运动,杯子会怎样移动” 这类带有干预意味的问题。
当然,这距离严格意义上的反事实推理还有距离。但它已经让世界模型从观看未来,向操纵条件、比较结果迈出了一步。
Causal CoT 真的有效吗?
Causal CoT 真的能让世界模型更好地预测未来吗?
Aether AI 在多类具身世界模型 Benchmark 上对 CausalWM 进行了评测,覆盖语言条件、动作条件、单视角和多视角预测。其中包括在线 Benchmark TriWorldBench,以及离线 Benchmark PAI-Bench 等。结果显示,CausalWM 在多个设置下取得了领先结果。
其中,TriWorldBench 提供了一个比较直观的观察窗口。
和很多只评单个外部视角的视频 Benchmark 不同,它要求模型同时生成头部、左腕和右腕三个视角。这很接近机器人真实工作时的观察方式:头部相机看全局任务进展,腕部相机关注局部接触与抓取。
因此,三个画面不只要分别「看起来像」,还必须描述同一个物理世界:机器人什么时候运动、物体有没有被正确抓取、不同视角里的状态能不能对应起来。
在最新排名中,CausalWM 以 66.04 的 TWB-Score 排在第一。其中三视角一致性、任务对齐、运动质量、透视合理性和图像质量等多项指标均进入前列或取得领先。
它并没有包揽所有单项第一。最终总分领先,更像是在说明:在这套评测下,CausalWM 能较好地同时处理多视角一致性、任务理解、物理交互和视频生成质量。
TriWorldBench 之外,团队还在 PAI-Bench 等不同设置下进行了测试,并在最新排名中位列第一。
和 TriWorldBench 侧重机器人多视角一致性不同,PAI-Bench 拷问的是一个更底层的问题:模型预测的未来,符合物理规律吗?这个基准的全部案例都来自行车记录仪、工业相机等真实世界采集,横跨自动驾驶、机器人操作、工业场景、人类活动、物理常识等领域。评测时不只看画面质量,还引入「Domain Score」,让多模态大模型当裁判,对着生成视频逐条追问物理细节。因此,模型也不能只靠「画面生成得像」拿高分。
单看一个榜单的榜首,偶然因素总是存在。但如果同一套方法在多种任务设置下都能取得较好的结果,至少提供了一个方法层面的信号:
相比只让模型直接从 Observation 跳到 Future,把中间的 Motion 和 Geometry 显式建模出来,可能确实能帮助世界模型更稳定地预测物理世界的变化。
Aether AI 的 CausalWM:从 “预测世界” 到 “理解世界”
过去几年,世界模型的主线很清晰:更多数据、更大模型、更长视频、更高分辨率。这条 Scaling 路线教会了模型回答一个问题 —— 未来长什么样。而 Aether AI 更关心的是另一个问题:未来为什么会这样发生,以及什么真正决定了未来。
这也是 Aether AI 持续推进因果智能(Causal Intelligence) 的核心出发点。对于世界模型而言,现有方法往往把运动、几何和物理知识隐式压缩进隐表示中。模型可能生成一个看起来合理的未来,却很难判断它是否真正识别了关键因果变量,还是依赖数据中的 shortcut correlation 直接 “猜” 出了结果。随着预测时间变长、物体交互变复杂,这种隐式建模的局限也会更加明显,误差会在看不到的地方层层累积。
CausalWM 是 Aether AI 在因果世界模型方向上的第一版尝试。 它试图把原本隐藏在模型内部的物理变化显式化:将光流、深度、三维几何等变量组织成有顺序的 Causal CoT,让模型沿着 Motion → Geometry → Future 的因果链逐步推演,再生成未 来面。换句话说,模型不再只是学习 “输入到结果” 的相关性,而开始显式建模哪些中间变化导致了哪些后续结果。
实验也验证了这条路线的潜力:CausalWM 登顶 TriWorldBench,并在 PAI-Bench 多项指标上超过 SOTA 模型,其中不乏参数规模更大的方法。相比单纯继续扩大模型规模,Aether AI 更想验证的是另一条路径:通过建模 causal variables、causal dependencies 和 causal transitions,提升世界模型对物理世界的理解能力。
更进一步,Causal CoT 也让 “因果推理” 和 “控制” 开始共享同一套接口。原本用于解释未来的中间变量,也可以反过来作为 intervention 通过 in-context learning 形式注入模型。例如,将 simulator 中规划的机械臂轨迹渲染成视觉信号后加入 context,模型就可以生成与该 intervention 一致的未来。这意味着,世界模型开始从单纯观察 “世界会发生什么”,进一步走向建模:当我们改变某个变量、施加某个行动之后,世界将如何变化。
当然,CausalWM 仍然只是这条路线的起点,距离更完整的因果发现和反事实推理仍有很长距离。但这也正是 Aether AI 希望持续推进的问题:从因果表示学习、因果推理到因果干涉,逐步实现更完整的因果智能。(注:图灵奖得主 Judea Pearl 把智能分为三层:关联、干预、反事实,按 Pearl 的因果之梯划分,现有主流模型大多停留在第一层 “关联”,触不到 “干预” 与 “反事实”)。
把视野放宽,CausalWM 只是这条长期路线的一个阶段性成果。RSIAgent 让智能体在数字环境里主动探索、验证操作与结果的关系,CausalWM 则把同一个问题搬进物理世界:一个处理软件里的因果,一个处理物理世界里的因果。
这也是 Aether AI “Towards Real-World Causal Intelligence” 所指向的方向 —— 让 AI 从预测相关性,进一步走向发现因果、理解因果、利用因果,并最终通过因果作用于世界。
该团队的下一份成果,值得期待!
文章作者:机器之心
文章来源:火星财经
把一个杯子从桌子左边推到右边,对人来说再自然不过。但如果把这个过程拆开,会发现所谓的「未来」其实并不是凭空出现的:手臂先移动,接触发生后杯子才开始滑动,运动又改变物体的位置和空间关系,最终才形成那一刻我们看到的画面。
对于世界模型来说,问题也在这里。
现在不少模型已经很擅长直接从「当前画面」生成「未 来画面」。但如果中间这些运动、接触、几何变化全部藏在模型内部,我们很难知道,它究竟理解了世界如何变化,还是仅仅根据训练数据,「猜」出了一个看起来合理的未来。
最近,Aether AI正式发布了第一版因果世界模型 CausalWM(16B 参数)。它尝试把原本藏在模型内部的这段过程显式写出来,并引入了一种新的技术范式 ——Causal Chain-of-Thought,因果思维链。
来源: Aether AI 创始人黄碧薇 X 官方账号
简单来说,CausalWM 不急着直接生成未来,而是先推演物体如何运动、三维几何关系怎样变化,再根据这些中间结果继续生成未 来画面。
Aether AI 希望借此回答一个更难的问题:世界模型能不能不只预测「未来长什么样」,还进一步理解「未来是怎样一步一步发生的?」
这套方法目前也已经得到了一些阶段性的实验验证。
在最新更新的机器人世界模型基准 TriWorldBench 上,CausalWM 登顶 Leaderboard,取得 Top-1。这个榜单专门考察世界模型对机器人任务的预测能力,尤其是头部相机、左腕相机、右腕相机的三视角一致性。该榜单总共包含六个评测维度、19 项具体指标,只是「看起来合理」很难拿高分,需要理解机制才行。
这条思路与团队此前发布的 RSIAgent 一脉相承。RSIAgent 让智能体进入陌生软件,通过主动探索和反复验证,摸清操作与结果之间的关系,再把经验沉淀进 Memory。它没有更新模型参数,却推动 Kimi -K3、GLM-5.3 等开源模型在 OSWorld 2.0、Agents' Last Exam 上超过 GPT-6 Astra 等闭源模型。RSIAgent 处理的是数字环境,CausalWM 将问题推进到了机器人所在的物理世界。
相比「又一个榜单第一」,更值得讨论的是:CausalWM 为什么要在世界模型里加入这样一条因果思维链,以及这条链究竟是怎样工作的?
世界模型也开始写「解题过程」
目前不少世界模型采用一条很直接的路径:输入当前画面和动作指令,生成未来视频。这种方法在数据规模足够大时很有效。模型见过大量「手推杯子」的视频,自然能猜出杯子接下来大概率会移动。
但运动、接触和空间变化都被压进了模型内部,我们很难判断它究竟理解了物理过程,还是从训练数据中找到某种 shortcut。
场景一复杂,问题也容易暴露出来。机器人连续操作多个物体,预测时间拉长,中间一次接触判断失误,后面的画面就可能越偏越远。
CausalWM 的思路,有点像让一个只写答案的学生补上解题过程。它并不直接从当前画面跳到未 来画面,而是在生成未来视频前,先把其中一部分物理变化显式地预测出来。
团队选取了几类可以从视频中自动提取的物理变量:
Optical Flow,也就是光流,描述画面中的物体往哪里移动、移动了多少。
Depth,描述物体与相机之间的距离。
Pointmap,则进一步为画面中的像素补上三维空间位置,让模型获得更明确的三维几何关系。
但真正关键的,并不是 CausalWM 使用了 Flow、Depth 或 Pointmap。这些变量过去已经被大量用于视频预测和视觉理解,有时也会作为辅助监督信号出现。CausalWM 真正不同的地方,是把它们组织成一条有顺序的 reasoning chain。
还是以推杯子为例。模型并非先回答:几帧之后,杯子会在哪里?而是先思考:画面中什么东西正在运动,它正在往哪里运动?这对应的是 Physical Motion。CausalWM 可以通过 Optical Flow 表达这一步变化。
接下来,模型继续推演:这样的运动,会让场景中的三维空间关系发生什么改变?杯子的位置发生了变化,机械臂与杯子的相对距离发生变化,整个场景的三维结构也跟着变化。这一步对应 Geometry,可以通过 Depth、Pointmap 等变量表达。
到这一步之后,模型才真正去生成:在这样的运动与几何变化之后,未 来面应该是什么样子?
于是,一条典型的推理链形成:
Observation → Physical Motion → Geometry → Future Observation
这里还有一个很重要的区别。传统方法即使预测 Flow、Depth 或 Pointmap,也可能只是把它们当作训练阶段的辅助目标。模型做完这道「辅助题」,未来视频仍然可以走另一条内部路径生成。
CausalWM 则不一样。模型预测出 Flow 后,会把这一步结果重新放进上下文,继续用来判断三维几何关系;随后得到的 Pointmap 又进一步进入上下文,参与未 来面的生成。因此每一步既是预测目标,也是下一步推理的条件。这也是为什么团队把它称作 Causal Chain-of-Thought。它利用现实世界本身就存在的运动与几何变化,搭出一条真正参与未来生成的 reasoning trajectory。
为了避免模型训练时「偷看答案」,CausalWM 还加入了 stage-ordered attention mask。简单理解,就是给不同推理阶段规定阅读权限:前面的步骤只能看到已经发生的信息,不能提前读取后面的 Pointmap 或未 来面。否则,模型虽然表面上完成了 Motion、Geometry 等中间预测,实际上可能已经从「最终答案」中反推出前面的变量,这条所谓的因果链也就失去了意义。
因此,无论训练还是实际推理,模型都必须按照同样的方向往下走:Motion → Geometry → Future。
3 万小时视频,分三步把因果链训出来
要让模型真正沿着这条链推演,光有架构设计还不够。Aether AI 为 CausalWM 构建了约 3 万小时的具身视频混合数据,覆盖机器人操作、第一视角视频、多视角机器人数据,以及其他物理交互场景。
整个训练过程分为三步:
Pixel-level Pre-training → Causal CoT Mid-training → Multi-objective RL Post-training
第一阶段:先建立足够强的世界生成能力
CausalWM 以 LTX-2.3-22B 为基座,在大规模视频上学习语言条件下的未来预测。给它一段当前画面和任务描述,模型首先要能生成连贯、可信的后续视频。没有这层基础,后面的物理推理也无从谈起。
现实数据还有一个麻烦:大量视频没有对应的机器人动作标注。即使有,不同机器人的关节数量、控制方式和动作空间也差别很大,很难放在一起直接训练。
团队为此引入 CD-LAM,从视频中提取统一的 latent action。它可以把画面中发生的变化压缩成一种潜在动作表示,让模型在缺少真实控制指令的情况下,仍能学习 “什么动作带来了什么变化”。来自不同机器人的视频,也可以通过这套统一表示共同用于 action-conditioned dynamics,也就是动作条件下的世界演化建模。
考虑到机器人通常同时拥有头部、手腕等多个摄像头,团队还在这一阶段训练了多视角版本。模型需要从不同位置观察同一次操作,并保持物体状态和机器人动作的一致。这为后续参加 TriWorldBench 的三视角评测打下了基础。
第二阶段,模型开始正式学习 Causal CoT
团队选取 Optical Flow、Depth 和 Pointmap 作为中间物理变量。它们分别描述画面中的运动、物体与相机的距离,以及更明确的三维空间关系。这几类信息都可以从原始视频中自动提取,因此不需要逐条人工标注,也更容易扩展到大规模数据。
训练过程中,模型按照预设的物理依赖关系逐步生成中间变量。典型顺序是:
Flow → Pointmap → Future RGB
模型先预测物体如何运动,再推演三维几何如何变化,最后生成未 来面。前一步的预测结果会重新放回上下文,继续指导下一步。这样一来,Flow 和 Pointmap 既是需要预测的目标,也是后续推理直接使用的条件。
为了防止模型在训练中提前看到后面的答案,CausalWM 使用了 stage-ordered attention mask。每个阶段只能读取当前步骤之前的信息,后面的 Pointmap 和未来视频无法向前泄露。模型在训练和实际推理时都遵循相同顺序,这条 CoT 才会真正参与未来视频的生成。
第三阶段:用最终结果反过来优化整条推理链
视频生成具有很强的开放性。同一个初始场景可能存在多个合理未来,很难像分类任务一样依靠唯一标准答案训练。单纯使用监督学习,也很难同时照顾物理一致性、时序质量和任务完成情况。
CausalWM 因此加入多目标强化学习。针对同一个上下文,模型会采样多个未来结果,再从物理一致性、视觉质量和任务完成度等维度获得奖励,通过 group-based optimization 比较和优化这些候选结果。
这一步优化的范围还包括中间的 Causal CoT。模型会根据最终视频的质量,探索哪些推理路径更有效:能够产生合理未来的中间过程得到强化,容易把运动和几何关系带偏的路径受到抑制。
经过这一阶段,Causal CoT 从一条固定的监督链,进一步变成可以探索和优化的物理推理过程。模型学习的不只有未 来面应该长什么样,还包括怎样经过一组更合理的中间变化走到那个未来。
当 Causal CoT 变成 In-context Learning 的控制接口
Causal CoT 还带来了一个额外能力。
训练过程中,CausalWM 不断接收光流、深度和 Pointmap 等视觉变量,再利用它们生成下一阶段结果。久而久之,模型学会了一种更通用的操作:只要新的条件能够表示成视觉信息,就有机会被放进上下文,参与未来生成。
这给控制留下了入口。
假设研究人员已经在仿真器中规划好机械臂的关节运动轨迹。利用机器人的 URDF 结构信息和正向运动学,这串关节数据可以被渲染成画面中的动作轨迹,再编码成视觉 token,送进 CausalWM。
经过少量微调,模型便能识别这种原本不在 Causal CoT 中的条件,并生成与指定轨迹一致的未来视频。人工绘制的物体路径、几何约束等视觉信号,也可以沿着同一个接口输入。
原本用来解释未来如何发生的中间变量,由此成了可以拨动的 “控制旋钮”。
这一点很接近因果问题的核心。普通预测问的是:按照已有画面,接下来大概率出现什么?加入轨迹,相当于主动改变一个条件,再观察未来怎样随之变化。模型开始处理 “如果让机械臂这样运动,杯子会怎样移动” 这类带有干预意味的问题。
当然,这距离严格意义上的反事实推理还有距离。但它已经让世界模型从观看未来,向操纵条件、比较结果迈出了一步。
Causal CoT 真的有效吗?
Causal CoT 真的能让世界模型更好地预测未来吗?
Aether AI 在多类具身世界模型 Benchmark 上对 CausalWM 进行了评测,覆盖语言条件、动作条件、单视角和多视角预测。其中包括在线 Benchmark TriWorldBench,以及离线 Benchmark PAI-Bench 等。结果显示,CausalWM 在多个设置下取得了领先结果。
其中,TriWorldBench 提供了一个比较直观的观察窗口。
和很多只评单个外部视角的视频 Benchmark 不同,它要求模型同时生成头部、左腕和右腕三个视角。这很接近机器人真实工作时的观察方式:头部相机看全局任务进展,腕部相机关注局部接触与抓取。
因此,三个画面不只要分别「看起来像」,还必须描述同一个物理世界:机器人什么时候运动、物体有没有被正确抓取、不同视角里的状态能不能对应起来。
在最新排名中,CausalWM 以 66.04 的 TWB-Score 排在第一。其中三视角一致性、任务对齐、运动质量、透视合理性和图像质量等多项指标均进入前列或取得领先。
它并没有包揽所有单项第一。最终总分领先,更像是在说明:在这套评测下,CausalWM 能较好地同时处理多视角一致性、任务理解、物理交互和视频生成质量。
TriWorldBench 之外,团队还在 PAI-Bench 等不同设置下进行了测试,并在最新排名中位列第一。
和 TriWorldBench 侧重机器人多视角一致性不同,PAI-Bench 拷问的是一个更底层的问题:模型预测的未来,符合物理规律吗?这个基准的全部案例都来自行车记录仪、工业相机等真实世界采集,横跨自动驾驶、机器人操作、工业场景、人类活动、物理常识等领域。评测时不只看画面质量,还引入「Domain Score」,让多模态大模型当裁判,对着生成视频逐条追问物理细节。因此,模型也不能只靠「画面生成得像」拿高分。
单看一个榜单的榜首,偶然因素总是存在。但如果同一套方法在多种任务设置下都能取得较好的结果,至少提供了一个方法层面的信号:
相比只让模型直接从 Observation 跳到 Future,把中间的 Motion 和 Geometry 显式建模出来,可能确实能帮助世界模型更稳定地预测物理世界的变化。
Aether AI 的 CausalWM:从 “预测世界” 到 “理解世界”
过去几年,世界模型的主线很清晰:更多数据、更大模型、更长视频、更高分辨率。这条 Scaling 路线教会了模型回答一个问题 —— 未来长什么样。而 Aether AI 更关心的是另一个问题:未来为什么会这样发生,以及什么真正决定了未来。
这也是 Aether AI 持续推进因果智能(Causal Intelligence) 的核心出发点。对于世界模型而言,现有方法往往把运动、几何和物理知识隐式压缩进隐表示中。模型可能生成一个看起来合理的未来,却很难判断它是否真正识别了关键因果变量,还是依赖数据中的 shortcut correlation 直接 “猜” 出了结果。随着预测时间变长、物体交互变复杂,这种隐式建模的局限也会更加明显,误差会在看不到的地方层层累积。
CausalWM 是 Aether AI 在因果世界模型方向上的第一版尝试。 它试图把原本隐藏在模型内部的物理变化显式化:将光流、深度、三维几何等变量组织成有顺序的 Causal CoT,让模型沿着 Motion → Geometry → Future 的因果链逐步推演,再生成未 来面。换句话说,模型不再只是学习 “输入到结果” 的相关性,而开始显式建模哪些中间变化导致了哪些后续结果。
实验也验证了这条路线的潜力:CausalWM 登顶 TriWorldBench,并在 PAI-Bench 多项指标上超过 SOTA 模型,其中不乏参数规模更大的方法。相比单纯继续扩大模型规模,Aether AI 更想验证的是另一条路径:通过建模 causal variables、causal dependencies 和 causal transitions,提升世界模型对物理世界的理解能力。
更进一步,Causal CoT 也让 “因果推理” 和 “控制” 开始共享同一套接口。原本用于解释未来的中间变量,也可以反过来作为 intervention 通过 in-context learning 形式注入模型。例如,将 simulator 中规划的机械臂轨迹渲染成视觉信号后加入 context,模型就可以生成与该 intervention 一致的未来。这意味着,世界模型开始从单纯观察 “世界会发生什么”,进一步走向建模:当我们改变某个变量、施加某个行动之后,世界将如何变化。
当然,CausalWM 仍然只是这条路线的起点,距离更完整的因果发现和反事实推理仍有很长距离。但这也正是 Aether AI 希望持续推进的问题:从因果表示学习、因果推理到因果干涉,逐步实现更完整的因果智能。(注:图灵奖得主 Judea Pearl 把智能分为三层:关联、干预、反事实,按 Pearl 的因果之梯划分,现有主流模型大多停留在第一层 “关联”,触不到 “干预” 与 “反事实”)。
把视野放宽,CausalWM 只是这条长期路线的一个阶段性成果。RSIAgent 让智能体在数字环境里主动探索、验证操作与结果的关系,CausalWM 则把同一个问题搬进物理世界:一个处理软件里的因果,一个处理物理世界里的因果。
这也是 Aether AI “Towards Real-World Causal Intelligence” 所指向的方向 —— 让 AI 从预测相关性,进一步走向发现因果、理解因果、利用因果,并最终通过因果作用于世界。
该团队的下一份成果,值得期待!
2
·
--
Ver tradução
剪映发布全新 AI 能力:专业版上线“剪映 Hub”,移动端推 AI 助手“小映”人人都能当创作者之后,创作者还值钱吗?
文章作者、来源:AIBase
剪映举办“AI新创作发布会”,推出剪映Hub、AI创作助手“小映”等多项AI新功能,并升级创作者生态,打造覆盖从新手到专业的全场景智能创作平台。
专业版:一站式工作台与智能创作Agent
剪映专业版推出一站式创作工作台“剪映Hub”和智能创作Agent“剪映助手”,同时升级专业功能、拓展适配设备,并同步上线“AI Ultra会员”。
剪映APP则上线移动端AI创作助手“小映”,可服务多种创作场景,还能化身AI营销专家。
创作者生态全面升级
生态层面,剪映升级了“剪同款“范式,推进专业内容和A ISkill建设,并升级创作者服务:推出激励计划、“模板作者AI助手”、新手任务以及“剪映创作合伙人”计划,助力不同阶段的创作者顺畅完成作品。
剪映发布全新 AI 能力:专业版上线“剪映 Hub”,移动端推 AI 助手“小映”
人人都能当创作者之后,创作者还值钱吗?
文章作者、来源:AIBase
剪映举办“AI新创作发布会”,推出剪映Hub、AI创作助手“小映”等多项AI新功能,并升级创作者生态,打造覆盖从新手到专业的全场景智能创作平台。
专业版:一站式工作台与智能创作Agent
剪映专业版推出一站式创作工作台“剪映Hub”和智能创作Agent“剪映助手”,同时升级专业功能、拓展适配设备,并同步上线“AI Ultra会员”。
剪映APP则上线移动端AI创作助手“小映”,可服务多种创作场景,还能化身AI营销专家。
创作者生态全面升级
生态层面,剪映升级了“剪同款“范式,推进专业内容和A ISkill建设,并升级创作者服务:推出激励计划、“模板作者AI助手”、新手任务以及“剪映创作合伙人”计划,助力不同阶段的创作者顺畅完成作品。
文章作者、来源:AIBase
剪映举办“AI新创作发布会”,推出剪映Hub、AI创作助手“小映”等多项AI新功能,并升级创作者生态,打造覆盖从新手到专业的全场景智能创作平台。
专业版:一站式工作台与智能创作Agent
剪映专业版推出一站式创作工作台“剪映Hub”和智能创作Agent“剪映助手”,同时升级专业功能、拓展适配设备,并同步上线“AI Ultra会员”。
剪映APP则上线移动端AI创作助手“小映”,可服务多种创作场景,还能化身AI营销专家。
创作者生态全面升级
生态层面,剪映升级了“剪同款“范式,推进专业内容和A ISkill建设,并升级创作者服务:推出激励计划、“模板作者AI助手”、新手任务以及“剪映创作合伙人”计划,助力不同阶段的创作者顺畅完成作品。
3
·
--
Ver tradução
ME News 消息,9 月 20 日(UTC+8), 慢雾余弦在 X 平台发文表示,相较于 FomoPeek App 在 iPhone 上投毒盗币的案例,更建议关注外卖 App ComeCome 采用类似手法投毒盗币的案例。部分看似正常的 App 可能在使用后导致用户遭遇投毒,且该情况发生在 iPhone 上;建议及时更新 iOS 新版本,iPad 和 Mac 也可能受到影响。(来源:ME)
ME News 消息,9 月 20 日(UTC+8), 慢雾余弦在 X 平台发文表示,相较于 FomoPeek App 在 iPhone 上投毒盗币的案例,更建议关注外卖 App ComeCome 采用类似手法投毒盗币的案例。部分看似正常的 App 可能在使用后导致用户遭遇投毒,且该情况发生在 iPhone 上;建议及时更新 iOS 新版本,iPad 和 Mac 也可能受到影响。(来源:ME)
2
·
--
Ver tradução
ME News 消息,9 月 20 日(UTC+8),据派盾监测,此前攻击 Fetch.ai 和 NuNet 的黑客还利用了 SingularityNET 的漏洞,在以太坊网络上非授权铸造 2.6 亿枚 AGIX 和 5383.8 万枚 WMTX。 该攻击者目前持有价值约 1677 万美元的加密资产,其中包括 1.983 亿枚 AGIX,价值约 1442 万美元;649 枚 ETH,价值约 167 万美元;以及 3353.8 万枚 WMTX,价值约 62.74 万美元。(来源:ME)
ME News 消息,9 月 20 日(UTC+8),据派盾监测,此前攻击 Fetch.ai 和 NuNet 的黑客还利用了 SingularityNET 的漏洞,在以太坊网络上非授权铸造 2.6 亿枚 AGIX 和 5383.8 万枚 WMTX。 该攻击者目前持有价值约 1677 万美元的加密资产,其中包括 1.983 亿枚 AGIX,价值约 1442 万美元;649 枚 ETH,价值约 167 万美元;以及 3353.8 万枚 WMTX,价值约 62.74 万美元。(来源:ME)
12
·
--
Ver tradução
ME News 消息,9 月 20 日(UTC+8),ASI Alliance 发推表示,已获悉一起涉及 FET 代币迁移、跨链桥架构以及该基础设施内其他代币的安全漏洞利用事件。团队已立即采取行动,并正与安全合作伙伴展开协作。未经授权方从转换合约中提取了价值约 156 万美元的 FET。金库和交易所钱包未受影响,用户自托管钱包或存放于交易所的 FET 不受影响,持币人无需采取任何操作;调查完成后将发布完整事件报告。(来源:ME)
ME News 消息,9 月 20 日(UTC+8),ASI Alliance 发推表示,已获悉一起涉及 FET 代币迁移、跨链桥架构以及该基础设施内其他代币的安全漏洞利用事件。团队已立即采取行动,并正与安全合作伙伴展开协作。未经授权方从转换合约中提取了价值约 156 万美元的 FET。金库和交易所钱包未受影响,用户自托管钱包或存放于交易所的 FET 不受影响,持币人无需采取任何操作;调查完成后将发布完整事件报告。(来源:ME)
7
·
--
Ver tradução
ME News 消息,9 月 20 日(UTC+8), Real Vision 创始人 Raoul Pal 表示,比特币兑纳斯达克 100 指数的周线走势已突破下行趋势,预计比特币后续表现将优于纳斯达克 100 指数。 他指出,美联储将利率上调 25 个基点至 3.75%至 4.00%后,比特币价格由约 75580 美元升至 81000 美元上方。Pal 认为,财政主导和债务再融资需求将推动流动性增加,并利好加密资产。(来源:ME)
ME News 消息,9 月 20 日(UTC+8), Real Vision 创始人 Raoul Pal 表示,比特币兑纳斯达克 100 指数的周线走势已突破下行趋势,预计比特币后续表现将优于纳斯达克 100 指数。 他指出,美联储将利率上调 25 个基点至 3.75%至 4.00%后,比特币价格由约 75580 美元升至 81000 美元上方。Pal 认为,财政主导和债务再融资需求将推动流动性增加,并利好加密资产。(来源:ME)
29
·
--
Ver tradução
ME News 消息,9 月 20 日(UTC+8),Multicoin Capital 联合创始人 Tushar Jain 发文表示,当前加密市场情绪略显亢奋,若后续出现回调或一段时间的盘整,其并不会感到意外。 他认为,投资者应拉长观察周期并避免过度交易,因为准确判断每一个短期顶部或底部几乎不可能。相比频繁择时,更可行的方式是持有高质量标的,并等待投资逻辑逐步兑现。(来源:ME)
ME News 消息,9 月 20 日(UTC+8),Multicoin Capital 联合创始人 Tushar Jain 发文表示,当前加密市场情绪略显亢奋,若后续出现回调或一段时间的盘整,其并不会感到意外。 他认为,投资者应拉长观察周期并避免过度交易,因为准确判断每一个短期顶部或底部几乎不可能。相比频繁择时,更可行的方式是持有高质量标的,并等待投资逻辑逐步兑现。(来源:ME)
1
·
--
Artigo
Ver tradução
A社警告:AI催生GDP暴涨32%,美国白领却或被斩杀2030年,可能比你想象中来得更快,也更残酷。
文章作者、来源:新智元
就在刚刚,Anthropic经济团队联合MIT、斯坦福学者发布三种2030经济情景推演。
在最极端剧本里,美国GDP暴增32%,但白领失业率飙到17.9%,资本吃掉55%的增长红利。一万名美国人的调查结果显示,多数人的预期已经滑向了最残酷的那个方向。
这一次,他们没有秀跑分,没有炫耀Claude又超越了GPT几分,而是直接将AI这把手术刀切向了最敏感、最现实的命题:
未来四年,到2030年,AI究竟会让全世界变得更繁荣,还是会让千千万万的脑力劳动者沦为新时代的「经济难民」?
他们将美国劳工部的海量岗位拆解为成千上万个微观任务,用现代宏观经济学的严谨逻辑,为我们推演了2030年的三种未来。
推演的结果令人倒吸一口冷气:
美国富得流油,巨头赚得盆满钵满,蛋糕做大了一倍,但你可能没分到很多蛋糕,甚至成了历史的代价。
三种剧本:2030年的命运沙盘
这套推演不是拍脑袋。
Anthropic团队用的是「基于任务的劳动力模型」,把美国劳工部的海量岗位拆解成成千上万个微观任务,逐个判断哪些能被AI增强、哪些能被彻底替代、哪些完全插不上手。
基于技术演进和落地速度的不同,他们勾勒出走向2030年的三条截然不同的平行宇宙。
温和情景:平稳跨越社会转型
在这个剧本里,AI的落地遭遇了现实世界的摩擦力——算力瓶颈、法规限制、企业组织架构僵化。
经济稳中有升。
AI对生产力的提升类似20世纪90年代的互联网。到2030年,它只给美国GDP额外带来约1.6%的增长,经济总量温和上升至34.1万亿美元。
劳动力市场几乎没有变化。
整体失业率只微幅上浮0.1%,大家的工作节奏几乎没有颠覆性变化。
打工人的工资稳中有升,劳动所得依然牢牢占据国民总收入的60%左右。
只有0.3%等知识工作者转行到其他行业。
现实中,AI成了升级版的Office套件,人人都会用两下,但没人因此丢掉饭碗。技术乐观派欢呼雀跃,社会平稳跨过转型期。
但这仅仅是「最保守」的推测。
显著情景:白领停滞、蓝领逆袭的大平替
在这个剧本里,技术不再是点缀,而是真正的替代者。
AI系统已经能够独立、自主地完成人类近一半的知识与脑力工作,从基础代码编写、日常法务合同审查,到财务审计、初级文案、数据分析。
经济到2030年,AI为GDP额外贡献了8.3%的增长,经济总量跃升至36.3万亿美元。生产力大幅跃升,企业效率肉眼可见地飞涨。
同时,出现史诗级分化奇观:
知识工作者(白领)工资曲线彻底「趴平」,几乎零增长,认知类岗位招聘需求萎缩约4%。初级分析师、文案策划、普通程序员成了冗余资产,许多人被迫离开舒适的写字楼。
而蓝领/现场服务等非知识工作者,比如水管工、电工、重型机械操作员、护士、养老照护人员等薪资不仅没有下降,反而逆势上扬。
因为物理世界的脏活、累活、需要温度的情感照护,AI和机器人一时半会儿啃不下来,社会财富增加后,对这些「真人体感服务」的需求反而激增。
坐在高档写字楼里喝咖啡的白领,猛然发现自己年终奖被砍、跳槽无门;而楼下上门修电路师傅的时薪,已经悄悄涨到了自己的两倍。
极端情景:财富的黄金时代,白领的「至暗之夜」
这是最让人脊背发凉、却也最符合技术指数级爆发逻辑的剧本。
在这个场景下,AI的技术迭代跨越了临界点。
绝大多数脑力劳动被完全接管,AI以近乎零边际成本的效率,不知疲倦、不分昼夜地运行在数据中心。
人类将目睹历史上从未发生过的增长奇迹——年化GDP增速狂飙至15%,全美经济总量暴涨超32%,达到44.4万亿美元,经济体量每4.5年就能翻一番!
这种增速,哪怕在人类工业革命和二战后的战后重建期,都闻所未闻。
然而,分配天平彻底失衡:
知识工作者的失业率直接飙升至17.9%!
这一数字,甚至超越了2008年次贷危机,接近1930年代大萧条的极端水平。
13.5%的「白领岗位」被取代,8.3%的知识工作者或将彻底转型。
幸存下来的白领,薪资也被迫断崖式下跌超过10%。
资本与劳动则出现世纪逆转: 劳动所得占全社会收入的比重,从传统的近60%一路溃跌至45.2%。
反过来,资本所得的占比从40%一路暴冲到近55%。
这意味着什么?
全社会的蛋糕确实做大了整整一倍,但切蛋糕的刀,已经彻底移交到了极少数人手里。
算力的拥有者、模型的所有者、手握核心资本的大股东,瓜分了经济暴涨的绝大部分红利;而曾经自诩为社会中产中坚的程序员、律师助理、咨询师、中层管理人员,却在机器的轰鸣声中沦为过剩运力,排队领救济金。
一万名普通人的直觉:我们正走向哪个未来?
但问题来了:普通人觉得自己正走向哪个未来?
Anthropic联合Morning Consult对全美10980名成年人做了调查。
结果一万多人的中位数预期,精准落在了剧本二甚至略偏剧本三的区间。
将近10%的人直接认同最极端的那个版本。
这个数字说明一件事:前线的职场人早在日常的缩招通知和降本增效KPI里,闻到了铁锈味。
这份报告还揭示了一个反直觉的逻辑:过去两百年,机器替代的都是体力劳动,脑力劳动者反而因此受益。但AI这一次翻转了——越是纯认知、纯信息处理的工作,越容易被接管;反而是需要到现场、用双手、跟人打交道的活儿,AI暂时够不着。
「越聪明,越危险」,这可能是工业革命以来第一次。
Anthropic表示将据此推动政策研究,确保AI经济红利被广泛分享。但模型已经摆在那里了——接下来盯的不是AI能不能做到,而是做到之后,谁来重新分蛋糕。
敲响警钟之后:我们还有多少时间?
为什么Anthropic——一家靠卖大模型赚钱的独角兽,要在此时此刻把这份看似「唱衰打工人」的报告公之于众?
正如该团队在报告末尾写道:「我们的目的不是为了制造恐慌,而是为了在未来被固化之前,让全社会看清政策与分配的方向。」
当一家AI头部实验室开始谈论「如何确保AI经济红利被广泛分享」、甚至倒逼政策制定者去研究再分配机制时,它传达的信号已经无比清晰:
技术的列车已经冲出车站,原有的利益分配机制即将散架。
如果任由「剧本三」野蛮生长,社会的结局绝不是乌托邦,而是撕裂:一边是市值数万亿美元、富可敌国的少数超级AI寡头,另一边是被剥夺了劳动定价权的庞大失业中产。
这也正是为什么,全球范围内关于「AI暴利税」、「算力资产全民分红」、乃至「全民基本收入(UBI)」的讨论,正在从边缘学术狂想,迅速转变为顶级政策智库的必修课题。
风暴来临前,普通人该怎么活?
距离2030年,满打满算,只剩下四年左右的时间。
如果说过去两年我们还在围观大模型的「奇技淫巧」,那么Anthropic的这份沙盘,已经把我们每个人未来几年的生存底牌摊在了桌面上。
面对这场即将到来的大分流,普通人绝不能成为坐在温水里的青蛙:
告别对「纯知识记忆与加工」的迷信。
向「物理世界」与「真实信任」靠拢:「走下云端,脚踩泥土」,与真实世界和活生生的人建立高摩擦力的连接,会是你最好的壁垒。
从纯粹的「打工人」,向「资产与算力所有者」转身: 但然劳动所得在缩水,资本所得在膨胀,那么哪怕每个月挤出一点积蓄,去配置那些代表生产力底层方向的资产,也比单纯把自己的命运绑在脆弱的工位上要明智得多。
时代抛弃一个群体时,从来不会提前发离职补偿金,甚至连一句招呼都不会打。
A社警告:AI催生GDP暴涨32%,美国白领却或被斩杀
2030年,可能比你想象中来得更快,也更残酷。
文章作者、来源:新智元
就在刚刚,Anthropic经济团队联合MIT、斯坦福学者发布三种2030经济情景推演。
在最极端剧本里,美国GDP暴增32%,但白领失业率飙到17.9%,资本吃掉55%的增长红利。一万名美国人的调查结果显示,多数人的预期已经滑向了最残酷的那个方向。
这一次,他们没有秀跑分,没有炫耀Claude又超越了GPT几分,而是直接将AI这把手术刀切向了最敏感、最现实的命题:
未来四年,到2030年,AI究竟会让全世界变得更繁荣,还是会让千千万万的脑力劳动者沦为新时代的「经济难民」?
他们将美国劳工部的海量岗位拆解为成千上万个微观任务,用现代宏观经济学的严谨逻辑,为我们推演了2030年的三种未来。
推演的结果令人倒吸一口冷气:
美国富得流油,巨头赚得盆满钵满,蛋糕做大了一倍,但你可能没分到很多蛋糕,甚至成了历史的代价。
三种剧本:2030年的命运沙盘
这套推演不是拍脑袋。
Anthropic团队用的是「基于任务的劳动力模型」,把美国劳工部的海量岗位拆解成成千上万个微观任务,逐个判断哪些能被AI增强、哪些能被彻底替代、哪些完全插不上手。
基于技术演进和落地速度的不同,他们勾勒出走向2030年的三条截然不同的平行宇宙。
温和情景:平稳跨越社会转型
在这个剧本里,AI的落地遭遇了现实世界的摩擦力——算力瓶颈、法规限制、企业组织架构僵化。
经济稳中有升。
AI对生产力的提升类似20世纪90年代的互联网。到2030年,它只给美国GDP额外带来约1.6%的增长,经济总量温和上升至34.1万亿美元。
劳动力市场几乎没有变化。
整体失业率只微幅上浮0.1%,大家的工作节奏几乎没有颠覆性变化。
打工人的工资稳中有升,劳动所得依然牢牢占据国民总收入的60%左右。
只有0.3%等知识工作者转行到其他行业。
现实中,AI成了升级版的Office套件,人人都会用两下,但没人因此丢掉饭碗。技术乐观派欢呼雀跃,社会平稳跨过转型期。
但这仅仅是「最保守」的推测。
显著情景:白领停滞、蓝领逆袭的大平替
在这个剧本里,技术不再是点缀,而是真正的替代者。
AI系统已经能够独立、自主地完成人类近一半的知识与脑力工作,从基础代码编写、日常法务合同审查,到财务审计、初级文案、数据分析。
经济到2030年,AI为GDP额外贡献了8.3%的增长,经济总量跃升至36.3万亿美元。生产力大幅跃升,企业效率肉眼可见地飞涨。
同时,出现史诗级分化奇观:
知识工作者(白领)工资曲线彻底「趴平」,几乎零增长,认知类岗位招聘需求萎缩约4%。初级分析师、文案策划、普通程序员成了冗余资产,许多人被迫离开舒适的写字楼。
而蓝领/现场服务等非知识工作者,比如水管工、电工、重型机械操作员、护士、养老照护人员等薪资不仅没有下降,反而逆势上扬。
因为物理世界的脏活、累活、需要温度的情感照护,AI和机器人一时半会儿啃不下来,社会财富增加后,对这些「真人体感服务」的需求反而激增。
坐在高档写字楼里喝咖啡的白领,猛然发现自己年终奖被砍、跳槽无门;而楼下上门修电路师傅的时薪,已经悄悄涨到了自己的两倍。
极端情景:财富的黄金时代,白领的「至暗之夜」
这是最让人脊背发凉、却也最符合技术指数级爆发逻辑的剧本。
在这个场景下,AI的技术迭代跨越了临界点。
绝大多数脑力劳动被完全接管,AI以近乎零边际成本的效率,不知疲倦、不分昼夜地运行在数据中心。
人类将目睹历史上从未发生过的增长奇迹——年化GDP增速狂飙至15%,全美经济总量暴涨超32%,达到44.4万亿美元,经济体量每4.5年就能翻一番!
这种增速,哪怕在人类工业革命和二战后的战后重建期,都闻所未闻。
然而,分配天平彻底失衡:
知识工作者的失业率直接飙升至17.9%!
这一数字,甚至超越了2008年次贷危机,接近1930年代大萧条的极端水平。
13.5%的「白领岗位」被取代,8.3%的知识工作者或将彻底转型。
幸存下来的白领,薪资也被迫断崖式下跌超过10%。
资本与劳动则出现世纪逆转: 劳动所得占全社会收入的比重,从传统的近60%一路溃跌至45.2%。
反过来,资本所得的占比从40%一路暴冲到近55%。
这意味着什么?
全社会的蛋糕确实做大了整整一倍,但切蛋糕的刀,已经彻底移交到了极少数人手里。
算力的拥有者、模型的所有者、手握核心资本的大股东,瓜分了经济暴涨的绝大部分红利;而曾经自诩为社会中产中坚的程序员、律师助理、咨询师、中层管理人员,却在机器的轰鸣声中沦为过剩运力,排队领救济金。
一万名普通人的直觉:我们正走向哪个未来?
但问题来了:普通人觉得自己正走向哪个未来?
Anthropic联合Morning Consult对全美10980名成年人做了调查。
结果一万多人的中位数预期,精准落在了剧本二甚至略偏剧本三的区间。
将近10%的人直接认同最极端的那个版本。
这个数字说明一件事:前线的职场人早在日常的缩招通知和降本增效KPI里,闻到了铁锈味。
这份报告还揭示了一个反直觉的逻辑:过去两百年,机器替代的都是体力劳动,脑力劳动者反而因此受益。但AI这一次翻转了——越是纯认知、纯信息处理的工作,越容易被接管;反而是需要到现场、用双手、跟人打交道的活儿,AI暂时够不着。
「越聪明,越危险」,这可能是工业革命以来第一次。
Anthropic表示将据此推动政策研究,确保AI经济红利被广泛分享。但模型已经摆在那里了——接下来盯的不是AI能不能做到,而是做到之后,谁来重新分蛋糕。
敲响警钟之后:我们还有多少时间?
为什么Anthropic——一家靠卖大模型赚钱的独角兽,要在此时此刻把这份看似「唱衰打工人」的报告公之于众?
正如该团队在报告末尾写道:「我们的目的不是为了制造恐慌,而是为了在未来被固化之前,让全社会看清政策与分配的方向。」
当一家AI头部实验室开始谈论「如何确保AI经济红利被广泛分享」、甚至倒逼政策制定者去研究再分配机制时,它传达的信号已经无比清晰:
技术的列车已经冲出车站,原有的利益分配机制即将散架。
如果任由「剧本三」野蛮生长,社会的结局绝不是乌托邦,而是撕裂:一边是市值数万亿美元、富可敌国的少数超级AI寡头,另一边是被剥夺了劳动定价权的庞大失业中产。
这也正是为什么,全球范围内关于「AI暴利税」、「算力资产全民分红」、乃至「全民基本收入(UBI)」的讨论,正在从边缘学术狂想,迅速转变为顶级政策智库的必修课题。
风暴来临前,普通人该怎么活?
距离2030年,满打满算,只剩下四年左右的时间。
如果说过去两年我们还在围观大模型的「奇技淫巧」,那么Anthropic的这份沙盘,已经把我们每个人未来几年的生存底牌摊在了桌面上。
面对这场即将到来的大分流,普通人绝不能成为坐在温水里的青蛙:
告别对「纯知识记忆与加工」的迷信。
向「物理世界」与「真实信任」靠拢:「走下云端,脚踩泥土」,与真实世界和活生生的人建立高摩擦力的连接,会是你最好的壁垒。
从纯粹的「打工人」,向「资产与算力所有者」转身: 但然劳动所得在缩水,资本所得在膨胀,那么哪怕每个月挤出一点积蓄,去配置那些代表生产力底层方向的资产,也比单纯把自己的命运绑在脆弱的工位上要明智得多。
时代抛弃一个群体时,从来不会提前发离职补偿金,甚至连一句招呼都不会打。
文章作者、来源:新智元
就在刚刚,Anthropic经济团队联合MIT、斯坦福学者发布三种2030经济情景推演。
在最极端剧本里,美国GDP暴增32%,但白领失业率飙到17.9%,资本吃掉55%的增长红利。一万名美国人的调查结果显示,多数人的预期已经滑向了最残酷的那个方向。
这一次,他们没有秀跑分,没有炫耀Claude又超越了GPT几分,而是直接将AI这把手术刀切向了最敏感、最现实的命题:
未来四年,到2030年,AI究竟会让全世界变得更繁荣,还是会让千千万万的脑力劳动者沦为新时代的「经济难民」?
他们将美国劳工部的海量岗位拆解为成千上万个微观任务,用现代宏观经济学的严谨逻辑,为我们推演了2030年的三种未来。
推演的结果令人倒吸一口冷气:
美国富得流油,巨头赚得盆满钵满,蛋糕做大了一倍,但你可能没分到很多蛋糕,甚至成了历史的代价。
三种剧本:2030年的命运沙盘
这套推演不是拍脑袋。
Anthropic团队用的是「基于任务的劳动力模型」,把美国劳工部的海量岗位拆解成成千上万个微观任务,逐个判断哪些能被AI增强、哪些能被彻底替代、哪些完全插不上手。
基于技术演进和落地速度的不同,他们勾勒出走向2030年的三条截然不同的平行宇宙。
温和情景:平稳跨越社会转型
在这个剧本里,AI的落地遭遇了现实世界的摩擦力——算力瓶颈、法规限制、企业组织架构僵化。
经济稳中有升。
AI对生产力的提升类似20世纪90年代的互联网。到2030年,它只给美国GDP额外带来约1.6%的增长,经济总量温和上升至34.1万亿美元。
劳动力市场几乎没有变化。
整体失业率只微幅上浮0.1%,大家的工作节奏几乎没有颠覆性变化。
打工人的工资稳中有升,劳动所得依然牢牢占据国民总收入的60%左右。
只有0.3%等知识工作者转行到其他行业。
现实中,AI成了升级版的Office套件,人人都会用两下,但没人因此丢掉饭碗。技术乐观派欢呼雀跃,社会平稳跨过转型期。
但这仅仅是「最保守」的推测。
显著情景:白领停滞、蓝领逆袭的大平替
在这个剧本里,技术不再是点缀,而是真正的替代者。
AI系统已经能够独立、自主地完成人类近一半的知识与脑力工作,从基础代码编写、日常法务合同审查,到财务审计、初级文案、数据分析。
经济到2030年,AI为GDP额外贡献了8.3%的增长,经济总量跃升至36.3万亿美元。生产力大幅跃升,企业效率肉眼可见地飞涨。
同时,出现史诗级分化奇观:
知识工作者(白领)工资曲线彻底「趴平」,几乎零增长,认知类岗位招聘需求萎缩约4%。初级分析师、文案策划、普通程序员成了冗余资产,许多人被迫离开舒适的写字楼。
而蓝领/现场服务等非知识工作者,比如水管工、电工、重型机械操作员、护士、养老照护人员等薪资不仅没有下降,反而逆势上扬。
因为物理世界的脏活、累活、需要温度的情感照护,AI和机器人一时半会儿啃不下来,社会财富增加后,对这些「真人体感服务」的需求反而激增。
坐在高档写字楼里喝咖啡的白领,猛然发现自己年终奖被砍、跳槽无门;而楼下上门修电路师傅的时薪,已经悄悄涨到了自己的两倍。
极端情景:财富的黄金时代,白领的「至暗之夜」
这是最让人脊背发凉、却也最符合技术指数级爆发逻辑的剧本。
在这个场景下,AI的技术迭代跨越了临界点。
绝大多数脑力劳动被完全接管,AI以近乎零边际成本的效率,不知疲倦、不分昼夜地运行在数据中心。
人类将目睹历史上从未发生过的增长奇迹——年化GDP增速狂飙至15%,全美经济总量暴涨超32%,达到44.4万亿美元,经济体量每4.5年就能翻一番!
这种增速,哪怕在人类工业革命和二战后的战后重建期,都闻所未闻。
然而,分配天平彻底失衡:
知识工作者的失业率直接飙升至17.9%!
这一数字,甚至超越了2008年次贷危机,接近1930年代大萧条的极端水平。
13.5%的「白领岗位」被取代,8.3%的知识工作者或将彻底转型。
幸存下来的白领,薪资也被迫断崖式下跌超过10%。
资本与劳动则出现世纪逆转: 劳动所得占全社会收入的比重,从传统的近60%一路溃跌至45.2%。
反过来,资本所得的占比从40%一路暴冲到近55%。
这意味着什么?
全社会的蛋糕确实做大了整整一倍,但切蛋糕的刀,已经彻底移交到了极少数人手里。
算力的拥有者、模型的所有者、手握核心资本的大股东,瓜分了经济暴涨的绝大部分红利;而曾经自诩为社会中产中坚的程序员、律师助理、咨询师、中层管理人员,却在机器的轰鸣声中沦为过剩运力,排队领救济金。
一万名普通人的直觉:我们正走向哪个未来?
但问题来了:普通人觉得自己正走向哪个未来?
Anthropic联合Morning Consult对全美10980名成年人做了调查。
结果一万多人的中位数预期,精准落在了剧本二甚至略偏剧本三的区间。
将近10%的人直接认同最极端的那个版本。
这个数字说明一件事:前线的职场人早在日常的缩招通知和降本增效KPI里,闻到了铁锈味。
这份报告还揭示了一个反直觉的逻辑:过去两百年,机器替代的都是体力劳动,脑力劳动者反而因此受益。但AI这一次翻转了——越是纯认知、纯信息处理的工作,越容易被接管;反而是需要到现场、用双手、跟人打交道的活儿,AI暂时够不着。
「越聪明,越危险」,这可能是工业革命以来第一次。
Anthropic表示将据此推动政策研究,确保AI经济红利被广泛分享。但模型已经摆在那里了——接下来盯的不是AI能不能做到,而是做到之后,谁来重新分蛋糕。
敲响警钟之后:我们还有多少时间?
为什么Anthropic——一家靠卖大模型赚钱的独角兽,要在此时此刻把这份看似「唱衰打工人」的报告公之于众?
正如该团队在报告末尾写道:「我们的目的不是为了制造恐慌,而是为了在未来被固化之前,让全社会看清政策与分配的方向。」
当一家AI头部实验室开始谈论「如何确保AI经济红利被广泛分享」、甚至倒逼政策制定者去研究再分配机制时,它传达的信号已经无比清晰:
技术的列车已经冲出车站,原有的利益分配机制即将散架。
如果任由「剧本三」野蛮生长,社会的结局绝不是乌托邦,而是撕裂:一边是市值数万亿美元、富可敌国的少数超级AI寡头,另一边是被剥夺了劳动定价权的庞大失业中产。
这也正是为什么,全球范围内关于「AI暴利税」、「算力资产全民分红」、乃至「全民基本收入(UBI)」的讨论,正在从边缘学术狂想,迅速转变为顶级政策智库的必修课题。
风暴来临前,普通人该怎么活?
距离2030年,满打满算,只剩下四年左右的时间。
如果说过去两年我们还在围观大模型的「奇技淫巧」,那么Anthropic的这份沙盘,已经把我们每个人未来几年的生存底牌摊在了桌面上。
面对这场即将到来的大分流,普通人绝不能成为坐在温水里的青蛙:
告别对「纯知识记忆与加工」的迷信。
向「物理世界」与「真实信任」靠拢:「走下云端,脚踩泥土」,与真实世界和活生生的人建立高摩擦力的连接,会是你最好的壁垒。
从纯粹的「打工人」,向「资产与算力所有者」转身: 但然劳动所得在缩水,资本所得在膨胀,那么哪怕每个月挤出一点积蓄,去配置那些代表生产力底层方向的资产,也比单纯把自己的命运绑在脆弱的工位上要明智得多。
时代抛弃一个群体时,从来不会提前发离职补偿金,甚至连一句招呼都不会打。
7
·
--
Ver tradução
ME AI 消息,AI模型资讯账号TestingCatalog表示,StepFun已发布Step 5 Preview,这是一款总参数600B、激活参数27B并支持100万上下文窗口的MoE模型,具备视觉能力以及软件工程和金融任务处理能力,现已通过StepFun AI Studio和API提供。(来源:ME)
ME AI 消息,AI模型资讯账号TestingCatalog表示,StepFun已发布Step 5 Preview,这是一款总参数600B、激活参数27B并支持100万上下文窗口的MoE模型,具备视觉能力以及软件工程和金融任务处理能力,现已通过StepFun AI Studio和API提供。(来源:ME)
13
·
--
Ver tradução
ME AI 消息,AI研究与自然语言处理领域账号dongxi_nlp表示,arXiv上超过300万篇论文已被完整整理为Hugging Face数据集,并称ICLR 2027的投稿量可能超过往年总和,AI研究数据与论文规模仍在持续增长。(来源:ME)
ME AI 消息,AI研究与自然语言处理领域账号dongxi_nlp表示,arXiv上超过300万篇论文已被完整整理为Hugging Face数据集,并称ICLR 2027的投稿量可能超过往年总和,AI研究数据与论文规模仍在持续增长。(来源:ME)
7
·
--
Ver tradução
ME AI 消息,OpenBMB表示,利用端侧AI分析植物照片并帮助农民作出更好的决策,是更具实际价值的本地化应用。其指出,将模型Top-1准确率从80.2%提升至90%以上,并通过简易手机界面服务农民,展现了该技术的应用潜力。(来源:ME)
ME AI 消息,OpenBMB表示,利用端侧AI分析植物照片并帮助农民作出更好的决策,是更具实际价值的本地化应用。其指出,将模型Top-1准确率从80.2%提升至90%以上,并通过简易手机界面服务农民,展现了该技术的应用潜力。(来源:ME)
7
·
--
Ver tradução
Fetch.ai 发布链上攻击分析,并与 SingularityNET 联合停用受影响钱包及合约ME News 消息,9 月 20 日(UTC+8),Fetch.ai 发推表示,已在 ASI:One 平台发布本次攻击事件的链上分析报告,追踪了从签名密钥被盗到攻击者套现钱包的完整路径,并注明该报告并非最终版本。据报告披露,此次攻击根因为 SingularityNET 跨链桥后端授权签名密钥被盗,攻击者利用该密钥生成合法签名,通过 conversionIn 函数一笔清空合约内全部 8,721,530 枚 FET(约 155 万美元)。与此同时,NuNet 铸币密钥亦遭盗用,攻击者据此铸造约 4.085 亿枚 NTX(约占总供应量 42%),两条攻击路径系同一分钟协调发起。截至报告发布时,攻击者约 547.89 枚 ETH 及 2.3 亿枚 NTX 仍集中存放于同一钱包。 Fetch.ai 同时宣布,已与 SingularityNET 联合停用受影响的钱包及合约,后续调查进展将持续更新。(来源:ME)
Fetch.ai 发布链上攻击分析,并与 SingularityNET 联合停用受影响钱包及合约
ME News 消息,9 月 20 日(UTC+8),Fetch.ai 发推表示,已在 ASI:One 平台发布本次攻击事件的链上分析报告,追踪了从签名密钥被盗到攻击者套现钱包的完整路径,并注明该报告并非最终版本。据报告披露,此次攻击根因为 SingularityNET 跨链桥后端授权签名密钥被盗,攻击者利用该密钥生成合法签名,通过 conversionIn 函数一笔清空合约内全部 8,721,530 枚 FET(约 155 万美元)。与此同时,NuNet 铸币密钥亦遭盗用,攻击者据此铸造约 4.085 亿枚 NTX(约占总供应量 42%),两条攻击路径系同一分钟协调发起。截至报告发布时,攻击者约 547.89 枚 ETH 及 2.3 亿枚 NTX 仍集中存放于同一钱包。 Fetch.ai 同时宣布,已与 SingularityNET 联合停用受影响的钱包及合约,后续调查进展将持续更新。(来源:ME)
105
·
--
Ver tradução
融资续命失败,昔日明星公链Linera黯然退场,撸毛党三年“苦工”白打了Linera的失败反映了公链竞争加剧背景下,单纯依靠融资和技术叙事已难以支撑项目生存,可持续造血能力正成为行业新考验。
文章作者:Nancy
文章来源:PANews
Linera曾是撸毛党的集体回忆。这个曾凭借空投预期吊足社区胃口、主网迟迟未能上线的明星L1,最终在紧急融资失败后黯然退场。
随着公链关停潮蔓延,Linera的停运再次敲响警钟,精英团队、明星资本与宏大叙事,已不足以支撑市场信心。
募资门槛降低仍难被买账,昔日明星L1走向关停
时隔许久,Linera再次被大范围提起,不是因为主网上线,也不是因为空投规则,而是因为关停。
上月底,Linera高调宣称要打造“下一个Hyperliquid”,并预告即将启动LNRA代币销售。9月1日,Linera正式开启LNRA社区轮公募,代币定价0.16美元,对应1.6亿美元FDV,同时为早期参与者提供低至0.02美元的优惠价格。
然而,市场反应远不及预期。社区轮认购进展缓慢,整体热度明显不足。最终,来自69个国家和地区的617名参与者承诺认购约84.8万美元,不仅远低于800万美元的募资上限,甚至未能达到150万美元的最低募资目标。尽管此次公募规模相比过去动辄数千万美元的加密项目融资并不算高,但Linera依然未能完成最低募资要求,市场冷淡程度可见一斑。
9月19日,Linera创始人Mathieu Baudet在Discord宣布,由于LNRA代币销售未达到完成销售所需的最低金额,所有认购款项均已退还,项目将立即停止运营。此前团队曾尝试筹集紧急资金,以维持运营至主网上线,但未能筹集到所需资金,最终导致项目关闭。
从高调预告代币销售,到因募资未达标而停止运营,Linera的突然关停也让市场颇感意外,也让不少撸毛用户多年的等待化为泡影。从测试网交互、做任务,到收集徽章、参加周会、积累Discord角色,围绕Linera生态的长期参与,曾成为不少社区用户的日常。如今项目突然停摆,这些投入却并未得到回报。
有用户在社交平台发文称,自己过去3年持续参与Linera生态交互,累计投入约4万至8万个MGS,发布100余条内容,参加69场社区活动并领取30枚徽章,但最终“收益为0”,甚至没有等到空投查询的机会。
也有用户质疑,Linera背后曾获得a16z等一线风投支持,但项目历经数年仍未正式上线主网,最终却因资金问题走向关停,“四年还没上主网就资金耗尽,下一个会是谁?”类似声音开始在社区蔓延。更有用户直言,“VC把鬼链甩给散户然后走人”,也有人感叹,“我们刷的是积分,Linera刷走的却是我们的时间。”
更有社区用户将Hyperliquid和Linera进行对比,认为前者是产品先跑出来、资金随后涌入,而Linera则更像是“故事先讲满”,最终却需要依靠社区轮融资维持运营。
如今的Linera,或许很难再与明星L1联系在一起。但自项目2022年启动以来,从团队背景到融资阵容,再到Move生态叙事,Linera几乎集齐了当时热门公链的多个标签。即便尚未真正进入大规模应用阶段,Linera依然获得足够的市场关注和社区期待。
Linera由Meta前研究员Mathieu Baudet创立,创始团队的背景使项目自诞生起便自带话题度,并一度与Aptos、Sui并称为“Move三杰”。2022年和2023年,Linera先后完成两轮融资,总融资规模约1200万美元,a16z连续参与投资,其他投资方还包括Borderless Capital、GSR、Matrixport Ventures和Flow Traders等,资本阵容颇为亮眼。然而,这些光环却并未成为Linera穿越周期的护城河。
目前,Linera正逐步关闭应用及Discord社区。用户积分余额仍会保留记录,但团队无法承诺这些积分未来能够兑换任何权益。至于协议开发和应用上线,团队表示仍希望未来继续推进,却暂时无法给出明确时间表。
公链开启生存战,可持续造血能力成关键
Linera的谢幕看似突然,却并非毫无征兆。
当越来越多公链从高光走向沉寂,甚至被迫关停或转型,行业正在经历的或许不只是一轮市场调整,更是一场围绕流动性、商业模式与价值捕获的重新审视。
近几个月来,Harmony、Scroll、Moonbeam、Secret Network、Saga、Vanar、Zero等Layer1和Layer2项目陆续宣布关停或转型,其中不乏曾经备受关注的行业先锋。它们曾凭借技术叙事、融资阵容和生态激励吸引市场目光,也一度积累起可观的链上流动性。然而,当市场热度褪去,激励逐渐退场,其交易量和用户活跃度开始断崖式下滑,甚至沦为名副其实的“鬼链”。
尤其是在Robinhood Chain等背靠传统巨头的新链入局后,为市场资金和用户提供了更多选择,加速了不同生态之间的流动性迁移。对于缺乏差异化优势的公链而言,一旦用户和资金流失,想要重新建立生态往往需要付出更高的成本。
头部效应之下,中小公链面临的生存压力进一步加大。DeFiLlama数据显示,以太坊、Solana、Base、BNB Chain等前十大公链占据了公链市场约九成的份额。在这样的竞争格局中,单纯依靠新链叙事、短期激励或代币发行吸引资金,已越来越难以形成长期优势。
面对日益激烈的竞争,公链的发展路径也开始出现分化。相较于试图覆盖所有应用场景的通用型公链,围绕特定需求、以实际应用带动用户和流动性的垂直公链,正成为行业主流探索方向。一些老牌公链也开始转向AI、支付等细分赛道,试图通过差异化定位寻找新的增长空间。
但无论选择哪条路线,都需要建立可持续的商业模式。对于缺乏持续收入来源的加密项目而言,融资储备和代币销售所得或许能够在短期内支撑团队运转,却难以替代稳定的经营现金流。一旦融资受阻、资金储备持续消耗,项目便可能被迫削减开支、缩减开发,甚至最终关停。Linera的经历正是一个现实案例,融资可以为项目争取时间,却无法无限期替代自身造血能力。
更值得关注的是,市场对公链的价值评估逻辑也在发生变化。过去,技术叙事、融资阵容、生态规模和空投预期,往往足以为项目带来关注与估值溢价。但随着越来越多项目进入实际运营阶段,市场开始重新审视这些增长究竟有多少来自真实需求,又有多少依赖短期激励。
虽然链上交易量和TVL仍是衡量生态规模与用户活跃度的重要指标,但并不必然意味着项目具备可持续的盈利能力。对于投资者而言,协议能否持续创造收入,以及这些收入能否有效传导至代币持有者,也逐渐成为评估项目的重要维度。
近期,Hyperliquid、Uniswap、NEAR、Venice、Arbitrum、Aave、Lighter等代币的强势表现,也进一步体现了市场对协议收入与代币激励对齐的重视。
正因如此,当前越来越多加密项目开始尝试通过代币回购销毁等方式,将协议经营活动与代币价值联系起来。据Unfolded数据,加密项目今年迄今已花费6.38亿美元用于代币回购,高于去年同期的5.45亿美元,而2024年同期仅为36.6万美元。其中,Hyperliquid和Pump.fun合计占近90%。
但回购本身并不等同于可持续的价值捕获。其实际效果仍取决于资金来源、回购规模、代币总供给变化,以及项目未来能否持续创造收入。若缺乏稳定的经营现金流,回购也可能只是阶段性的价值支出,难以成为长期支撑。
归根结底,当叙事与技术光环不再足以吸引流动性,公链竞争正在从争夺流量与市场关注,转向对真实需求、持续收入和价值回馈能力的考验。
融资续命失败,昔日明星公链Linera黯然退场,撸毛党三年“苦工”白打了
Linera的失败反映了公链竞争加剧背景下,单纯依靠融资和技术叙事已难以支撑项目生存,可持续造血能力正成为行业新考验。
文章作者:Nancy
文章来源:PANews
Linera曾是撸毛党的集体回忆。这个曾凭借空投预期吊足社区胃口、主网迟迟未能上线的明星L1,最终在紧急融资失败后黯然退场。
随着公链关停潮蔓延,Linera的停运再次敲响警钟,精英团队、明星资本与宏大叙事,已不足以支撑市场信心。
募资门槛降低仍难被买账,昔日明星L1走向关停
时隔许久,Linera再次被大范围提起,不是因为主网上线,也不是因为空投规则,而是因为关停。
上月底,Linera高调宣称要打造“下一个Hyperliquid”,并预告即将启动LNRA代币销售。9月1日,Linera正式开启LNRA社区轮公募,代币定价0.16美元,对应1.6亿美元FDV,同时为早期参与者提供低至0.02美元的优惠价格。
然而,市场反应远不及预期。社区轮认购进展缓慢,整体热度明显不足。最终,来自69个国家和地区的617名参与者承诺认购约84.8万美元,不仅远低于800万美元的募资上限,甚至未能达到150万美元的最低募资目标。尽管此次公募规模相比过去动辄数千万美元的加密项目融资并不算高,但Linera依然未能完成最低募资要求,市场冷淡程度可见一斑。
9月19日,Linera创始人Mathieu Baudet在Discord宣布,由于LNRA代币销售未达到完成销售所需的最低金额,所有认购款项均已退还,项目将立即停止运营。此前团队曾尝试筹集紧急资金,以维持运营至主网上线,但未能筹集到所需资金,最终导致项目关闭。
从高调预告代币销售,到因募资未达标而停止运营,Linera的突然关停也让市场颇感意外,也让不少撸毛用户多年的等待化为泡影。从测试网交互、做任务,到收集徽章、参加周会、积累Discord角色,围绕Linera生态的长期参与,曾成为不少社区用户的日常。如今项目突然停摆,这些投入却并未得到回报。
有用户在社交平台发文称,自己过去3年持续参与Linera生态交互,累计投入约4万至8万个MGS,发布100余条内容,参加69场社区活动并领取30枚徽章,但最终“收益为0”,甚至没有等到空投查询的机会。
也有用户质疑,Linera背后曾获得a16z等一线风投支持,但项目历经数年仍未正式上线主网,最终却因资金问题走向关停,“四年还没上主网就资金耗尽,下一个会是谁?”类似声音开始在社区蔓延。更有用户直言,“VC把鬼链甩给散户然后走人”,也有人感叹,“我们刷的是积分,Linera刷走的却是我们的时间。”
更有社区用户将Hyperliquid和Linera进行对比,认为前者是产品先跑出来、资金随后涌入,而Linera则更像是“故事先讲满”,最终却需要依靠社区轮融资维持运营。
如今的Linera,或许很难再与明星L1联系在一起。但自项目2022年启动以来,从团队背景到融资阵容,再到Move生态叙事,Linera几乎集齐了当时热门公链的多个标签。即便尚未真正进入大规模应用阶段,Linera依然获得足够的市场关注和社区期待。
Linera由Meta前研究员Mathieu Baudet创立,创始团队的背景使项目自诞生起便自带话题度,并一度与Aptos、Sui并称为“Move三杰”。2022年和2023年,Linera先后完成两轮融资,总融资规模约1200万美元,a16z连续参与投资,其他投资方还包括Borderless Capital、GSR、Matrixport Ventures和Flow Traders等,资本阵容颇为亮眼。然而,这些光环却并未成为Linera穿越周期的护城河。
目前,Linera正逐步关闭应用及Discord社区。用户积分余额仍会保留记录,但团队无法承诺这些积分未来能够兑换任何权益。至于协议开发和应用上线,团队表示仍希望未来继续推进,却暂时无法给出明确时间表。
公链开启生存战,可持续造血能力成关键
Linera的谢幕看似突然,却并非毫无征兆。
当越来越多公链从高光走向沉寂,甚至被迫关停或转型,行业正在经历的或许不只是一轮市场调整,更是一场围绕流动性、商业模式与价值捕获的重新审视。
近几个月来,Harmony、Scroll、Moonbeam、Secret Network、Saga、Vanar、Zero等Layer1和Layer2项目陆续宣布关停或转型,其中不乏曾经备受关注的行业先锋。它们曾凭借技术叙事、融资阵容和生态激励吸引市场目光,也一度积累起可观的链上流动性。然而,当市场热度褪去,激励逐渐退场,其交易量和用户活跃度开始断崖式下滑,甚至沦为名副其实的“鬼链”。
尤其是在Robinhood Chain等背靠传统巨头的新链入局后,为市场资金和用户提供了更多选择,加速了不同生态之间的流动性迁移。对于缺乏差异化优势的公链而言,一旦用户和资金流失,想要重新建立生态往往需要付出更高的成本。
头部效应之下,中小公链面临的生存压力进一步加大。DeFiLlama数据显示,以太坊、Solana、Base、BNB Chain等前十大公链占据了公链市场约九成的份额。在这样的竞争格局中,单纯依靠新链叙事、短期激励或代币发行吸引资金,已越来越难以形成长期优势。
面对日益激烈的竞争,公链的发展路径也开始出现分化。相较于试图覆盖所有应用场景的通用型公链,围绕特定需求、以实际应用带动用户和流动性的垂直公链,正成为行业主流探索方向。一些老牌公链也开始转向AI、支付等细分赛道,试图通过差异化定位寻找新的增长空间。
但无论选择哪条路线,都需要建立可持续的商业模式。对于缺乏持续收入来源的加密项目而言,融资储备和代币销售所得或许能够在短期内支撑团队运转,却难以替代稳定的经营现金流。一旦融资受阻、资金储备持续消耗,项目便可能被迫削减开支、缩减开发,甚至最终关停。Linera的经历正是一个现实案例,融资可以为项目争取时间,却无法无限期替代自身造血能力。
更值得关注的是,市场对公链的价值评估逻辑也在发生变化。过去,技术叙事、融资阵容、生态规模和空投预期,往往足以为项目带来关注与估值溢价。但随着越来越多项目进入实际运营阶段,市场开始重新审视这些增长究竟有多少来自真实需求,又有多少依赖短期激励。
虽然链上交易量和TVL仍是衡量生态规模与用户活跃度的重要指标,但并不必然意味着项目具备可持续的盈利能力。对于投资者而言,协议能否持续创造收入,以及这些收入能否有效传导至代币持有者,也逐渐成为评估项目的重要维度。
近期,Hyperliquid、Uniswap、NEAR、Venice、Arbitrum、Aave、Lighter等代币的强势表现,也进一步体现了市场对协议收入与代币激励对齐的重视。
正因如此,当前越来越多加密项目开始尝试通过代币回购销毁等方式,将协议经营活动与代币价值联系起来。据Unfolded数据,加密项目今年迄今已花费6.38亿美元用于代币回购,高于去年同期的5.45亿美元,而2024年同期仅为36.6万美元。其中,Hyperliquid和Pump.fun合计占近90%。
但回购本身并不等同于可持续的价值捕获。其实际效果仍取决于资金来源、回购规模、代币总供给变化,以及项目未来能否持续创造收入。若缺乏稳定的经营现金流,回购也可能只是阶段性的价值支出,难以成为长期支撑。
归根结底,当叙事与技术光环不再足以吸引流动性,公链竞争正在从争夺流量与市场关注,转向对真实需求、持续收入和价值回馈能力的考验。
文章作者:Nancy
文章来源:PANews
Linera曾是撸毛党的集体回忆。这个曾凭借空投预期吊足社区胃口、主网迟迟未能上线的明星L1,最终在紧急融资失败后黯然退场。
随着公链关停潮蔓延,Linera的停运再次敲响警钟,精英团队、明星资本与宏大叙事,已不足以支撑市场信心。
募资门槛降低仍难被买账,昔日明星L1走向关停
时隔许久,Linera再次被大范围提起,不是因为主网上线,也不是因为空投规则,而是因为关停。
上月底,Linera高调宣称要打造“下一个Hyperliquid”,并预告即将启动LNRA代币销售。9月1日,Linera正式开启LNRA社区轮公募,代币定价0.16美元,对应1.6亿美元FDV,同时为早期参与者提供低至0.02美元的优惠价格。
然而,市场反应远不及预期。社区轮认购进展缓慢,整体热度明显不足。最终,来自69个国家和地区的617名参与者承诺认购约84.8万美元,不仅远低于800万美元的募资上限,甚至未能达到150万美元的最低募资目标。尽管此次公募规模相比过去动辄数千万美元的加密项目融资并不算高,但Linera依然未能完成最低募资要求,市场冷淡程度可见一斑。
9月19日,Linera创始人Mathieu Baudet在Discord宣布,由于LNRA代币销售未达到完成销售所需的最低金额,所有认购款项均已退还,项目将立即停止运营。此前团队曾尝试筹集紧急资金,以维持运营至主网上线,但未能筹集到所需资金,最终导致项目关闭。
从高调预告代币销售,到因募资未达标而停止运营,Linera的突然关停也让市场颇感意外,也让不少撸毛用户多年的等待化为泡影。从测试网交互、做任务,到收集徽章、参加周会、积累Discord角色,围绕Linera生态的长期参与,曾成为不少社区用户的日常。如今项目突然停摆,这些投入却并未得到回报。
有用户在社交平台发文称,自己过去3年持续参与Linera生态交互,累计投入约4万至8万个MGS,发布100余条内容,参加69场社区活动并领取30枚徽章,但最终“收益为0”,甚至没有等到空投查询的机会。
也有用户质疑,Linera背后曾获得a16z等一线风投支持,但项目历经数年仍未正式上线主网,最终却因资金问题走向关停,“四年还没上主网就资金耗尽,下一个会是谁?”类似声音开始在社区蔓延。更有用户直言,“VC把鬼链甩给散户然后走人”,也有人感叹,“我们刷的是积分,Linera刷走的却是我们的时间。”
更有社区用户将Hyperliquid和Linera进行对比,认为前者是产品先跑出来、资金随后涌入,而Linera则更像是“故事先讲满”,最终却需要依靠社区轮融资维持运营。
如今的Linera,或许很难再与明星L1联系在一起。但自项目2022年启动以来,从团队背景到融资阵容,再到Move生态叙事,Linera几乎集齐了当时热门公链的多个标签。即便尚未真正进入大规模应用阶段,Linera依然获得足够的市场关注和社区期待。
Linera由Meta前研究员Mathieu Baudet创立,创始团队的背景使项目自诞生起便自带话题度,并一度与Aptos、Sui并称为“Move三杰”。2022年和2023年,Linera先后完成两轮融资,总融资规模约1200万美元,a16z连续参与投资,其他投资方还包括Borderless Capital、GSR、Matrixport Ventures和Flow Traders等,资本阵容颇为亮眼。然而,这些光环却并未成为Linera穿越周期的护城河。
目前,Linera正逐步关闭应用及Discord社区。用户积分余额仍会保留记录,但团队无法承诺这些积分未来能够兑换任何权益。至于协议开发和应用上线,团队表示仍希望未来继续推进,却暂时无法给出明确时间表。
公链开启生存战,可持续造血能力成关键
Linera的谢幕看似突然,却并非毫无征兆。
当越来越多公链从高光走向沉寂,甚至被迫关停或转型,行业正在经历的或许不只是一轮市场调整,更是一场围绕流动性、商业模式与价值捕获的重新审视。
近几个月来,Harmony、Scroll、Moonbeam、Secret Network、Saga、Vanar、Zero等Layer1和Layer2项目陆续宣布关停或转型,其中不乏曾经备受关注的行业先锋。它们曾凭借技术叙事、融资阵容和生态激励吸引市场目光,也一度积累起可观的链上流动性。然而,当市场热度褪去,激励逐渐退场,其交易量和用户活跃度开始断崖式下滑,甚至沦为名副其实的“鬼链”。
尤其是在Robinhood Chain等背靠传统巨头的新链入局后,为市场资金和用户提供了更多选择,加速了不同生态之间的流动性迁移。对于缺乏差异化优势的公链而言,一旦用户和资金流失,想要重新建立生态往往需要付出更高的成本。
头部效应之下,中小公链面临的生存压力进一步加大。DeFiLlama数据显示,以太坊、Solana、Base、BNB Chain等前十大公链占据了公链市场约九成的份额。在这样的竞争格局中,单纯依靠新链叙事、短期激励或代币发行吸引资金,已越来越难以形成长期优势。
面对日益激烈的竞争,公链的发展路径也开始出现分化。相较于试图覆盖所有应用场景的通用型公链,围绕特定需求、以实际应用带动用户和流动性的垂直公链,正成为行业主流探索方向。一些老牌公链也开始转向AI、支付等细分赛道,试图通过差异化定位寻找新的增长空间。
但无论选择哪条路线,都需要建立可持续的商业模式。对于缺乏持续收入来源的加密项目而言,融资储备和代币销售所得或许能够在短期内支撑团队运转,却难以替代稳定的经营现金流。一旦融资受阻、资金储备持续消耗,项目便可能被迫削减开支、缩减开发,甚至最终关停。Linera的经历正是一个现实案例,融资可以为项目争取时间,却无法无限期替代自身造血能力。
更值得关注的是,市场对公链的价值评估逻辑也在发生变化。过去,技术叙事、融资阵容、生态规模和空投预期,往往足以为项目带来关注与估值溢价。但随着越来越多项目进入实际运营阶段,市场开始重新审视这些增长究竟有多少来自真实需求,又有多少依赖短期激励。
虽然链上交易量和TVL仍是衡量生态规模与用户活跃度的重要指标,但并不必然意味着项目具备可持续的盈利能力。对于投资者而言,协议能否持续创造收入,以及这些收入能否有效传导至代币持有者,也逐渐成为评估项目的重要维度。
近期,Hyperliquid、Uniswap、NEAR、Venice、Arbitrum、Aave、Lighter等代币的强势表现,也进一步体现了市场对协议收入与代币激励对齐的重视。
正因如此,当前越来越多加密项目开始尝试通过代币回购销毁等方式,将协议经营活动与代币价值联系起来。据Unfolded数据,加密项目今年迄今已花费6.38亿美元用于代币回购,高于去年同期的5.45亿美元,而2024年同期仅为36.6万美元。其中,Hyperliquid和Pump.fun合计占近90%。
但回购本身并不等同于可持续的价值捕获。其实际效果仍取决于资金来源、回购规模、代币总供给变化,以及项目未来能否持续创造收入。若缺乏稳定的经营现金流,回购也可能只是阶段性的价值支出,难以成为长期支撑。
归根结底,当叙事与技术光环不再足以吸引流动性,公链竞争正在从争夺流量与市场关注,转向对真实需求、持续收入和价值回馈能力的考验。
16
·
--
Artigo
Ver tradução
Claude Code下半年:格式投降OpenAI,功能借鉴DeepSeekClaude Code于9月19日起原生支持OpenAI推出的AGENTS.md项目指令格式,结束长期仅支持自有CLAUDE.md的格局;此举旨在解决开发者需重复维护两份高度相似文件的痛点,并通过Mod插件系统增强扩展性,功能设计上亦显现出向DeepSeek等竞品借鉴的趋势。
文章作者:量子位
文章来源:火星财经
Claude向OpenAI格式投降了。
Claude Code从9月19日起原生支持AGENTS.md。
这是OpenAI在2025年8月推出的一种项目指令文件格式,此前Claude Code一直坚持只读自己的CLAUDE.md。
现在兼容了,隔壁OpenAI加的Tibo也来围观支持。
大概在5月,Agents.md的使用数量就已经超越了Claude.md。
就在更新这一天,有人搞了个抽样调查,6.2%的GitHub活跃仓库包含AGENTS.md(活跃仓库标准是90天内有push、非fork、非archived),CLAUDE.md的比例是5.4%。
也就是说,大量项目的开发者不得不同时维护两个文件。
尽管从格式到内容,两者几乎没什么区别。
没什么区别,但是折磨开发者一年
OpenAI为自家的Codex设计了AGENTS.md,给AI编程助手一个标准化的方式来读取项目的编码规范、构建步骤和测试要求。它本质上就是一个放在代码仓库根目录的Markdown文件,相当于写给AI的README。
OpenAI从一开始就没有把它叫做OpenAI.md或者Codex.md。
这个开放格式迅速获得了行业认可,到2025年12月,OpenAI把AGENTS.md捐赠给了Linux基金会下新成立的Agentic AI Foundation(AAIF)。
奇怪的是Anthropic也是这个基金会的联合创始方之一,捐出了自家的MCP协议,Block则贡献了goose框架。AWS、Google、Microsoft、Bloomberg、Cloudflare全部以白金会员身份加入。
Codex、GitHub Copilot、Cursor、Windsurf、Gemini CLI、Aider、Zed、Jules、JetBrains Junie先后宣布原生支持Agents.md。
在所有主流AI编程工具中,Claude Code是最后一个。
Claude Code只认CLAUDE.md这件事,已经困扰开发者很久了。
同一个项目里,Codex读AGENTS.md,Cursor读AGENTS.md,只有Claude Code要求一份单独的CLAUDE.md。两份文件内容90%重合,却必须分开维护。
一旦一边更新另一边忘了改,不同AI agent就会给出矛盾的建议。
社区被迫发明了各种变通方案。这些变通方案能用,但都有各自的问题。
最常见的是在项目根目录执行ln -s AGENTS.md CLAUDE.md,用文件系统的符号链接让两个文件名指向同一份内容。
但这在Windows上需要管理员权限或开发者模式,Git在Windows上默认也不保留符号链接,没有正确配置的情况下克隆仓库,CLAUDE.md会变成只包含「AGENTS.md」这几个字母的空壳文件,Agent读进去完全无效,而且也不会报错,很容易发现不了。
也有人在CLAUDE.md第一行写@AGENTS.md利用导入语法间接读取。
对于新加入团队的成员来说,看到一个只有一行内容、指向另一个不同名Markdown文件的指令文件,很难理解发生了什么。
用多个AI编程工具协作的团队受影响最大。
同一个代码仓库要同时维护CLAUDE.md和AGENTS.md,内容高度重复,但又不完全相同,CLAUDE.md可能包含Claude特有的指令,AGENTS.md则是工具无关的。
两个文件一旦漂移不同步,排查问题会非常头疼。
Claude Code的下一步:Mod
Claude Code 2.1.277的实现方式是回退机制,而不是全面替换。
默认模式叫「claude-md-or-agents-md」:只有当项目中不存在任何CLAUDE.md的时候,才会去查找并加载AGENTS.md。如果项目已经有了CLAUDE.md,哪怕只是一个空文件,AGENTS.md就不会被读取。
除了默认模式之外,开发者还可以在/config中选择另外三种模式:只读CLAUDE.md、同时读取两种文件、或者只加载组织级别的托管指令文件,整个功能作为一个内置插件(Mod)实现。
Claude Code的Mod系统9月刚刚发布,本质上是一套插件系统,允许开发者在Claude Code的运行流程中插入自定义逻辑。
每个mod可以监听特定的生命周期事件,比如会话启动、上下文构建、工具调用、子agent派生等,在这些关键节点上拦截、修改或补充Claude Code的默认行为。
通过Mod,你甚至可以在Claude Code里玩俄罗斯方块。
不过从Agents.md的支持上也可以看出Claude Code插件体系还有一些不完善。
文档中列出了一系列「仍然与CLAUDE.md存在差异」的条目:
AGENTS.md的嵌套文件只在文本类型的Read操作中触发,不覆盖IDE中打开的文件、notebook和图片等场景;
/memory命令和#快捷键不识别AGENTS.md文件;
--add-dir添加的额外目录不会加载其中的AGENTS.md;
AGENTS.md中引用外部路径的@导入需要借用CLAUDE.md的授权对话框才能生效,自身不会触发授权提示。
这些限制来自于当前插件事件体系尚未覆盖到这些场景。
所以总结这一波,Claude Code在格式上更像OpenAI了,在功能上更像DeepSeek了。
Claude Code下半年:格式投降OpenAI,功能借鉴DeepSeek
Claude Code于9月19日起原生支持OpenAI推出的AGENTS.md项目指令格式,结束长期仅支持自有CLAUDE.md的格局;此举旨在解决开发者需重复维护两份高度相似文件的痛点,并通过Mod插件系统增强扩展性,功能设计上亦显现出向DeepSeek等竞品借鉴的趋势。
文章作者:量子位
文章来源:火星财经
Claude向OpenAI格式投降了。
Claude Code从9月19日起原生支持AGENTS.md。
这是OpenAI在2025年8月推出的一种项目指令文件格式,此前Claude Code一直坚持只读自己的CLAUDE.md。
现在兼容了,隔壁OpenAI加的Tibo也来围观支持。
大概在5月,Agents.md的使用数量就已经超越了Claude.md。
就在更新这一天,有人搞了个抽样调查,6.2%的GitHub活跃仓库包含AGENTS.md(活跃仓库标准是90天内有push、非fork、非archived),CLAUDE.md的比例是5.4%。
也就是说,大量项目的开发者不得不同时维护两个文件。
尽管从格式到内容,两者几乎没什么区别。
没什么区别,但是折磨开发者一年
OpenAI为自家的Codex设计了AGENTS.md,给AI编程助手一个标准化的方式来读取项目的编码规范、构建步骤和测试要求。它本质上就是一个放在代码仓库根目录的Markdown文件,相当于写给AI的README。
OpenAI从一开始就没有把它叫做OpenAI.md或者Codex.md。
这个开放格式迅速获得了行业认可,到2025年12月,OpenAI把AGENTS.md捐赠给了Linux基金会下新成立的Agentic AI Foundation(AAIF)。
奇怪的是Anthropic也是这个基金会的联合创始方之一,捐出了自家的MCP协议,Block则贡献了goose框架。AWS、Google、Microsoft、Bloomberg、Cloudflare全部以白金会员身份加入。
Codex、GitHub Copilot、Cursor、Windsurf、Gemini CLI、Aider、Zed、Jules、JetBrains Junie先后宣布原生支持Agents.md。
在所有主流AI编程工具中,Claude Code是最后一个。
Claude Code只认CLAUDE.md这件事,已经困扰开发者很久了。
同一个项目里,Codex读AGENTS.md,Cursor读AGENTS.md,只有Claude Code要求一份单独的CLAUDE.md。两份文件内容90%重合,却必须分开维护。
一旦一边更新另一边忘了改,不同AI agent就会给出矛盾的建议。
社区被迫发明了各种变通方案。这些变通方案能用,但都有各自的问题。
最常见的是在项目根目录执行ln -s AGENTS.md CLAUDE.md,用文件系统的符号链接让两个文件名指向同一份内容。
但这在Windows上需要管理员权限或开发者模式,Git在Windows上默认也不保留符号链接,没有正确配置的情况下克隆仓库,CLAUDE.md会变成只包含「AGENTS.md」这几个字母的空壳文件,Agent读进去完全无效,而且也不会报错,很容易发现不了。
也有人在CLAUDE.md第一行写@AGENTS.md利用导入语法间接读取。
对于新加入团队的成员来说,看到一个只有一行内容、指向另一个不同名Markdown文件的指令文件,很难理解发生了什么。
用多个AI编程工具协作的团队受影响最大。
同一个代码仓库要同时维护CLAUDE.md和AGENTS.md,内容高度重复,但又不完全相同,CLAUDE.md可能包含Claude特有的指令,AGENTS.md则是工具无关的。
两个文件一旦漂移不同步,排查问题会非常头疼。
Claude Code的下一步:Mod
Claude Code 2.1.277的实现方式是回退机制,而不是全面替换。
默认模式叫「claude-md-or-agents-md」:只有当项目中不存在任何CLAUDE.md的时候,才会去查找并加载AGENTS.md。如果项目已经有了CLAUDE.md,哪怕只是一个空文件,AGENTS.md就不会被读取。
除了默认模式之外,开发者还可以在/config中选择另外三种模式:只读CLAUDE.md、同时读取两种文件、或者只加载组织级别的托管指令文件,整个功能作为一个内置插件(Mod)实现。
Claude Code的Mod系统9月刚刚发布,本质上是一套插件系统,允许开发者在Claude Code的运行流程中插入自定义逻辑。
每个mod可以监听特定的生命周期事件,比如会话启动、上下文构建、工具调用、子agent派生等,在这些关键节点上拦截、修改或补充Claude Code的默认行为。
通过Mod,你甚至可以在Claude Code里玩俄罗斯方块。
不过从Agents.md的支持上也可以看出Claude Code插件体系还有一些不完善。
文档中列出了一系列「仍然与CLAUDE.md存在差异」的条目:
AGENTS.md的嵌套文件只在文本类型的Read操作中触发,不覆盖IDE中打开的文件、notebook和图片等场景;
/memory命令和#快捷键不识别AGENTS.md文件;
--add-dir添加的额外目录不会加载其中的AGENTS.md;
AGENTS.md中引用外部路径的@导入需要借用CLAUDE.md的授权对话框才能生效,自身不会触发授权提示。
这些限制来自于当前插件事件体系尚未覆盖到这些场景。
所以总结这一波,Claude Code在格式上更像OpenAI了,在功能上更像DeepSeek了。
文章作者:量子位
文章来源:火星财经
Claude向OpenAI格式投降了。
Claude Code从9月19日起原生支持AGENTS.md。
这是OpenAI在2025年8月推出的一种项目指令文件格式,此前Claude Code一直坚持只读自己的CLAUDE.md。
现在兼容了,隔壁OpenAI加的Tibo也来围观支持。
大概在5月,Agents.md的使用数量就已经超越了Claude.md。
就在更新这一天,有人搞了个抽样调查,6.2%的GitHub活跃仓库包含AGENTS.md(活跃仓库标准是90天内有push、非fork、非archived),CLAUDE.md的比例是5.4%。
也就是说,大量项目的开发者不得不同时维护两个文件。
尽管从格式到内容,两者几乎没什么区别。
没什么区别,但是折磨开发者一年
OpenAI为自家的Codex设计了AGENTS.md,给AI编程助手一个标准化的方式来读取项目的编码规范、构建步骤和测试要求。它本质上就是一个放在代码仓库根目录的Markdown文件,相当于写给AI的README。
OpenAI从一开始就没有把它叫做OpenAI.md或者Codex.md。
这个开放格式迅速获得了行业认可,到2025年12月,OpenAI把AGENTS.md捐赠给了Linux基金会下新成立的Agentic AI Foundation(AAIF)。
奇怪的是Anthropic也是这个基金会的联合创始方之一,捐出了自家的MCP协议,Block则贡献了goose框架。AWS、Google、Microsoft、Bloomberg、Cloudflare全部以白金会员身份加入。
Codex、GitHub Copilot、Cursor、Windsurf、Gemini CLI、Aider、Zed、Jules、JetBrains Junie先后宣布原生支持Agents.md。
在所有主流AI编程工具中,Claude Code是最后一个。
Claude Code只认CLAUDE.md这件事,已经困扰开发者很久了。
同一个项目里,Codex读AGENTS.md,Cursor读AGENTS.md,只有Claude Code要求一份单独的CLAUDE.md。两份文件内容90%重合,却必须分开维护。
一旦一边更新另一边忘了改,不同AI agent就会给出矛盾的建议。
社区被迫发明了各种变通方案。这些变通方案能用,但都有各自的问题。
最常见的是在项目根目录执行ln -s AGENTS.md CLAUDE.md,用文件系统的符号链接让两个文件名指向同一份内容。
但这在Windows上需要管理员权限或开发者模式,Git在Windows上默认也不保留符号链接,没有正确配置的情况下克隆仓库,CLAUDE.md会变成只包含「AGENTS.md」这几个字母的空壳文件,Agent读进去完全无效,而且也不会报错,很容易发现不了。
也有人在CLAUDE.md第一行写@AGENTS.md利用导入语法间接读取。
对于新加入团队的成员来说,看到一个只有一行内容、指向另一个不同名Markdown文件的指令文件,很难理解发生了什么。
用多个AI编程工具协作的团队受影响最大。
同一个代码仓库要同时维护CLAUDE.md和AGENTS.md,内容高度重复,但又不完全相同,CLAUDE.md可能包含Claude特有的指令,AGENTS.md则是工具无关的。
两个文件一旦漂移不同步,排查问题会非常头疼。
Claude Code的下一步:Mod
Claude Code 2.1.277的实现方式是回退机制,而不是全面替换。
默认模式叫「claude-md-or-agents-md」:只有当项目中不存在任何CLAUDE.md的时候,才会去查找并加载AGENTS.md。如果项目已经有了CLAUDE.md,哪怕只是一个空文件,AGENTS.md就不会被读取。
除了默认模式之外,开发者还可以在/config中选择另外三种模式:只读CLAUDE.md、同时读取两种文件、或者只加载组织级别的托管指令文件,整个功能作为一个内置插件(Mod)实现。
Claude Code的Mod系统9月刚刚发布,本质上是一套插件系统,允许开发者在Claude Code的运行流程中插入自定义逻辑。
每个mod可以监听特定的生命周期事件,比如会话启动、上下文构建、工具调用、子agent派生等,在这些关键节点上拦截、修改或补充Claude Code的默认行为。
通过Mod,你甚至可以在Claude Code里玩俄罗斯方块。
不过从Agents.md的支持上也可以看出Claude Code插件体系还有一些不完善。
文档中列出了一系列「仍然与CLAUDE.md存在差异」的条目:
AGENTS.md的嵌套文件只在文本类型的Read操作中触发,不覆盖IDE中打开的文件、notebook和图片等场景;
/memory命令和#快捷键不识别AGENTS.md文件;
--add-dir添加的额外目录不会加载其中的AGENTS.md;
AGENTS.md中引用外部路径的@导入需要借用CLAUDE.md的授权对话框才能生效,自身不会触发授权提示。
这些限制来自于当前插件事件体系尚未覆盖到这些场景。
所以总结这一波,Claude Code在格式上更像OpenAI了,在功能上更像DeepSeek了。
6
·
--
Ver tradução
AI写的网页到底能不能用?腾讯做了个会自己点网页的评测ME AI 消息,动察 Beating AI 快讯,腾讯混元联合清华、北大推出 IWC-Bench,专门评测 AI 生成的网页实际用起来怎么样。 不少网页生成评测主要看代码或截图。页面可能看起来很漂亮,代码里也确实写了功能,但按钮点不开、表单交不了、切个页面就报错,这些问题很难靠静态检查发现。 IWC-Bench 更像真人验收。它让一个 Agent 真正打开网页,点击按钮、输入内容、切换页面,再检查哪些功能实际跑过。最后分别评价三件事:页面好不好看、操作顺不顺、用户要求的功能有没有做出来。 基准收录 369 条真实用户需求和 5088 条验收标准,17 个模型一共生成了 6273 个网页应用。在另外 197 组人工复核的对比中,IWC-Bench 有 168 组和人类选择一致,一致率达到 85.3%。 结果也说明,网页「看起来不错」和「真的好用」不是一回事。GPT-5.6-Sol 的页面美观度最高,但易用性只排第六;具体到单个网页,好看基本不能说明它好不好用,两项相关系数只有 0.36。 (来源:ME)
AI写的网页到底能不能用?腾讯做了个会自己点网页的评测
ME AI 消息,动察 Beating AI 快讯,腾讯混元联合清华、北大推出 IWC-Bench,专门评测 AI 生成的网页实际用起来怎么样。 不少网页生成评测主要看代码或截图。页面可能看起来很漂亮,代码里也确实写了功能,但按钮点不开、表单交不了、切个页面就报错,这些问题很难靠静态检查发现。 IWC-Bench 更像真人验收。它让一个 Agent 真正打开网页,点击按钮、输入内容、切换页面,再检查哪些功能实际跑过。最后分别评价三件事:页面好不好看、操作顺不顺、用户要求的功能有没有做出来。 基准收录 369 条真实用户需求和 5088 条验收标准,17 个模型一共生成了 6273 个网页应用。在另外 197 组人工复核的对比中,IWC-Bench 有 168 组和人类选择一致,一致率达到 85.3%。 结果也说明,网页「看起来不错」和「真的好用」不是一回事。GPT-5.6-Sol 的页面美观度最高,但易用性只排第六;具体到单个网页,好看基本不能说明它好不好用,两项相关系数只有 0.36。 (来源:ME)
8
·
--
Ver tradução
微软高管称AI训练像“最大规模盗窃”:人工智能的版权困局正在爆发AI 产业真正需要解决的问题,并不是简单判断“AI 是否侵权”,而是如何建立一种新的内容生产、分发与收益分配机制。
文章作者、来源:ME News
TL;DR
《纽约时报》起诉 OpenAI 和微软的版权案件公开部分内部材料,其中微软应用科学总监 Brent Hecht 曾将大规模抓取网络内容训练 AI 描述为“前所未有的惊人盗窃”,并称其可能涉及“人类史上最大规模的劳动力盗窃”。
这些内部讨论反映出科技公司内部对于 AI 训练模式长期存在的矛盾认知:一方面,海量数据是大模型能力提升的基础;另一方面,这些数据背后的创作者并未获得直接补偿。
AI 与传统搜索、媒体行业之间的冲突正在加剧。部分数据显示,生成式 AI 产品可能降低用户访问原始内容网站的比例,使出版商面临流量和商业模式压力。
OpenAI 和微软目前仍认为,利用公开网络内容训练 AI 属于美国版权法中的合理使用(fair use),但这一法律边界尚未形成最终共识。
AI 产业真正需要解决的问题,并不是简单判断“AI 是否侵权”,而是如何建立一种新的内容生产、分发与收益分配机制。
AI训练数据争议,从技术问题变成产业规则问题
生成式人工智能的发展速度,已经让过去几十年建立起来的互联网内容生态面临重新审视。
过去,互联网遵循一种相对清晰的价值交换关系:内容生产者通过文章、图片、视频、数据库等形式创造信息,平台负责分发,而用户通过广告、订阅、交易等方式间接支持内容生态。但大型语言模型的出现改变了这一关系。
AI公司并不是简单地向用户展示内容,而是通过抓取、处理和分析大量文本、代码、图片以及其他数字资料,让模型学习其中蕴含的语言规律、知识结构和表达方式。换句话说,互联网多年积累的公开内容,正在成为训练人工智能系统的重要基础设施。
这也是为什么《纽约时报》起诉 OpenAI 和微软的案件受到高度关注。案件争议的核心并不仅仅是某篇文章是否被复制,而是一个更大的问题:当人工智能通过学习整个互联网获得能力时,这些内容创造者是否应该获得补偿?如果需要补偿,应该按照什么标准?如果不需要补偿,未来还有多少内容生产者愿意持续投入?
此前,人工智能行业更多将这一问题定义为技术发展过程中的版权适配问题,但随着生成式 AI 进入商业化阶段,它逐渐演变成一次关于数字经济利益分配的重新谈判。
微软内部文件曝光后引发关注,正是因为它揭示了科技公司内部对于这一矛盾并非没有意识。
据公开报道,微软应用科学总监 Brent Hecht 曾在内部讨论中,将大规模抓取网络内容用于 AI 训练描述为“前所未有的惊人盗窃”,并认为这种行为可能达到“人类史上最大规模的劳动力盗窃”的程度。需要注意的是,微软方面随后表示,这只是个人观点,并不代表公司的正式立场,也不是法律判断。
但这一表述仍然具有代表性,因为它触及了 AI 发展的一个核心矛盾:人工智能创造的新价值,究竟建立在谁过去创造的价值之上?
AI发展的底层燃料:互联网内容,但价值归属正在重新争夺
大型语言模型的能力提升,本质上依赖三个核心因素:算法、算力和数据。
过去几年,全球 AI 竞争主要集中在模型架构和计算资源上。从 Transformer 架构普及,到 GPU 集群规模扩大,再到模型参数量提升,技术公司不断推动 AI 能力边界。
但随着模型规模扩大,数据的重要性越来越明显。
以 GPT 系列模型为代表的大语言模型,需要处理规模极其庞大的文本数据,包括书籍、网页、论文、代码库、新闻文章以及各种公开资料。这些数据帮助模型理解语言结构、知识关系和不同领域的信息表达。
问题在于,互联网内容并不是天然存在的资源。
一篇调查报道、一份行业研究、一篇专业文章,都需要记者、研究人员、工程师或者普通创作者投入时间和劳动。当 AI 模型通过这些内容获得商业能力,而内容生产者无法获得直接收益时,传统互联网中的价值关系开始发生变化。
这也是出版行业最担忧的问题。
传统搜索引擎虽然改变了信息分发方式,但用户最终仍需要点击网页,访问新闻网站,产生广告收入或者订阅价值。而生成式 AI 直接提供答案,可能减少用户回到原始内容来源的需求。
微软 CEO Satya Nadella 在相关证词中承认,聊天机器人能够让用户直接获得答案,从而减少访问原始来源的可能性。这意味着 AI 不只是一个新的信息入口,它可能成为搜索生态的替代层。
对于内容平台而言,最大的风险并不是 AI 使用了自己的内容,而是 AI 可能改变用户获取信息的方式。
如果越来越多用户选择直接向 AI 提问,而不是阅读原始文章,那么内容生产者过去依赖的流量模式可能受到冲击。
微软内部文件将这种情况称为“死亡循环”:AI 获取内容生产者创造的信息,降低这些内容生产者的收入,导致高质量内容减少,最终影响 AI 自身的数据来源。
这个逻辑并非没有现实依据。
过去十多年,互联网已经经历过类似变化。社交平台和算法推荐体系提高了内容传播效率,但也改变了媒体行业的商业模式。大量传统媒体机构面临广告收入下降、订阅压力增加的问题。
AI可能进一步放大这一趋势。
“死亡循环”是否会发生,取决于AI与内容生态能否重新建立平衡
不过,将 AI 训练直接定义为“盗窃”仍然存在争议。
从法律角度来看,美国版权制度并没有简单禁止所有未经授权的数据使用。OpenAI 和微软目前的核心观点是,使用公开网络内容训练 AI 属于合理使用范围。
合理使用(fair use)是美国版权法中的重要原则,通常需要综合考虑使用目的、作品性质、使用比例以及是否影响原作品市场等因素。
AI训练是否符合合理使用,目前仍处于法律争论阶段。
支持 AI 公司的一方认为,大模型并不是简单复制内容,而是在大量数据基础上学习模式,类似人类阅读大量书籍后形成知识体系。如果任何公开内容都需要逐一授权,AI产业的发展成本可能大幅增加,创新速度也可能受到限制。
反对者则认为,AI公司正在利用大量受版权保护内容建立商业产品,而这些产品未来可能直接替代内容生产者,因此不能简单类比人类学习过程。
双方争议的核心,不是 AI 是否应该发展,而是 AI 发展的收益应该如何分配。
事实上,部分行业已经开始探索新的合作方式。
一些新闻机构选择与 AI 公司建立授权协议,通过许可内容获得收入。例如,部分媒体集团与 OpenAI 达成内容合作,让 AI 产品能够合法使用新闻资料,同时为内容提供方创造新的商业渠道。
这说明未来可能并不是“AI 与内容行业二选一”,而是建立新的授权和收益模式。
真正困难的是,互联网内容规模巨大,创作者数量庞大,如何建立高效率、低成本的授权机制仍然是一个复杂问题。
如果每一次 AI 训练都需要逐一获得许可,技术发展可能受到限制;但如果完全不考虑内容创造者权益,长期来看也可能削弱 AI 最重要的数据来源。
AI时代最大的竞争,不只是模型能力,而是价值体系设计能力
过去几年,AI行业的竞争主要围绕模型参数、推理能力和商业落地展开。
但随着技术进入成熟阶段,新的竞争焦点正在出现:谁能够建立更加稳定的生态关系。
人工智能并不是脱离社会运行的独立技术。它需要能源、芯片、数据、人才,也需要大量人类创造的知识资产。
如果 AI 只关注如何获得更多数据,而忽视内容生产者的长期利益,那么它可能面临一个结构性问题:今天的数据来源,可能成为未来发展的限制因素。
互联网过去二十年的经验已经证明,任何技术平台最终都需要解决利益分配问题。
搜索引擎需要与网站建立流量关系,社交平台需要依靠创作者生态维持活跃,视频平台需要通过广告和分成吸引内容生产者。
AI也无法例外。
未来的大模型竞争,不仅取决于谁拥有更强的算法,也取决于谁能够建立更可持续的数据生态。
因此,微软内部关于“最大规模劳动力盗窃”的讨论,真正值得关注的并不是这句话本身是否准确,而是它揭示出的产业矛盾:人工智能正在快速吸收过去互联网时代积累的知识财富,但新的价值交换机制尚未完全形成。
AI的发展不会因为版权争议而停止,但它必须回答一个问题:当机器越来越依赖人类创造的内容时,人类创造者应该如何继续参与这场技术革命带来的价值增长?
这可能是生成式人工智能进入下一个阶段时,整个行业必须面对的核心命题。
参考来源
The New York Times v. Microsoft Corporation and OpenAI, Inc. Copyright Litigation Court Documents
The New York Times, “The Times Sues OpenAI and Microsoft Over A.I. Use of Copyrighted Work”
United States Copyright Office, “Copyright and Artificial Intelligence” Reports
OpenAI, “Copyright and AI: How OpenAI Uses Content in Training Models”
Microsoft Official Statements Regarding AI Training and Copyright Issues
Reuters, Coverage of AI Copyright Litigation and Media Industry Impact
The Verge, Reporting on OpenAI, Microsoft and Publisher Relationships
Financial Times, Analysis of Generative AI and Content Industry Transformation
微软高管称AI训练像“最大规模盗窃”:人工智能的版权困局正在爆发
AI 产业真正需要解决的问题,并不是简单判断“AI 是否侵权”,而是如何建立一种新的内容生产、分发与收益分配机制。
文章作者、来源:ME News
TL;DR
《纽约时报》起诉 OpenAI 和微软的版权案件公开部分内部材料,其中微软应用科学总监 Brent Hecht 曾将大规模抓取网络内容训练 AI 描述为“前所未有的惊人盗窃”,并称其可能涉及“人类史上最大规模的劳动力盗窃”。
这些内部讨论反映出科技公司内部对于 AI 训练模式长期存在的矛盾认知:一方面,海量数据是大模型能力提升的基础;另一方面,这些数据背后的创作者并未获得直接补偿。
AI 与传统搜索、媒体行业之间的冲突正在加剧。部分数据显示,生成式 AI 产品可能降低用户访问原始内容网站的比例,使出版商面临流量和商业模式压力。
OpenAI 和微软目前仍认为,利用公开网络内容训练 AI 属于美国版权法中的合理使用(fair use),但这一法律边界尚未形成最终共识。
AI 产业真正需要解决的问题,并不是简单判断“AI 是否侵权”,而是如何建立一种新的内容生产、分发与收益分配机制。
AI训练数据争议,从技术问题变成产业规则问题
生成式人工智能的发展速度,已经让过去几十年建立起来的互联网内容生态面临重新审视。
过去,互联网遵循一种相对清晰的价值交换关系:内容生产者通过文章、图片、视频、数据库等形式创造信息,平台负责分发,而用户通过广告、订阅、交易等方式间接支持内容生态。但大型语言模型的出现改变了这一关系。
AI公司并不是简单地向用户展示内容,而是通过抓取、处理和分析大量文本、代码、图片以及其他数字资料,让模型学习其中蕴含的语言规律、知识结构和表达方式。换句话说,互联网多年积累的公开内容,正在成为训练人工智能系统的重要基础设施。
这也是为什么《纽约时报》起诉 OpenAI 和微软的案件受到高度关注。案件争议的核心并不仅仅是某篇文章是否被复制,而是一个更大的问题:当人工智能通过学习整个互联网获得能力时,这些内容创造者是否应该获得补偿?如果需要补偿,应该按照什么标准?如果不需要补偿,未来还有多少内容生产者愿意持续投入?
此前,人工智能行业更多将这一问题定义为技术发展过程中的版权适配问题,但随着生成式 AI 进入商业化阶段,它逐渐演变成一次关于数字经济利益分配的重新谈判。
微软内部文件曝光后引发关注,正是因为它揭示了科技公司内部对于这一矛盾并非没有意识。
据公开报道,微软应用科学总监 Brent Hecht 曾在内部讨论中,将大规模抓取网络内容用于 AI 训练描述为“前所未有的惊人盗窃”,并认为这种行为可能达到“人类史上最大规模的劳动力盗窃”的程度。需要注意的是,微软方面随后表示,这只是个人观点,并不代表公司的正式立场,也不是法律判断。
但这一表述仍然具有代表性,因为它触及了 AI 发展的一个核心矛盾:人工智能创造的新价值,究竟建立在谁过去创造的价值之上?
AI发展的底层燃料:互联网内容,但价值归属正在重新争夺
大型语言模型的能力提升,本质上依赖三个核心因素:算法、算力和数据。
过去几年,全球 AI 竞争主要集中在模型架构和计算资源上。从 Transformer 架构普及,到 GPU 集群规模扩大,再到模型参数量提升,技术公司不断推动 AI 能力边界。
但随着模型规模扩大,数据的重要性越来越明显。
以 GPT 系列模型为代表的大语言模型,需要处理规模极其庞大的文本数据,包括书籍、网页、论文、代码库、新闻文章以及各种公开资料。这些数据帮助模型理解语言结构、知识关系和不同领域的信息表达。
问题在于,互联网内容并不是天然存在的资源。
一篇调查报道、一份行业研究、一篇专业文章,都需要记者、研究人员、工程师或者普通创作者投入时间和劳动。当 AI 模型通过这些内容获得商业能力,而内容生产者无法获得直接收益时,传统互联网中的价值关系开始发生变化。
这也是出版行业最担忧的问题。
传统搜索引擎虽然改变了信息分发方式,但用户最终仍需要点击网页,访问新闻网站,产生广告收入或者订阅价值。而生成式 AI 直接提供答案,可能减少用户回到原始内容来源的需求。
微软 CEO Satya Nadella 在相关证词中承认,聊天机器人能够让用户直接获得答案,从而减少访问原始来源的可能性。这意味着 AI 不只是一个新的信息入口,它可能成为搜索生态的替代层。
对于内容平台而言,最大的风险并不是 AI 使用了自己的内容,而是 AI 可能改变用户获取信息的方式。
如果越来越多用户选择直接向 AI 提问,而不是阅读原始文章,那么内容生产者过去依赖的流量模式可能受到冲击。
微软内部文件将这种情况称为“死亡循环”:AI 获取内容生产者创造的信息,降低这些内容生产者的收入,导致高质量内容减少,最终影响 AI 自身的数据来源。
这个逻辑并非没有现实依据。
过去十多年,互联网已经经历过类似变化。社交平台和算法推荐体系提高了内容传播效率,但也改变了媒体行业的商业模式。大量传统媒体机构面临广告收入下降、订阅压力增加的问题。
AI可能进一步放大这一趋势。
“死亡循环”是否会发生,取决于AI与内容生态能否重新建立平衡
不过,将 AI 训练直接定义为“盗窃”仍然存在争议。
从法律角度来看,美国版权制度并没有简单禁止所有未经授权的数据使用。OpenAI 和微软目前的核心观点是,使用公开网络内容训练 AI 属于合理使用范围。
合理使用(fair use)是美国版权法中的重要原则,通常需要综合考虑使用目的、作品性质、使用比例以及是否影响原作品市场等因素。
AI训练是否符合合理使用,目前仍处于法律争论阶段。
支持 AI 公司的一方认为,大模型并不是简单复制内容,而是在大量数据基础上学习模式,类似人类阅读大量书籍后形成知识体系。如果任何公开内容都需要逐一授权,AI产业的发展成本可能大幅增加,创新速度也可能受到限制。
反对者则认为,AI公司正在利用大量受版权保护内容建立商业产品,而这些产品未来可能直接替代内容生产者,因此不能简单类比人类学习过程。
双方争议的核心,不是 AI 是否应该发展,而是 AI 发展的收益应该如何分配。
事实上,部分行业已经开始探索新的合作方式。
一些新闻机构选择与 AI 公司建立授权协议,通过许可内容获得收入。例如,部分媒体集团与 OpenAI 达成内容合作,让 AI 产品能够合法使用新闻资料,同时为内容提供方创造新的商业渠道。
这说明未来可能并不是“AI 与内容行业二选一”,而是建立新的授权和收益模式。
真正困难的是,互联网内容规模巨大,创作者数量庞大,如何建立高效率、低成本的授权机制仍然是一个复杂问题。
如果每一次 AI 训练都需要逐一获得许可,技术发展可能受到限制;但如果完全不考虑内容创造者权益,长期来看也可能削弱 AI 最重要的数据来源。
AI时代最大的竞争,不只是模型能力,而是价值体系设计能力
过去几年,AI行业的竞争主要围绕模型参数、推理能力和商业落地展开。
但随着技术进入成熟阶段,新的竞争焦点正在出现:谁能够建立更加稳定的生态关系。
人工智能并不是脱离社会运行的独立技术。它需要能源、芯片、数据、人才,也需要大量人类创造的知识资产。
如果 AI 只关注如何获得更多数据,而忽视内容生产者的长期利益,那么它可能面临一个结构性问题:今天的数据来源,可能成为未来发展的限制因素。
互联网过去二十年的经验已经证明,任何技术平台最终都需要解决利益分配问题。
搜索引擎需要与网站建立流量关系,社交平台需要依靠创作者生态维持活跃,视频平台需要通过广告和分成吸引内容生产者。
AI也无法例外。
未来的大模型竞争,不仅取决于谁拥有更强的算法,也取决于谁能够建立更可持续的数据生态。
因此,微软内部关于“最大规模劳动力盗窃”的讨论,真正值得关注的并不是这句话本身是否准确,而是它揭示出的产业矛盾:人工智能正在快速吸收过去互联网时代积累的知识财富,但新的价值交换机制尚未完全形成。
AI的发展不会因为版权争议而停止,但它必须回答一个问题:当机器越来越依赖人类创造的内容时,人类创造者应该如何继续参与这场技术革命带来的价值增长?
这可能是生成式人工智能进入下一个阶段时,整个行业必须面对的核心命题。
参考来源
The New York Times v. Microsoft Corporation and OpenAI, Inc. Copyright Litigation Court Documents
The New York Times, “The Times Sues OpenAI and Microsoft Over A.I. Use of Copyrighted Work”
United States Copyright Office, “Copyright and Artificial Intelligence” Reports
OpenAI, “Copyright and AI: How OpenAI Uses Content in Training Models”
Microsoft Official Statements Regarding AI Training and Copyright Issues
Reuters, Coverage of AI Copyright Litigation and Media Industry Impact
The Verge, Reporting on OpenAI, Microsoft and Publisher Relationships
Financial Times, Analysis of Generative AI and Content Industry Transformation
文章作者、来源:ME News
TL;DR
《纽约时报》起诉 OpenAI 和微软的版权案件公开部分内部材料,其中微软应用科学总监 Brent Hecht 曾将大规模抓取网络内容训练 AI 描述为“前所未有的惊人盗窃”,并称其可能涉及“人类史上最大规模的劳动力盗窃”。
这些内部讨论反映出科技公司内部对于 AI 训练模式长期存在的矛盾认知:一方面,海量数据是大模型能力提升的基础;另一方面,这些数据背后的创作者并未获得直接补偿。
AI 与传统搜索、媒体行业之间的冲突正在加剧。部分数据显示,生成式 AI 产品可能降低用户访问原始内容网站的比例,使出版商面临流量和商业模式压力。
OpenAI 和微软目前仍认为,利用公开网络内容训练 AI 属于美国版权法中的合理使用(fair use),但这一法律边界尚未形成最终共识。
AI 产业真正需要解决的问题,并不是简单判断“AI 是否侵权”,而是如何建立一种新的内容生产、分发与收益分配机制。
AI训练数据争议,从技术问题变成产业规则问题
生成式人工智能的发展速度,已经让过去几十年建立起来的互联网内容生态面临重新审视。
过去,互联网遵循一种相对清晰的价值交换关系:内容生产者通过文章、图片、视频、数据库等形式创造信息,平台负责分发,而用户通过广告、订阅、交易等方式间接支持内容生态。但大型语言模型的出现改变了这一关系。
AI公司并不是简单地向用户展示内容,而是通过抓取、处理和分析大量文本、代码、图片以及其他数字资料,让模型学习其中蕴含的语言规律、知识结构和表达方式。换句话说,互联网多年积累的公开内容,正在成为训练人工智能系统的重要基础设施。
这也是为什么《纽约时报》起诉 OpenAI 和微软的案件受到高度关注。案件争议的核心并不仅仅是某篇文章是否被复制,而是一个更大的问题:当人工智能通过学习整个互联网获得能力时,这些内容创造者是否应该获得补偿?如果需要补偿,应该按照什么标准?如果不需要补偿,未来还有多少内容生产者愿意持续投入?
此前,人工智能行业更多将这一问题定义为技术发展过程中的版权适配问题,但随着生成式 AI 进入商业化阶段,它逐渐演变成一次关于数字经济利益分配的重新谈判。
微软内部文件曝光后引发关注,正是因为它揭示了科技公司内部对于这一矛盾并非没有意识。
据公开报道,微软应用科学总监 Brent Hecht 曾在内部讨论中,将大规模抓取网络内容用于 AI 训练描述为“前所未有的惊人盗窃”,并认为这种行为可能达到“人类史上最大规模的劳动力盗窃”的程度。需要注意的是,微软方面随后表示,这只是个人观点,并不代表公司的正式立场,也不是法律判断。
但这一表述仍然具有代表性,因为它触及了 AI 发展的一个核心矛盾:人工智能创造的新价值,究竟建立在谁过去创造的价值之上?
AI发展的底层燃料:互联网内容,但价值归属正在重新争夺
大型语言模型的能力提升,本质上依赖三个核心因素:算法、算力和数据。
过去几年,全球 AI 竞争主要集中在模型架构和计算资源上。从 Transformer 架构普及,到 GPU 集群规模扩大,再到模型参数量提升,技术公司不断推动 AI 能力边界。
但随着模型规模扩大,数据的重要性越来越明显。
以 GPT 系列模型为代表的大语言模型,需要处理规模极其庞大的文本数据,包括书籍、网页、论文、代码库、新闻文章以及各种公开资料。这些数据帮助模型理解语言结构、知识关系和不同领域的信息表达。
问题在于,互联网内容并不是天然存在的资源。
一篇调查报道、一份行业研究、一篇专业文章,都需要记者、研究人员、工程师或者普通创作者投入时间和劳动。当 AI 模型通过这些内容获得商业能力,而内容生产者无法获得直接收益时,传统互联网中的价值关系开始发生变化。
这也是出版行业最担忧的问题。
传统搜索引擎虽然改变了信息分发方式,但用户最终仍需要点击网页,访问新闻网站,产生广告收入或者订阅价值。而生成式 AI 直接提供答案,可能减少用户回到原始内容来源的需求。
微软 CEO Satya Nadella 在相关证词中承认,聊天机器人能够让用户直接获得答案,从而减少访问原始来源的可能性。这意味着 AI 不只是一个新的信息入口,它可能成为搜索生态的替代层。
对于内容平台而言,最大的风险并不是 AI 使用了自己的内容,而是 AI 可能改变用户获取信息的方式。
如果越来越多用户选择直接向 AI 提问,而不是阅读原始文章,那么内容生产者过去依赖的流量模式可能受到冲击。
微软内部文件将这种情况称为“死亡循环”:AI 获取内容生产者创造的信息,降低这些内容生产者的收入,导致高质量内容减少,最终影响 AI 自身的数据来源。
这个逻辑并非没有现实依据。
过去十多年,互联网已经经历过类似变化。社交平台和算法推荐体系提高了内容传播效率,但也改变了媒体行业的商业模式。大量传统媒体机构面临广告收入下降、订阅压力增加的问题。
AI可能进一步放大这一趋势。
“死亡循环”是否会发生,取决于AI与内容生态能否重新建立平衡
不过,将 AI 训练直接定义为“盗窃”仍然存在争议。
从法律角度来看,美国版权制度并没有简单禁止所有未经授权的数据使用。OpenAI 和微软目前的核心观点是,使用公开网络内容训练 AI 属于合理使用范围。
合理使用(fair use)是美国版权法中的重要原则,通常需要综合考虑使用目的、作品性质、使用比例以及是否影响原作品市场等因素。
AI训练是否符合合理使用,目前仍处于法律争论阶段。
支持 AI 公司的一方认为,大模型并不是简单复制内容,而是在大量数据基础上学习模式,类似人类阅读大量书籍后形成知识体系。如果任何公开内容都需要逐一授权,AI产业的发展成本可能大幅增加,创新速度也可能受到限制。
反对者则认为,AI公司正在利用大量受版权保护内容建立商业产品,而这些产品未来可能直接替代内容生产者,因此不能简单类比人类学习过程。
双方争议的核心,不是 AI 是否应该发展,而是 AI 发展的收益应该如何分配。
事实上,部分行业已经开始探索新的合作方式。
一些新闻机构选择与 AI 公司建立授权协议,通过许可内容获得收入。例如,部分媒体集团与 OpenAI 达成内容合作,让 AI 产品能够合法使用新闻资料,同时为内容提供方创造新的商业渠道。
这说明未来可能并不是“AI 与内容行业二选一”,而是建立新的授权和收益模式。
真正困难的是,互联网内容规模巨大,创作者数量庞大,如何建立高效率、低成本的授权机制仍然是一个复杂问题。
如果每一次 AI 训练都需要逐一获得许可,技术发展可能受到限制;但如果完全不考虑内容创造者权益,长期来看也可能削弱 AI 最重要的数据来源。
AI时代最大的竞争,不只是模型能力,而是价值体系设计能力
过去几年,AI行业的竞争主要围绕模型参数、推理能力和商业落地展开。
但随着技术进入成熟阶段,新的竞争焦点正在出现:谁能够建立更加稳定的生态关系。
人工智能并不是脱离社会运行的独立技术。它需要能源、芯片、数据、人才,也需要大量人类创造的知识资产。
如果 AI 只关注如何获得更多数据,而忽视内容生产者的长期利益,那么它可能面临一个结构性问题:今天的数据来源,可能成为未来发展的限制因素。
互联网过去二十年的经验已经证明,任何技术平台最终都需要解决利益分配问题。
搜索引擎需要与网站建立流量关系,社交平台需要依靠创作者生态维持活跃,视频平台需要通过广告和分成吸引内容生产者。
AI也无法例外。
未来的大模型竞争,不仅取决于谁拥有更强的算法,也取决于谁能够建立更可持续的数据生态。
因此,微软内部关于“最大规模劳动力盗窃”的讨论,真正值得关注的并不是这句话本身是否准确,而是它揭示出的产业矛盾:人工智能正在快速吸收过去互联网时代积累的知识财富,但新的价值交换机制尚未完全形成。
AI的发展不会因为版权争议而停止,但它必须回答一个问题:当机器越来越依赖人类创造的内容时,人类创造者应该如何继续参与这场技术革命带来的价值增长?
这可能是生成式人工智能进入下一个阶段时,整个行业必须面对的核心命题。
参考来源
The New York Times v. Microsoft Corporation and OpenAI, Inc. Copyright Litigation Court Documents
The New York Times, “The Times Sues OpenAI and Microsoft Over A.I. Use of Copyrighted Work”
United States Copyright Office, “Copyright and Artificial Intelligence” Reports
OpenAI, “Copyright and AI: How OpenAI Uses Content in Training Models”
Microsoft Official Statements Regarding AI Training and Copyright Issues
Reuters, Coverage of AI Copyright Litigation and Media Industry Impact
The Verge, Reporting on OpenAI, Microsoft and Publisher Relationships
Financial Times, Analysis of Generative AI and Content Industry Transformation
14
·
--
Ver tradução
ME News 消息,9 月 20 日(UTC+8), Citrini 分析师 jukan 在 X 平台发文表示,三星电子预计明年将至少把 HBM4 和 HBM4E 产量提升至今年的两倍,并计划将用于 HBM 生产的玻璃载板外包清洗量从今年每月 2 万片增至明年每月 5 万片。 三星电子今年 2 月已开始量产出货 HBM4,并于 5 月向包括英伟达在内的客户提供 HBM4E 12 层堆叠样品。行业预计,三星电子 HBM 月均晶圆投入量将从今年约 18 万片增至明年约 25 万片,HBM4 系列出货占比或从约 40%升至约 80%。(来源:ME)
ME News 消息,9 月 20 日(UTC+8), Citrini 分析师 jukan 在 X 平台发文表示,三星电子预计明年将至少把 HBM4 和 HBM4E 产量提升至今年的两倍,并计划将用于 HBM 生产的玻璃载板外包清洗量从今年每月 2 万片增至明年每月 5 万片。 三星电子今年 2 月已开始量产出货 HBM4,并于 5 月向包括英伟达在内的客户提供 HBM4E 12 层堆叠样品。行业预计,三星电子 HBM 月均晶圆投入量将从今年约 18 万片增至明年约 25 万片,HBM4 系列出货占比或从约 40%升至约 80%。(来源:ME)
3
·
--
Ver tradução
ME AI 消息,AI领域观察者Haider转发内容称,Fields Medal得主Cédric Villani曾于2026年6月表示LLM并不具备智能、无法理解其生成内容,但在9月19日又表示,OpenAI解决千禧年大奖难题的成果令其震撼,并称这可能是数学史上前所未有的巨大冲击。(来源:ME)
ME AI 消息,AI领域观察者Haider转发内容称,Fields Medal得主Cédric Villani曾于2026年6月表示LLM并不具备智能、无法理解其生成内容,但在9月19日又表示,OpenAI解决千禧年大奖难题的成果令其震撼,并称这可能是数学史上前所未有的巨大冲击。(来源:ME)
16
·
--
Ver tradução
ME AI 消息,美国驻中东多国大使馆19日发布新的安全警报称,也门胡塞武装同沙特阿拉伯的军事冲突有可能“迅速升级”。 安全警报称,也门胡塞武装对沙特发动了新一轮袭击,军事冲突有可能“迅速升级”,建议身处中东地区的美国人“保持高度警惕”,并为可能出现的旅行中断做好准备。(新华社)(来源:ME)
ME AI 消息,美国驻中东多国大使馆19日发布新的安全警报称,也门胡塞武装同沙特阿拉伯的军事冲突有可能“迅速升级”。 安全警报称,也门胡塞武装对沙特发动了新一轮袭击,军事冲突有可能“迅速升级”,建议身处中东地区的美国人“保持高度警惕”,并为可能出现的旅行中断做好准备。(新华社)(来源:ME)
2
·
--
Ver tradução
ME AI 消息,高盛研究部高级顾问Dominic Wilson与全球风险主管Josh Schiffrin在高盛播客节目中表示,市场目前定价的约四次累计加息”明显偏多”,两人均认为本轮加息周期实际落地次数更可能为两次。 (来源:ME)
ME AI 消息,高盛研究部高级顾问Dominic Wilson与全球风险主管Josh Schiffrin在高盛播客节目中表示,市场目前定价的约四次累计加息”明显偏多”,两人均认为本轮加息周期实际落地次数更可能为两次。 (来源:ME)
15
Inicia sessão para explorar mais conteúdos
Junta-te a utilizadores de criptomoedas de todo o mundo na Binance Square
⚡️ Obtém informações úteis e recentes sobre criptomoedas.
💬 Com a confiança da maior exchange de criptomoedas do mundo.
👍 Descobre perspetivas reais de criadores verificados.
E-mail/Número de telefone
Tópicos em Tendência
BOJRaisesRatesTo31YearHigh
124,421 visualizações
1,947 a discutir
#BOJRaisesRatesTo31YearHigh
#BOJRaisesRatesTo31YearHigh 🇯🇵📈
O Banco do Japão deu mais um grande passo ao aumentar as taxas de juros para o nível mais alto em 31 anos, colocando os mercados globais em alerta. A medida sinaliza uma mudança contínua em relação à política monetária ultraflexível que o Japão mantinha há muito tempo. Taxas japonesas mais altas podem fortalecer o iene, influenciar os rendimentos dos títulos globais e potencialmente afetar os fluxos de capital em diferentes mercados financeiros. Cripto e outros ativos de risco também podem reagir, já que investidores reavaliam a liquidez e a exposição ao risco. Agora, os traders acompanham de perto as próximas declarações do BOJ em busca de pistas sobre decisões futuras de taxas. A volatilidade pode aumentar à medida que os mercados absorvem a mudança de política e seu possível impacto global. #BOJ #Japão #Cripto #Mercados #InterestRates $NVDAB
maqsoodahmed1
·1 gostos
·106 visualizações
BuffettStepsDownAsBerkshireChairman
58,705 visualizações
959 a discutir
XRPExchangeReservesHitSevenYearLow
62,577 visualizações
900 a discutir