


Título original: (A grande migração da IA na China)
Autor original: Sleepy
Há um padrão na história industrial: quanto mais perto estamos de uma mudança de geração, mais fácil fica perceber onde uma tecnologia realmente se desenvolve.
Na Inglaterra das décadas de 1760 e 1770, as máquinas de fiar movidas a água tinham acabado de ser inventadas, e os donos de fábricas rumavam para o norte, em busca de vales fluviais nos dois lados dos Peninos, nos condados de Derbyshire e Lancashire. Naquela época, a máquina a vapor de Watt ainda não havia chegado às fábricas têxteis; as rodas d’água é que acionavam os fusos. Algumas décadas depois, com a disseminação das máquinas a vapor, as fábricas foram se mudando dos vales para perto das minas de carvão e das cidades.
A cada mudança de geração tecnológica, tudo começa com a invenção de um algoritmo, um projeto ou uma máquina; logo em seguida, vem uma grande migração geográfica em busca de eletricidade, água e terras.
Em tempos tranquilos, a cadeia global de suprimentos parece uma rede estendida: é possível acessar capacidade computacional do outro lado do Pacífico, e as pessoas facilmente se iludem, imaginando que software e inteligência não têm peso nem dependem do lugar. Mas, diante de bloqueios e cercos, a nuvem volta à terra e revela sua verdadeira natureza de indústria pesada. Ela precisa de eletricidade, teme o calor, depende das redes e, acima de tudo, é determinada por quem é dono dos chips enfileirados nos racks.
Em 16 de outubro de 1964, em Lop Nur, a primeira bomba atômica da China explodiu com sucesso, sob o codinome «596». Cinco anos antes, em 20 de junho de 1959, o Comitê Central do Partido Comunista da União Soviética escreveu ao Comitê Central do Partido Comunista da China para suspender o fornecimento dos modelos didáticos e dos documentos técnicos da bomba atômica acordados no tratado.
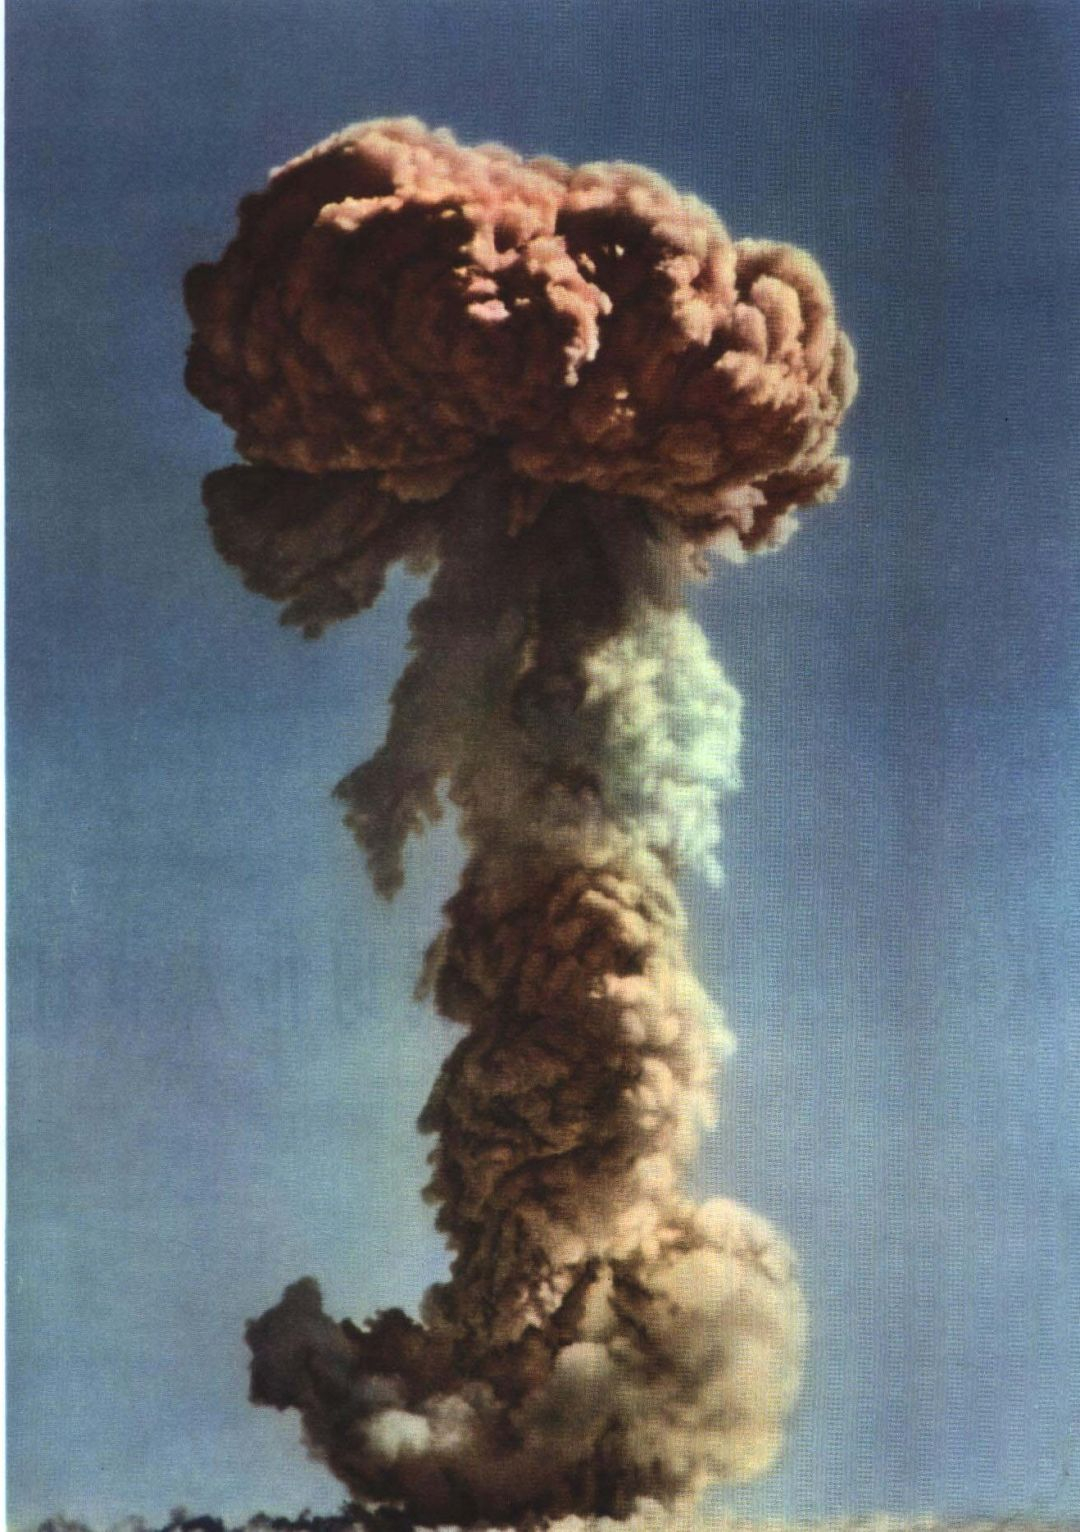
Nuvem em forma de cogumelo da explosão da primeira bomba atômica da China em Lop Nur, em 1964|Fonte: China Pictorial
Quase na mesma época, foram definidos os critérios para a localização do Terceiro Front: junto às montanhas, disperso e oculto; na execução, acrescentaram-se mais duas palavras: entrar nas cavernas. Nos quinze anos seguintes, milhões de trabalhadores, quadros, intelectuais e militares do Exército de Libertação Popular deixaram as cidades do leste e do nordeste para transferir máquinas-ferramentas, altos-fornos e laboratórios para as montanhas do sudoeste e do noroeste. No auge, mais de quatro milhões de pessoas participaram do projeto.
Mais de meio século se passou, e a indústria mais avançada do mundo foi substituída pelos grandes modelos.
Quem treina grandes modelos tem uma tarefa diária obrigatória: salvar checkpoints. Milhares ou dezenas de milhares de placas aceleradoras funcionam sem parar por meses; se até mesmo uma placa cair, o treinamento é interrompido. É preciso salvar periodicamente todos os pesos do modelo, o estado do otimizador e as sementes aleatórias para que, caso algo dê errado, o processo possa ser retomado a partir do checkpoint mais recente.
Em inglês, essa palavra também tem um significado original: posto de controle de fronteira.
Em novembro de 2026, após uma longa busca por chips que atravessou o equador, o setor chinês de grandes modelos chegou ao seu próprio posto de controle.
60 discos rígidos
A história começa com quatro malas voando para Kuala Lumpur.
No início de março de 2025, quatro engenheiros chineses voaram de Pequim para a Malásia. Cada um arrastava uma mala cuidadosamente arrumada com 15 discos rígidos, que continham, ao todo, 80 TB de dados.
O destino era um centro de dados local na Malásia, onde o empregador havia alugado cerca de 300 servidores equipados com chips avançados da Nvidia.
Para este voo, os colegas na China começaram a aperfeiçoar o conjunto de dados e a depurar repetidamente o programa de treinamento com mais de oito semanas de antecedência. Afinal, depois que os dados são colocados nas caixas e saem do país, é muito difícil recomeçar do zero como se fazia em casa, já no centro de dados de um país estrangeiro. E por que não enviá-los pela internet? Porque a transferência pela rede «poderia levar meses» — seria mais rápido levá-los pessoalmente.
De acordo com o plano, o que eles finalmente levariam de volta à China seria muito menor: apenas algumas centenas de GB, os parâmetros do modelo treinado.
Este é o retrato mais cru da primeira migração de capacidade computacional de um grande modelo chinês: como não era possível trazer os chips para dentro, os dados embarcaram num avião para fora do país.
O que levou os engenheiros a embarcar num avião foram as restrições a chips, apertadas passo a passo ao longo de vários anos.
Em 7 de outubro de 2022, os Estados Unidos proibiram pela primeira vez a venda das Nvidia A100 e H100 à China. A Nvidia logo criou versões com menor largura de banda de interconexão para o mercado chinês: as A800 e H800. Apenas um ano depois, em 17 de outubro de 2023, as versões mais lentas também foram barradas.
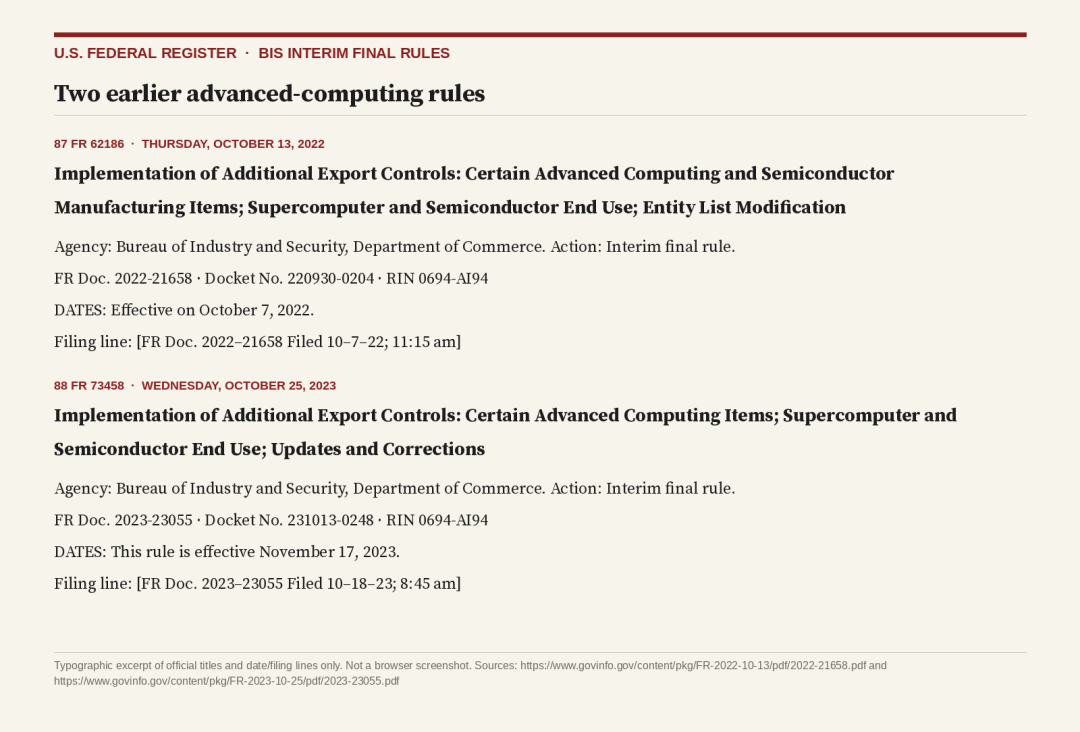
Regras de controle das exportações de chips de computação avançada dos EUA em 2022 e 2023|Fonte: site oficial do governo
Naquele ano, era quase impossível encontrar um chip no mercado chinês. O preço da A100 disparou de cerca de 40 mil yuans no começo do ano para quase 250 mil; na semana seguinte à entrada em vigor das novas regras de outubro, as cotações da H800 quase dobraram, e revendedores chegaram a pedir 2,45 milhões de yuans por um sistema completo com oito placas.
Enquanto isso, a infraestrutura computacional da China passou por uma onda de nascimentos prematuros. Entre 2023 e 2024, várias localidades anunciaram mais de 500 projetos de centros de computação inteligente; até o fim de 2024, pelo menos 150 já estavam em operação.
De um lado, laboratórios com dinheiro vivo não conseguiam comprar chips; do outro, centros de dados locais estavam vazios. O motivo eram os requisitos físicos do treinamento de grandes modelos: modelos de ponta precisam de dezenas de milhares de chips de alto desempenho da mesma geração, conectados por redes de alta velocidade para formar um grande cluster. Já os centros espalhados pelo país tinham, em sua maioria, placas de inferência avulsas e antigas ou GPUs de gerações anteriores, impossíveis de conectar num único conjunto.
Felizmente, os controles de exportação dos EUA da época deixavam uma brecha: regulavam a compra e a venda, mas não o aluguel.
Empresas sediadas na China não podiam comprar chips e trazê-los para o país, mas podiam alugar centros de dados de provedores estrangeiros de nuvem e de proprietários não chineses. O setor logo encontrou uma divisão de tarefas: o pré-treinamento, que mais exige capacidade computacional e largura de banda de comunicação entre os chips, ficava em centros de dados no exterior; depois de treinado o modelo, seus pesos eram levados de volta à China, onde a capacidade computacional local atendia às solicitações cotidianas dos usuários.
Assim que a rota foi estabelecida, o improviso das malas de mão foi rapidamente substituído pela infraestrutura moderna de nuvem.
Mais tarde, os engenheiros nem precisavam mais sair do país. Os clusters de treinamento ficavam em centros de dados no Sudeste Asiático ou no norte da Europa, enquanto as equipes de algoritmos, em seus escritórios em Haidian, Pequim, Yuhang, Hangzhou, ou Xuhui, Xangai, acessavam os sistemas remotamente e digitavam, linha após linha, os comandos de inicialização no terminal.
Os dendezeiros de Johor
Há no céu uma rota invisível chamada «Rota Migratória do Leste Asiático-Australásia».
Ela começa no Extremo Oriente russo e no Alasca, atravessa o Leste e o Sudeste Asiático e se estende até a Austrália e a Nova Zelândia. Passa por 22 países e, todos os anos, mais de 50 milhões de aves aquáticas voam por ela de norte a sul e de volta. As zonas úmidas de manguezal na costa sudoeste de Johor, na Malásia, são um dos pontos de descanso ao longo da rota; Tanjung Piai, ali, é o ponto mais ao sul do continente asiático.
Nos últimos cinco anos, surgiu uma nova espécie de ave migratória de silício nessa rota.
Johor e Singapura são separados apenas pelo estreito de Johor. As terras vermelhas da região já receberam várias gerações de cultivos. Na década de 1940, clãs chineses vindos de Singapura atravessaram o estreito, derrubaram a floresta tropical e plantaram pimenta e gambier; com a chegada dos colonizadores britânicos, as plantações foram substituídas por seringueiras; na segunda metade do século XX, as colinas foram tomadas por dendezeiros.
Hoje, tratores derrubam extensas áreas de dendezeiros para dar lugar à quarta geração de cultivo econômico de Johor: os centros de dados.
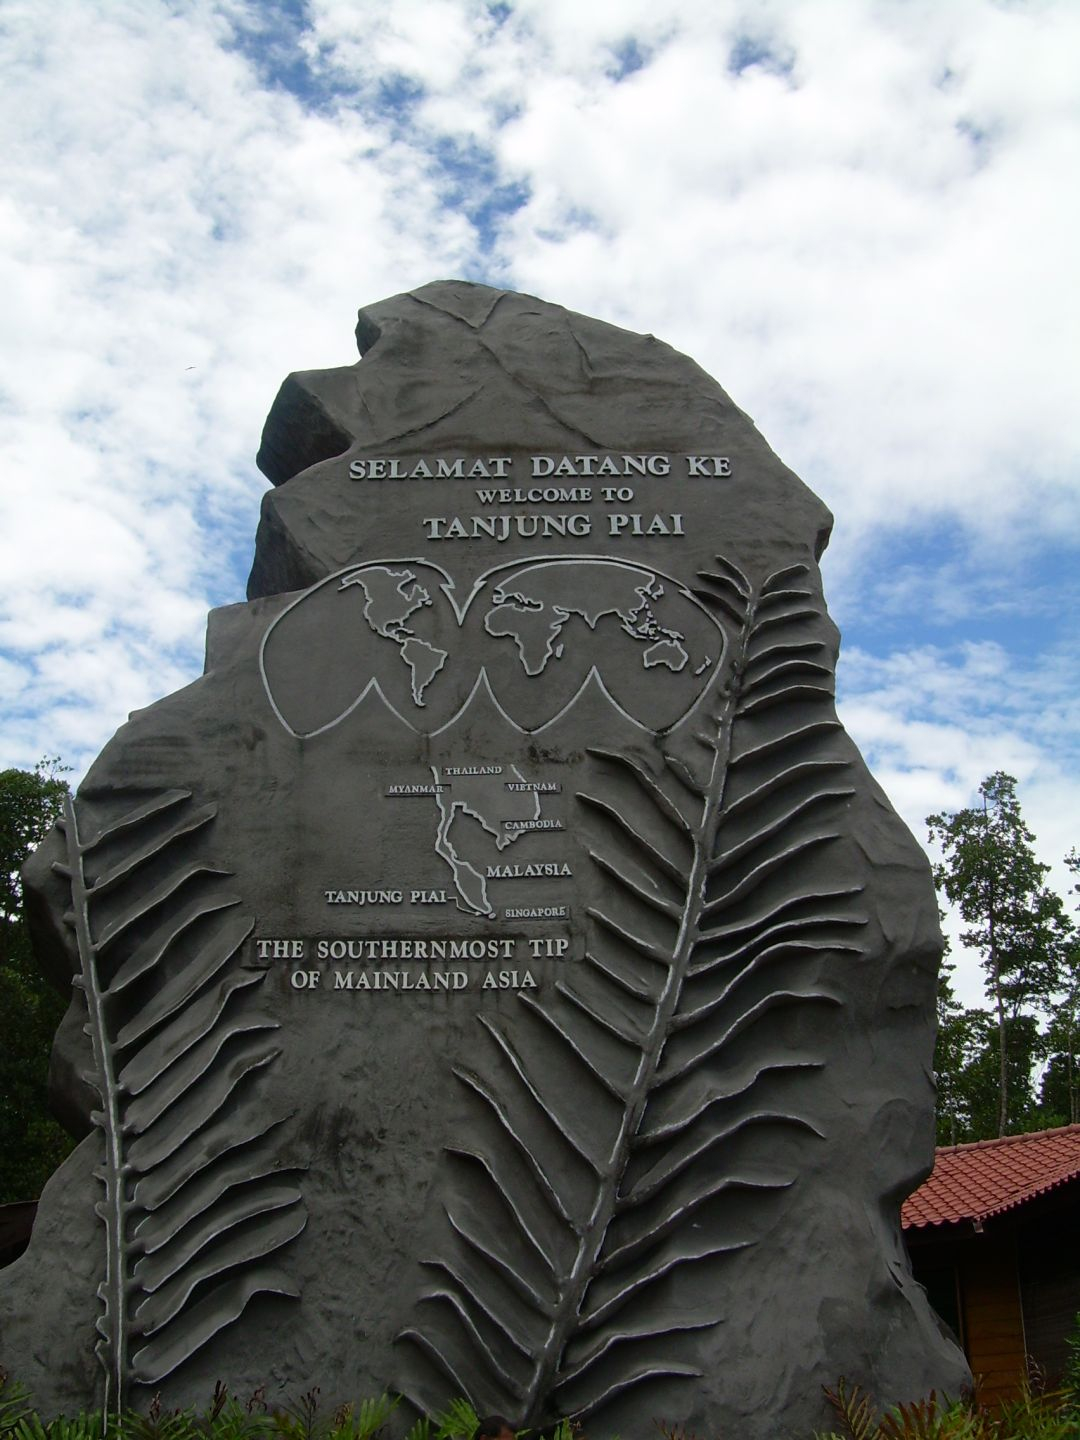
Marco de Tanjung Piai, em Johor, ponto mais ao sul do continente asiático|Fonte: D.W. Fisher-Freberg
Em 2021, a carga de TI em operação online em todo o estado de Johor era de apenas 10 MW. No fim de 2025, o número ultrapassava 900 MW.
O que atraiu as empresas foram os preços muito diferentes dos fatores de produção nas duas margens do estreito.
Singapura tem pouca terra e eletricidade cara; entre 2019 e 2022, chegou a suspender a aprovação de novos centros de dados. Do outro lado do estreito, no parque tecnológico de Sedenak, em Johor, o terreno custa apenas 5,12 dólares singapurianos por pé quadrado, enquanto na região de Tai Seng, em Singapura, custa cerca de 6.000 dólares singapurianos. A eletricidade em Johor também custa aproximadamente metade do preço em Singapura.
O que mais surpreende os concorrentes estrangeiros é a rapidez com que as equipes chinesas de infraestrutura entregam os projetos. Operadoras de capital chinês compram terrenos em Johor, nivelam o solo, instalam a rede elétrica e montam o sistema de refrigeração; em nove a doze meses, os centros de dados já podem entrar em operação. A DayOne e a Bridge Data Centres — que se fundiu com a ChinData e hoje pertence a investidores dos EUA — conquistaram juntas pelo menos 58% da capacidade de TI online de Johor. E, entre as operadoras de capital chinês na região, o maior cliente é a ByteDance.
O posto de controle na longa ponte que liga Johor Bahru, em Johor, a Woodlands, em Singapura, verifica os documentos de centenas de milhares de pessoas todos os dias. É um dos postos de fronteira terrestre mais movimentados do mundo e o checkpoint físico mais conhecido da região. Nos centros de dados nas duas margens do estreito, porém, outro tipo de checkpoint está sendo armazenado em discos rígidos, arquivo após arquivo.
Em novembro de 2025, o Financial Times noticiou que Alibaba e ByteDance treinavam seus modelos mais recentes em centros de dados do Sudeste Asiático, por meio de contratos de aluguel com proprietários não chineses. Na época, um operador de centros de dados de Singapura explicou à imprensa: «Treinar os modelos mais avançados exige os melhores chips, e tudo é feito de forma legal e em conformidade com as regras.»
O think tank americano IFP estimou que, até o fim de 2026, empresas chinesas poderiam acessar remotamente do exterior capacidade computacional equivalente a cerca de um milhão de H100, aproximadamente 75% dela no Sudeste Asiático. Desde 2021, a Malásia aprovou investimentos em centros de dados que somam 95 bilhões de dólares.
A equipe que foi mais longe chegou até a borda do Círculo Polar Ártico. A partir de maio de 2025, uma subsidiária estrangeira da ByteDance alugou 2.304 chips Nvidia B200 na pequena cidade fiorde de Glomfjord, no norte da Noruega. A instalação é alimentada por energia hidrelétrica e tem baixas temperaturas durante todo o ano; esse único contrato da ByteDance representou cerca de três quartos da receita anual da neocloud europeia.
Mas todos sabiam, no fundo, que um teto emprestado não protege da chuva para sempre.
As aves migratórias não voam para o sul para se estabelecer lá.
As duas empresas em 2025
Diante do cerco à capacidade computacional, entre 2025 e 2026 as duas empresas chinesas de grandes modelos mais representativas, Kimi e DeepSeek, seguiram caminhos diferentes.
Na corrida para o sul em busca de chips, a Moonshot AI foi a que mais se empenhou. Nas palavras de uma pessoa informada, a empresa buscava capacidade computacional pelo mundo de forma «extremamente agressiva».
Em julho de 2025, a Moonshot AI lançou o K2, com um trilhão de parâmetros, e completou o pré-treinamento com 15,5 trilhões de tokens usando seu otimizador MuonClip, desenvolvido internamente. Um ano depois, em 16 de julho de 2026, o K3 foi lançado oficialmente, elevando o total de parâmetros a 2,8 trilhões. É o primeiro modelo aberto com pesos do mundo na classe dos 3 trilhões de parâmetros.
Ao avaliar o K3, o pesquisador americano de IA Nathan Lambert observou especificamente que o modelo foi desenvolvido «num ambiente limitado por GPUs». Em conversa com pesquisadores da Kimi, ele comentou, meio brincando, que na OpenAI um pesquisador comum talvez tivesse «milhares de máquinas equivalentes a H100» à disposição — e que seus interlocutores «ficaram chocados».
Com muito menos chips que seus pares do Vale do Silício, a equipe chinesa apresentou resultados que não podiam ser ignorados do outro lado do oceano. Um relatório de 2026 sobre empresas, publicado em novembro pela firma de capital de risco do Vale do Silício Menlo Ventures, mostrou que 89% dos gastos de empresas americanas com grandes modelos de código aberto foram para modelos chineses; só a Kimi ficou com 61% do total.
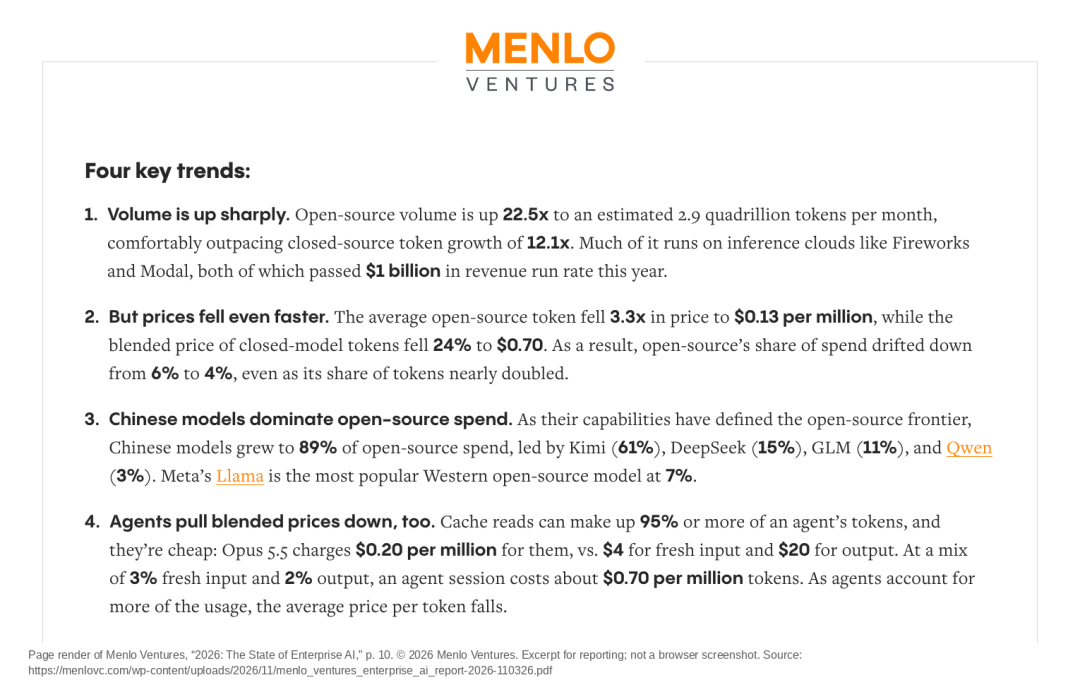
Relatório de IA empresarial da Menlo Ventures de 2026|Fonte: Menlo Ventures
A força do modelo trouxe um problema imediato: não havia chips suficientes.
Apenas três dias após o lançamento do K3, em 19 de julho, a Kimi publicou um aviso sobre a escassez de capacidade computacional e a suspensão temporária da abertura de novas assinaturas. A empresa disse que, nas 48 horas anteriores, as solicitações dos usuários haviam superado em muito as previsões e se aproximado do limite de capacidade do cluster existente. O canal para novos membros precisou ser fechado temporariamente, até que a próxima leva de capacidade estivesse disponível para liberar vagas gradualmente.
Para aliviar a pressão sobre os clusters de inferência, a Moonshot AI recorreu a todas as soluções que conseguiu imaginar. A empresa está negociando com vários provedores americanos de nuvem uma divisão da receita obtida com a hospedagem do K3. Aproveitando os pesos abertos do modelo, os provedores estrangeiros usam suas próprias GPUs para atender às empresas de fora da China que são clientes da Kimi.
Mas o pré-treinamento do próximo modelo principal não pode ser resolvido desviando solicitações. Segundo uma reportagem do The Information no fim de julho, o K4 planejado será muito maior que o K3. A Moonshot AI voltou os olhos para a Indonésia e assinou um contrato de aluguel de cerca de 150 milhões de dólares, reservando um cluster Nvidia Blackwell Ultra B300 num centro de dados indonésio, com previsão de entrada em operação já em 2027. Segundo a reportagem, esses chips estavam destinados ao K4.
Enquanto a Moonshot AI procurava chips por todo o Sudeste Asiático, a DeepSeek, em Hangzhou, escolheu outro caminho.
Em julho de 2024, Liang Wenfeng disse numa entrevista à Dark Current: «O problema que enfrentamos nunca foi o dinheiro, e sim o embargo aos chips de alto desempenho.»
No fim daquele ano, a DeepSeek lançou o V3, treinado com 2.048 H800. O custo calculado do treinamento final foi de apenas cerca de 5,576 milhões de dólares. O relatório técnico afirma que, durante todo o treinamento, «não houve nenhum pico de perda irrecuperável nem qualquer reversão».
Em 20 de janeiro de 2025, o DeepSeek R1 foi lançado e abalou o mundo com sua capacidade de raciocínio, possibilitada pelo aprendizado por reforço. Mas, depois do R1, enquanto seus concorrentes alugavam chips no exterior, a DeepSeek não transferiu para fora do país seu treinamento principal. Uma reportagem do Financial Times de novembro de 2025 revelou que a DeepSeek insistia em treinar na China, com engenheiros da Huawei trabalhando permanentemente em sua sede em Hangzhou.
O preço de ficar onde estava foi passar por dificuldades e esperas muito concretas.
Em 2025, a Huawei enviou uma equipe de engenheiros ao escritório da DeepSeek para ajudá-la a treinar o modelo de raciocínio de próxima geração, o R2, nos chips Ascend fabricados na China. Segundo o Financial Times, o treinamento enfrentou problemas de estabilidade, software e lentidão na comunicação entre chips. O lançamento do R2 foi adiado repetidamente, e o cronograma de treinamento dos modelos de geração multimodal também foi postergado.
Na época, o mundo exterior só viu a DeepSeek desacelerar; poucos entenderam o trabalho preparatório que ela fazia nos bastidores.
Em agosto de 2025, a DeepSeek lançou a versão de transição V3.1. No anúncio, informou que o formato de precisão UE8M0 FP8 adotado pelo modelo havia sido projetado especificamente para «a próxima geração de chips chineses, cujo lançamento é iminente».
Em 24 de abril de 2026, o DeepSeek V4, aperfeiçoado por muito tempo, finalmente entrou no ar. No anúncio de lançamento, a empresa disse que a capacidade de serviço do V4-Pro era limitada pela disponibilidade de computação de alto desempenho e que os preços cairiam quando os supernós Ascend 950 fossem produzidos em massa no segundo semestre.
Olhando para aquele momento, no outono de 2026: uma empresa procurou chips por toda parte e levou seu modelo para as ferramentas usadas por desenvolvedores do mundo inteiro; outra permaneceu na China, trabalhando obstinadamente na arquitetura de base e abrindo caminho para os grandes clusters nacionais. Juntas, as duas trajetórias formaram as asas da IA chinesa durante esse período de transição.
Até que Washington decidiu soldar de vez a porta para o exterior.
16h15
As portas se fecharam uma após a outra nas duas primeiras semanas de novembro de 2026.
Primeiro vieram os avisos verbais. Em 3 de novembro, o Financial Times revelou que a equipe de vendas da Nvidia começou a avisar verbalmente seus parceiros globais de serviços de nuvem de que, nos novos contratos, pelo menos 51% da capacidade teria de ser vendida a clientes não chineses. A exigência não foi formalizada por escrito, mas deixou os proprietários de centros de dados do Sudeste Asiático perplexos: fora dos Estados Unidos, onde encontrariam tantos clientes não chineses?
No dia seguinte, 4 de novembro, a Oracle desistiu de um enorme contrato de aluguel que tinha com a Tencent no Sudeste Asiático. Era um acordo de cinco anos, no valor de cerca de 7 bilhões de dólares, envolvendo aproximadamente 100 mil chips. O negócio fracassou porque autoridades americanas se opuseram.
Em 12 de novembro, Jensen Huang, que comandava a Nvidia havia 33 anos, renunciou ao cargo de CEO em meio à controvérsia. O empresário sino-americano, que havia dito publicamente que a IA chinesa estava «apenas alguns nanossegundos atrás» da americana e que os controles de exportação dos EUA eram «em grande medida contraproducentes», deixou o tabuleiro naquele outono delicado.
Na segunda-feira, 16 de novembro, às 16h15, horário da costa leste dos EUA, o Bureau of Industry and Security do Departamento de Comércio dos Estados Unidos encaminhou ao sistema do Registro Federal uma regra final provisória intitulada Addressing Remote Access to Advanced Semiconductors (Regulamentação do acesso remoto a semicondutores avançados). Ela foi publicada oficialmente em 19 de novembro e entrou em vigor no mesmo dia.
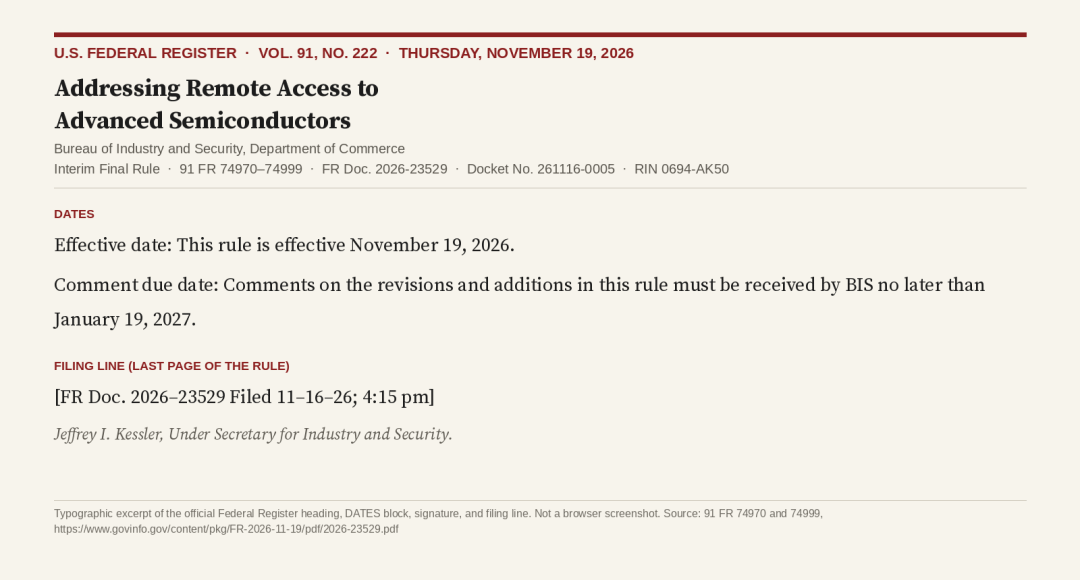
Novas regras sobre acesso remoto a semicondutores avançados|Fonte: site oficial do governo
Por coincidência, naquele mesmo dia, o presidente dos EUA, Donald Trump, participava da reunião informal de líderes da APEC em Shenzhen. Após o encontro, elogiou seu «outstanding personal relationship» (excelente relacionamento pessoal) com o líder chinês.
A regra central tem apenas uma cláusula: para qualquer centro de dados do mundo que forneça mais de 12 milhões de TPP de capacidade computacional a uma empresa com sede na China, incluindo suas subsidiárias no exterior, é preciso obter previamente uma licença do Departamento de Comércio dos EUA para enviar chips avançados à instalação.
Os 12 milhões de TPP equivalem a cerca de 750 chips H100, aproximadamente quatro ou cinco racks.
Já o treinamento de um grande modelo de ponta com um trilhão de parâmetros exige, no mínimo, milhares ou até dezenas de milhares de chips. Quatro ou cinco racks não dão nem para começar.
Para os centros de dados existentes no exterior que já atendem clientes chineses, a nova regra prevê um período de carência de 90 dias para solicitar uma licença; caso contrário, «estarão sujeitos a futuras restrições de exportação». Contados a partir da entrada em vigor, em 19 de novembro, os 90 dias terminam por volta de 17 de fevereiro de 2027.
A nova regra inclui uma cláusula de presunção: se um centro de dados no exterior se recusar a fornecer informações de diligência prévia sobre seus clientes, ou não puder fornecê-las, isso por si só será considerado um «sinal de alerta» e poderá levar à presunção de que o exportador «tinha conhecimento».
Em outras palavras: se você não consegue explicar de quem é o código que roda no centro de dados, presume-se que há algo errado.
Indonésia, Malásia, Singapura, Tailândia e Brasil foram mencionados especificamente. O envio de chips avançados de IA para qualquer um desses cinco países exige uma licença. Se o comprador for uma empresa com sede nos Estados Unidos, o exportador fica isento desde que apresente relatórios mensais.
O corte físico do fornecimento veio logo em seguida. Na teleconferência de resultados da Nvidia, em 17 de novembro, Colette Kress, que assumiu como CEO interina após a saída de Jensen Huang, confirmou: «Já não estamos enviando à China produtos de data center Hopper licenciados.» Segundo o Financial Times, TSMC e Samsung também suspenderam envios a alguns clientes chineses enquanto aguardam licenças.
O Ministério do Comércio da China manifestou forte insatisfação e anunciou que adotaria contramedidas. O porta-voz do Ministério das Relações Exteriores, Guo Jiakun, afirmou que se tratava de «um caso típico de coerção econômica e jurisdição extraterritorial».
Depósito de 50%
Na mesma semana em que as regras comerciais entraram em vigor, a alavancagem financeira também começou a apertar o fluxo de dinheiro para os centros de dados do Sudeste Asiático.
Muita gente imagina que, por trás das neoclouds que se multiplicam pelo Sudeste Asiático, há conglomerados que esbanjam dinheiro. Na realidade, trata-se de um negócio de ativos pesados, altamente dependente de dívidas. Segundo dados da Bloomberg, desde 2023 as empresas de centros de dados da região Ásia-Pacífico contraíram empréstimos que somam cerca de 49 bilhões de dólares. Uma análise do setor de semicondutores estima que de 70% a 80% do financiamento dos projetos de neocloud venha de dívidas. O procedimento comum é o proprietário do centro de dados usar um contrato de aluguel de longo prazo assinado com um grande cliente para obter um empréstimo bancário, comprar chips da Nvidia e pagar o principal e os juros com a receita dos aluguéis.
Nessa cadeia, o percentual do depósito funciona como um termômetro do risco geopolítico.
No mercado de capacidade computacional no exterior, um cliente comum que aluga um cluster de servidores Nvidia B300 paga, segundo a prática do setor, um depósito de cerca de 15%.
Já quando a Moonshot AI assinou na Indonésia o contrato de aluguel de 150 milhões de dólares para os B300, concordou em pagar antecipadamente um depósito de 50% para garantir os chips, que só seriam entregues em 2027.
No começo de novembro, segundo a CNBC, enquanto a Moonshot AI negociava na Europa o aluguel de mais de 8.000 chips Blackwell, alguém chegou a propor que ela pagasse um adiantamento 30% a 50% maior que o de clientes não chineses.
A nova regra de 19 de novembro eliminou diretamente a contraparte para esse negócio com preço premium.
Segundo o The Information, após a publicação da nova regra, a Moonshot AI cancelou o contrato de 150 milhões de dólares na Indonésia e suspendeu as negociações de outros novos acordos. O projeto de chips no exterior preparado para o K4 foi abandonado.
Mais problemático do que cancelar o aluguel foi o corte dos empréstimos pelos bancos.
Em 17 de novembro, a Bloomberg revelou que um empréstimo de 480 milhões de dólares da provedora de nuvem singapurense Aolani Cloud havia sido congelado. O dinheiro seria usado para comprar GPUs da Nvidia e instalá-las num centro de dados da Malásia que atende à ByteDance. Segundo notícias anteriores, havia cerca de 36 mil B200 envolvidos na parceria entre as duas empresas na Malásia. O DBS Bank, de Singapura, era o principal credor; assim que surgiram notícias sobre as novas regras, os cinco credores começaram a discutir sua retirada.
Outra provedora de nuvem, a GMI Cloud, havia tomado emprestados 300 milhões de dólares para construir na Tailândia instalações de computação para atender à Tencent. O contrato de empréstimo dizia explicitamente que, se a Tencent fosse incluída numa lista de restrições dos EUA, os credores teriam o direito de exigir o pagamento antecipado.
Sob forte pressão para cumprir as regras, os governos do Sudeste Asiático começaram a recuar. Johari Abdul Ghani, ministro do Investimento, Comércio e Indústria da Malásia, disse à CNBC: «Se quiser continuar no jogo, você precisa seguir as regras dos EUA.» O vice-ministro do Comércio da Tailândia declarou publicamente que projetos novos sem aprovação americana «talvez não possam ser concluídos». O Ministério do Desenvolvimento Digital e Informação e o Ministério do Comércio e Indústria de Singapura afirmaram em comunicado conjunto que «não permitirão que empresas usem sua associação com Singapura para contornar ou violar as leis de outros países».
A reação dos mercados de capitais foi rápida. No próprio dia 17 de novembro, duas ações malaias ligadas a centros de dados caíram quase 20% durante o pregão, e a gigante de serviços públicos YTL Power recuou quase 10%.
No mesmo dia, no mercado de Hong Kong, na China, as ações da SMIC subiram 7%.
Na verdade, bem antes de Washington fechar as portas, Pequim já havia começado a orientar ativamente o setor a voltar para casa.
Em setembro de 2025, a Administração do Ciberespaço da China exigiu que ByteDance, Alibaba e outras empresas parassem de comprar e testar a RTX Pro 6000D da Nvidia, feita especialmente para o mercado chinês. Em novembro, projetos estatais de centros de dados receberam a ordem de usar apenas chips fabricados na China. Províncias ocidentais que são polos de capacidade computacional — como Gansu, Guizhou e Mongólia Interior — ofereceram subsídios de eletricidade de até 50% para centros de dados que adotassem chips nacionais. Em janeiro de 2026, depois que os EUA autorizaram condicionalmente a venda da H200, a alfândega chinesa informou aos despachantes que a H200 «não teria autorização de entrada».
De um lado, Washington trancava os centros de dados no exterior; do outro, a China fechava firmemente a porta dos fundos dos chips feitos sob medida. A estratégia de treinar fora e fazer inferência dentro, mantida por três anos, chegou ao fim com o corte em ambas as margens do Pacífico.
Os chips foram consumidos pelos usuários
Voltemos à China. Para entender a urgência dessa grande migração no fim de 2026, é preciso primeiro compreender outro tipo de tormento, doce e doloroso, que os laboratórios chineses atravessam: o crescimento dos usuários foi tão rápido que consumiu até os chips destinados à pesquisa e ao desenvolvimento.
Às 0h11 de 4 de março de 2026, Lin Junyang, responsável técnico pelo Qwen da Alibaba, publicou uma breve frase em inglês no X: «me stepping down. bye my beloved qwen.»
Oficialmente, a saída de Lin Junyang foi atribuída a divergências sobre a reorganização de responsabilidades; a capacidade computacional foi apenas um pano de fundo. Mas, numa conversa do setor dois meses antes, ele havia desabafado sobre uma ansiedade compartilhada por muitos responsáveis técnicos na linha de frente: disse que só atender às demandas cotidianas já consumia a maior parte da capacidade computacional da equipe, deixando pouquíssimos chips para a verdadeira exploração de tecnologias de ponta.
A ByteDance também enfrentava essa mesma tensão internamente.
Em agosto de 2026, segundo o LatePost, a ByteDance chegou a discutir seriamente o treinamento de um supermodelo com mais de 50 trilhões de parâmetros. Depois de fazer o balanço de seus recursos, concluiu que a capacidade computacional disponível «já não sustentaria pesquisas paralelas em várias frentes». Em seguida, a equipe Seed iniciou internamente um processo de consolidação da arquitetura.
Por que até gigantes como ByteDance e Alibaba, que estão entre as empresas com mais dinheiro, sentem que não têm chips suficientes?
Porque 2026 foi o ano em que os aplicativos de IA chineses realmente entraram no cotidiano da população. Depois do Ano-Novo Lunar, o Doubao, da ByteDance, ultrapassou de uma só vez a marca de 200 milhões de usuários ativos diários. Uma base tão ativa gera altos custos de inferência e pressão operacional. Segundo o 36Kr, a ByteDance, geralmente hábil em comprar tráfego e publicidade, manteve baixo o orçamento de promoção do Doubao neste ano; atrair mais usuários só tornaria ainda mais escassos os chips para inferência.
No setor de grandes modelos, o pré-treinamento e a inferência cotidiana disputam a mesma reserva de capacidade computacional. Quanto mais os usuários utilizam os modelos, menos chips ficam disponíveis para treinar a próxima geração.
Esse «problema feliz» se manifesta de forma ainda mais dramática nas startups.
Em 16 de fevereiro de 2026, após o lançamento do modelo principal GLM-5 da Zhipu AI, a enxurrada de solicitações simultâneas superou o limite previsto. Embora a Zhipu já tivesse ampliado várias vezes seus clusters de chips nacionais e limitado as vendas do pacote Coding Plan, os serviços online ainda apresentavam filas e lentidão. A empresa teve de solicitar publicamente apoio de fabricantes de chips, parceiros de capacidade computacional e provedores de serviços de inferência.
A MiniMax, que não constrói centros de dados próprios e depende de compras de provedores de nuvem, também está aumentando rapidamente seu orçamento. Em 26 de agosto de 2026, a empresa assinou um aditivo com a Alibaba Cloud, elevando de uma só vez os limites anuais de compras para o período de 2026 a 2028: de 115 milhões, 125 milhões e 135 milhões de dólares, respectivamente, para 300 milhões, 400 milhões e 500 milhões. O fundador Yan Junjie admitiu num podcast estrangeiro: «Para nós, especialmente para uma empresa chinesa de IA, a capacidade computacional sempre é uma restrição.»
Em setembro, até a DeepSeek, conhecida pela eficiência de engenharia, começou a direcionar os usuários para outros serviços. Ela passou a encaminhar as solicitações que antes usavam o V4-Pro para o recém-lançado V4.1-Flash. Em 16 de novembro, «o limite de uso da DeepSeek foi atingido» chegou aos assuntos mais comentados do Weibo; muitos usuários intensivos atingiram o limite depois de menos de duas horas de conversa contínua.
Compreendida essa relação entre oferta e demanda, fica mais fácil entender por que, no segundo semestre de 2026, havia no ar na China uma sensação sutil de que todos estavam se preparando para algo.
Naqueles meses, as versões menores e os modelos Flash de cada empresa foram atualizados rapidamente, enquanto os modelos principais de parâmetros gigantescos desaceleraram. Em 31 de agosto, a Zhipu anunciou o GLM-6, mas não informou uma data de lançamento. A versão Pro da MiniMax, com cerca de três trilhões de parâmetros, estava planejada, segundo relatos, para o terceiro trimestre, mas ainda não apareceu. A DeepSeek lançou o V4.1-Flash, mas ainda não o V4.1-Pro.
Ao mesmo tempo, a guerra de preços das APIs, que dois anos antes ignorava os custos, chegou ao fim. Segundo estimativas, no segundo trimestre de 2026 o preço médio de entrada das APIs de grandes modelos na China era cerca de 48% maior que no primeiro trimestre de 2025, e o preço de saída, cerca de 80% maior. Nos horários de pico, o preço de saída da DeepSeek chegou a 4,5 vezes o valor original.
Zhu Xiaohu chegou a declarar: «Este talvez seja o último ano dos modelos básicos de grande porte.»
Mas, a nosso ver, essa conclusão inverte justamente a causa e o efeito.
Os modelos principais reduziram o ritmo de lançamento e os preços das APIs voltaram à normalidade não porque os modelos básicos tenham atingido um limite, mas porque os grandes modelos chineses saíram dos laboratórios e entraram de verdade em cenários reais usados por centenas de milhões de pessoas e nas ferramentas de desenvolvedores do mundo todo.
O instituto de pesquisa Epoch AI estima que, entre 2022 e meados de 2026, a China recebeu apenas cerca de um décimo da nova capacidade computacional de IA instalada no mundo. Mas, segundo dados do Hugging Face, a maior comunidade de código aberto do planeta, entre fevereiro de 2025 e fevereiro de 2026, mais de 40% dos downloads de modelos em toda a plataforma eram de modelos desenvolvidos por equipes chinesas.
Com um décimo da capacidade computacional adicional do mundo, a China sustentou mais de 40% dos downloads globais de modelos de código aberto e o uso diário de centenas de milhões de pessoas no país.
Além disso, as rígidas restrições de capacidade computacional acabaram levando os engenheiros chineses a desenvolver grande competência em otimização de arquitetura e engenharia de sistemas. Um especialista do setor citado pelo Caixin estima que modelos menores, profundamente ajustados com harnesses, podem alcançar quase 90% da capacidade de um grande modelo a cerca de 4% do custo.
Como avaliou Dylan Patel, da SemiAnalysis, poucos dias antes de as novas regras entrarem em vigor em novembro: «Em termos de capacidade, a Moonshot AI provavelmente está no mesmo nível dos laboratórios americanos; o que lhes falta bastante é capacidade computacional e infraestrutura de implantação.»
Agora, esse grupo de engenheiros que melhor sabe economizar o uso dos chips está prestes a se mudar coletivamente para a base dos chips fabricados na China.
Alinhamento de precisão
Migrar do ecossistema CUDA da Nvidia para uma base computacional chinesa não é uma mudança que se faça com uma ordem administrativa. É, antes de tudo, um desafio de engenharia fundamental, extremamente técnico e minucioso a ponto de envolver cada bit.
Para os engenheiros de chips e frameworks, o primeiro obstáculo infernal ao voltar para casa se chama «alinhamento de precisão».
Em condições ideais, se a mesma arquitetura de modelo receber o mesmo conjunto de dados de treinamento, as curvas de redução da perda ao rodar numa GPU da Nvidia e numa NPU Ascend da Huawei deveriam se sobrepor perfeitamente, como duas folhas de papel vegetal.
Mas, no mundo real da engenharia, basta uma pequena diferença na precisão numérica do hardware subjacente ou na ordem de redução dos operadores de comunicação para que as duas curvas se afastem bastante.
A iFlytek foi uma das primeiras empresas chinesas a dominar esse trabalho árduo.
No relatório de atividades com investidores de abril de 2026, a iFlytek expôs a diferença objetiva entre as duas gerações de hardware. Na época, a Ascend 910B, usada como placa principal, tinha 64 GB de memória por chip, enquanto a Nvidia H200 tinha 141 GB; a largura de banda de memória era de 1,6 TB/s contra 4,8 TB/s. Sem qualquer ajuste, a eficiência de treinamento da iFlytek no cluster 910B era de apenas cerca de 30% da obtida num cluster Nvidia A800 de tamanho equivalente.
A iFlytek trabalhou em estreita colaboração com a Huawei, reescrevendo e otimizando os operadores um a um. Em 2025, conseguiu elevar a eficiência de treinamento de aprendizado por reforço com cadeias longas de raciocínio de 30% para 84%, e a eficiência de ponta a ponta do treinamento de modelos MoE nativos da Ascend para 93%. Mesmo assim, o tempo necessário para adaptação continuava sendo um fator real. A iFlytek escreveu no relatório que, quando surge um novo algoritmo popular no cenário internacional, ele pode ser executado diretamente em placas Nvidia, mas, nas placas chinesas, é preciso resolver também problemas como a otimização da eficiência das bibliotecas de operadores, o que normalmente acrescenta de três a seis meses de adaptação.
Em outubro de 2026, Liu Qingfeng, presidente da iFlytek, disse: «Não queremos que a iFlytek seja a única empresa a treinar com capacidade computacional chinesa.»
Liu Qingfeng não precisou esperar muito. A DeepSeek, que naquele ano havia escolhido permanecer no país, avançou bastante nesse caminho durante o outono.
Olhando para trás, o revés da migração do R2 enfrentado pela DeepSeek em 2025 não foi uma derrota; tornou-se, pelo contrário, a experiência mais valiosa de exploração e aprendizado para todo o setor chinês de grandes modelos.
No dia do lançamento do DeepSeek V4, em abril de 2026, os chips Ascend já ofereciam suporte à inferência desde o primeiro momento, e o principal kernel de paralelismo de especialistas havia sido validado tanto no hardware da Nvidia quanto no da Ascend. Em julho, uma equipe de pesquisa liderada pela Huawei, com a participação de instituições como o Instituto Hetao de Shenzhen, anunciou ter executado por completo o pós-treinamento de todos os parâmetros do modelo DeepSeek V4-Pro, de 1,6 trilhão de parâmetros, num cluster de cerca de mil chips Ascend 910C. A execução contínua durou cerca de um mês e envolveu mais de 1.500 etapas, sem «pular etapas nem gerar NaN». A utilização da capacidade computacional do modelo manteve-se estável em 34,9%, com 27 segundos por etapa.
Em 30 de setembro, na véspera do feriado do Dia Nacional, a DeepSeek anunciou oficialmente a abertura do código de um conjunto completo de componentes centrais de baixo nível para a plataforma Ascend, com correspondentes um a um para a versão Nvidia: das ferramentas de compilação TileLang às bibliotecas de computação e comunicação distribuída.
Para se adaptar às características de acesso à memória dos chips nacionais, a DeepSeek chegou a modificar proativamente a disposição da memória KV cache em sua conhecida implementação de atenção FlashMLA. Ela passou a armazenar juntos os valores e os fatores de escala, apenas para reduzir o número de acessos à memória feitos pelos chips Ascend.
No paradigma que prevaleceu no Vale do Silício, as empresas de modelos sempre escreviam o código de acordo com a arquitetura de hardware definida pela Nvidia. Em Hangzhou, em 2026, os principais laboratórios de modelos começaram a reestruturar proativamente seus operadores de baixo nível para aproveitar as características dos chips nacionais.
Além disso, Huawei e DeepSeek estão construindo juntas um supernó com 128 placas baseado na Ascend 950.
O laboratório da SemiAnalysis acendeu e testou, neste ano, um chip de teste Huawei Ascend 950PR. O consumo foi de 203,3 watts, a temperatura central chegou a 56 °C e pouco mais de 5 GB dos 128 GB de memória HBM de alta largura de banda instalados na placa foram utilizados. Sob carga total, o consumo ficou em torno de 600 watts. Na operação mais exigente, a multiplicação de matrizes, sua utilização medida chegou a 41,5% do limite teórico; para comparação, a clássica Nvidia H100 alcança 46,8%.
Além da DeepSeek, toda a frota chinesa de grandes modelos está substituindo o código de base. O Kimi K3, da Moonshot AI, usa treinamento ciente de quantização desde a etapa de ajuste fino supervisionado; no primeiro dia do lançamento, o GLM-5 da Zhipu já estava adaptado aos chips nacionais de sete fabricantes, entre eles Huawei Ascend, Cambricon, Hygon e Kunlun; nos repositórios de código dos principais laboratórios, os operadores exclusivamente CUDA estão cada vez mais raros, enquanto soluções multiplataforma como TileLang se tornam mais comuns.
As duas árvores tecnológicas nas margens opostas do Pacífico estão criando raízes independentes, começando pelos formatos de precisão e pela disposição da memória.
O inverno em Ulanqab
Em 17 de fevereiro de 2022, a Comissão Nacional de Desenvolvimento e Reforma e outros três departamentos publicaram conjuntamente um documento que lançava a construção de polos nacionais de computação em oito regiões: Pequim-Tianjin-Hebei, Delta do Yangtzé, Grande Baía Guangdong-Hong Kong-Macau, Chengdu-Chongqing, Mongólia Interior, Guizhou, Gansu e Ningxia. Também foram planejados dez clusters nacionais de centros de dados. O projeto «Computação do Leste, Dados do Oeste» começou oficialmente naquele dia.
Às vezes, a história reserva coincidências surpreendentes. Quase exatamente cinco anos depois, por volta de 17 de fevereiro de 2027, termina o prazo de 90 dias que as novas regras americanas concederam aos centros de dados existentes no exterior.
Cinco anos atrás, quando documentos mencionaram lugares do oeste e do norte como Helingeer, Qingyang, Gui'an e Zhongwei, muita gente pensou que se tratava apenas de um projeto rotineiro de redistribuição de energia: a terra e a energia no leste estavam cada vez mais escassas, enquanto o oeste e as regiões além da Grande Muralha tinham vento e sol de sobra.
Cinco anos depois, quando as portas dos centros de dados no exterior se fecharam, as pessoas olharam para cima e perceberam que as bases para receber o retorno da IA chinesa ao norte já haviam sido instaladas nas estepes e planaltos de loess do norte e nas cavernas das montanhas do sudoeste.
Em Qingyang, Gansu, centros de computação inteligente se ergueram sobre os antigos planaltos de loess. Tarefas de treinamento e inferência do Qwen, da Alibaba, da Zhipu e da Kimi funcionam ali dia e noite.
Em Gui'an, Guizhou, a Tencent construiu seu principal centro de dados diretamente dentro de uma montanha. A espessa rocha mantém a temperatura estável em 15 °C durante todo o ano. Mais de 80% dos novos chips Ascend da Huawei Cloud foram enviados para Gui'an, que também abriga a maior implantação dos supernós Ascend CloudMatrix384 da Huawei. Há mais de meio século, as montanhas de Guizhou escondiam as fábricas ruidosas do Terceiro Front; hoje, as mesmas montanhas abrigam fileiras e mais fileiras de capacidade computacional chinesa, com luzes indicadoras piscando.
Em Helingeer, na Mongólia Interior, foi anunciado em 14 de outubro deste ano o primeiro pool mundial de dez mil chips Ascend 950DT. Na época, ele passava por ajustes integrados do sistema; um único edifício de servidores pode acomodar um cluster de 30 mil chips.
Nessa grande migração para o norte, a estação mais movimentada se chama Ulanqab.
Em mongol, Ulanqab significa «passagem da montanha vermelha». Fica a cerca de 350 quilômetros de Pequim e pode ser alcançada em menos de duas horas de trem de alta velocidade. A altitude é elevada e a temperatura média anual é de apenas 4,3 °C. Durante boa parte do ano, o ar frio do exterior pode ser usado diretamente para refrigerar os centros de dados.
Nas estepes onduladas ao sul da cidade, os centros de dados se sucedem lado a lado. O parque «Xinghe», que o grupo Envision está construindo na região, tem capacidade total planejada de 800 MW. A primeira fase, de 120 MW, foi entregue em apenas um ano, a um custo de construção equivalente a um quinto do de projetos semelhantes nos Estados Unidos.
Ulanqab costumava ser conhecida por uma cultura agrícola: a batata. Zhang Lei, fundador da Envision, disse que quer tornar os tokens dos grandes modelos «tão baratos quanto batatas».
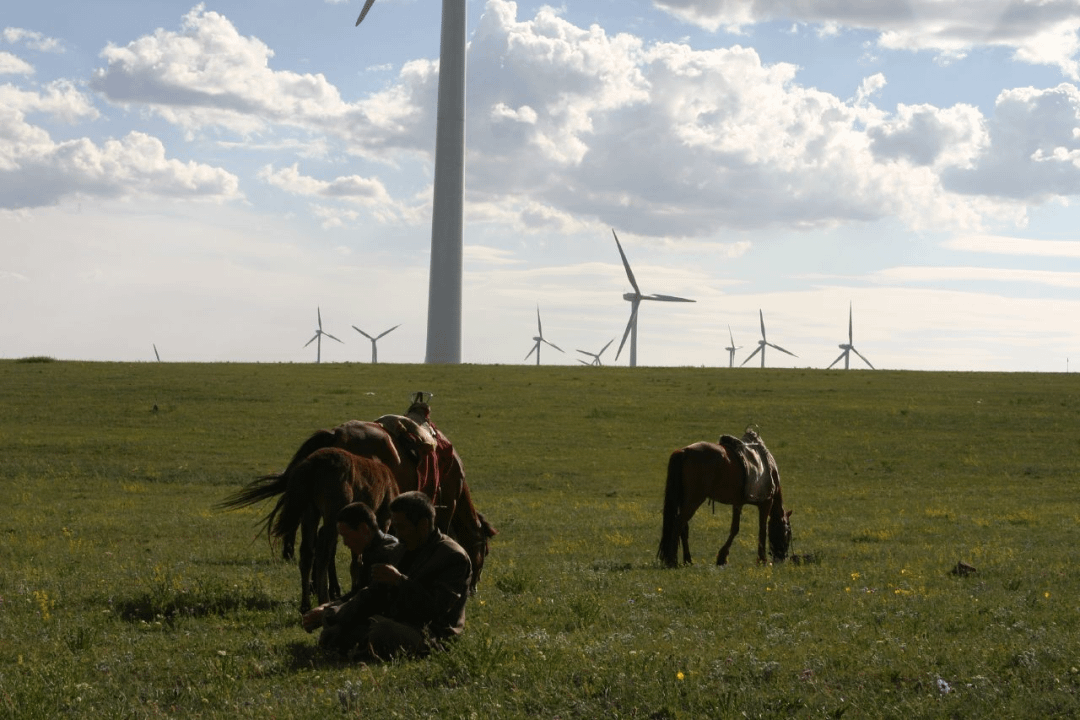
Parque eólico das estepes de Huitengxile, verão de 2007|Fonte: Steven Buss
No fim de novembro, a temperatura noturna em Ulanqab costuma cair para dez graus abaixo de zero. O vento que atravessa as estepes ao sul da cidade faz girar lentamente turbinas eólicas de mais de cem metros de altura. A eletricidade percorre as linhas de transmissão até os centros de dados, onde a temperatura e a umidade são controladas, e acende fileiras de racks recém-instalados.
A estação chuvosa quente e úmida do estreito de Johor, no sul, ainda continua.
Segundo o calendário das estações, as aves migratórias só retornam ao norte no começo da primavera do ano seguinte; desta vez, a capacidade computacional chegou antes delas.
-FIM-
Link para o texto original