

上一篇测的是一笔证明要算多久,有朋友指出我只测了一次算一笔的情况,没测很多笔同时涌进来的时候。真实的机构服务器不会排好队一笔一笔来,所以这次我把 Rayls 的证明服务开起来,让它连续几分钟同时接 1 到 16 笔请求。
先给短答案。以 Rayls Enygma 隐私转账电路的 6 人匿名集为例,一台 4 vCPU 的云服务器可以同时接下 16 笔请求,全部算完,没有一笔失败,但它每秒只能做完 1.3 到 2.3 笔。同时在算的请求超过 2 到 4 笔之后,再多的请求不会更快做完,只会让每一笔都等得更久、占用更多内存:同时 16 笔时,一笔转账的中位等待从 0.5 到 0.9 秒变成 6.7 到 11.8 秒,内存从约 260 MB 涨到 680 到 750 MB。
下面讲这些数字怎么来的、为什么会这样,以及它对一家准备自己跑证明的机构意味着什么。
为什么"同时多少笔"比"一笔多快"更要紧
零知识证明可以理解成一张数学凭证:付款方不公开金额和对手方,也能向网络证明这笔账是对的。生成这张凭证要做大量椭圆曲线运算,几乎全靠 CPU。
上一篇回答的是一笔证明要算多久。但机构的服务器面对的是一批批同时到来的请求。对一个吃满 CPU 的服务来说,同时处理多少笔,决定的是吞吐量、等待时间和内存,这三样才是采购和部署时要算的账。
这个问题不只属于 Rayls。凡是在自己服务器上生成零知识证明的系统,都会遇到同样的取舍,区别只在电路大小和硬件。
怎么测的,任何人都能复现
被测的仍是 Rayls 开源的证明服务 rayls-sovereign-gnark-api,提交 67c4c26,代码一行没改。测试代码在公开仓库 hansonhan0520-lang/enygma-bench,这次新增了一个只用 Go 标准库写的压测工具 loadgen 和脚本 run_load.sh,由 GitHub Actions 自动运行,日志自动存进仓库的 results 文件夹。
压测方式是:把 Rayls 的 HTTP 证明服务原样启动,让 1、2、4、8、16 笔请求同时在算,每档连续压 60 秒,前 5 秒热身不计。每一笔请求的耗时都记下来,并且每 0.1 秒读一次服务进程的内存。最后让 4 笔请求同时在算,连续压 5 分钟,按每 30 秒一段统计。
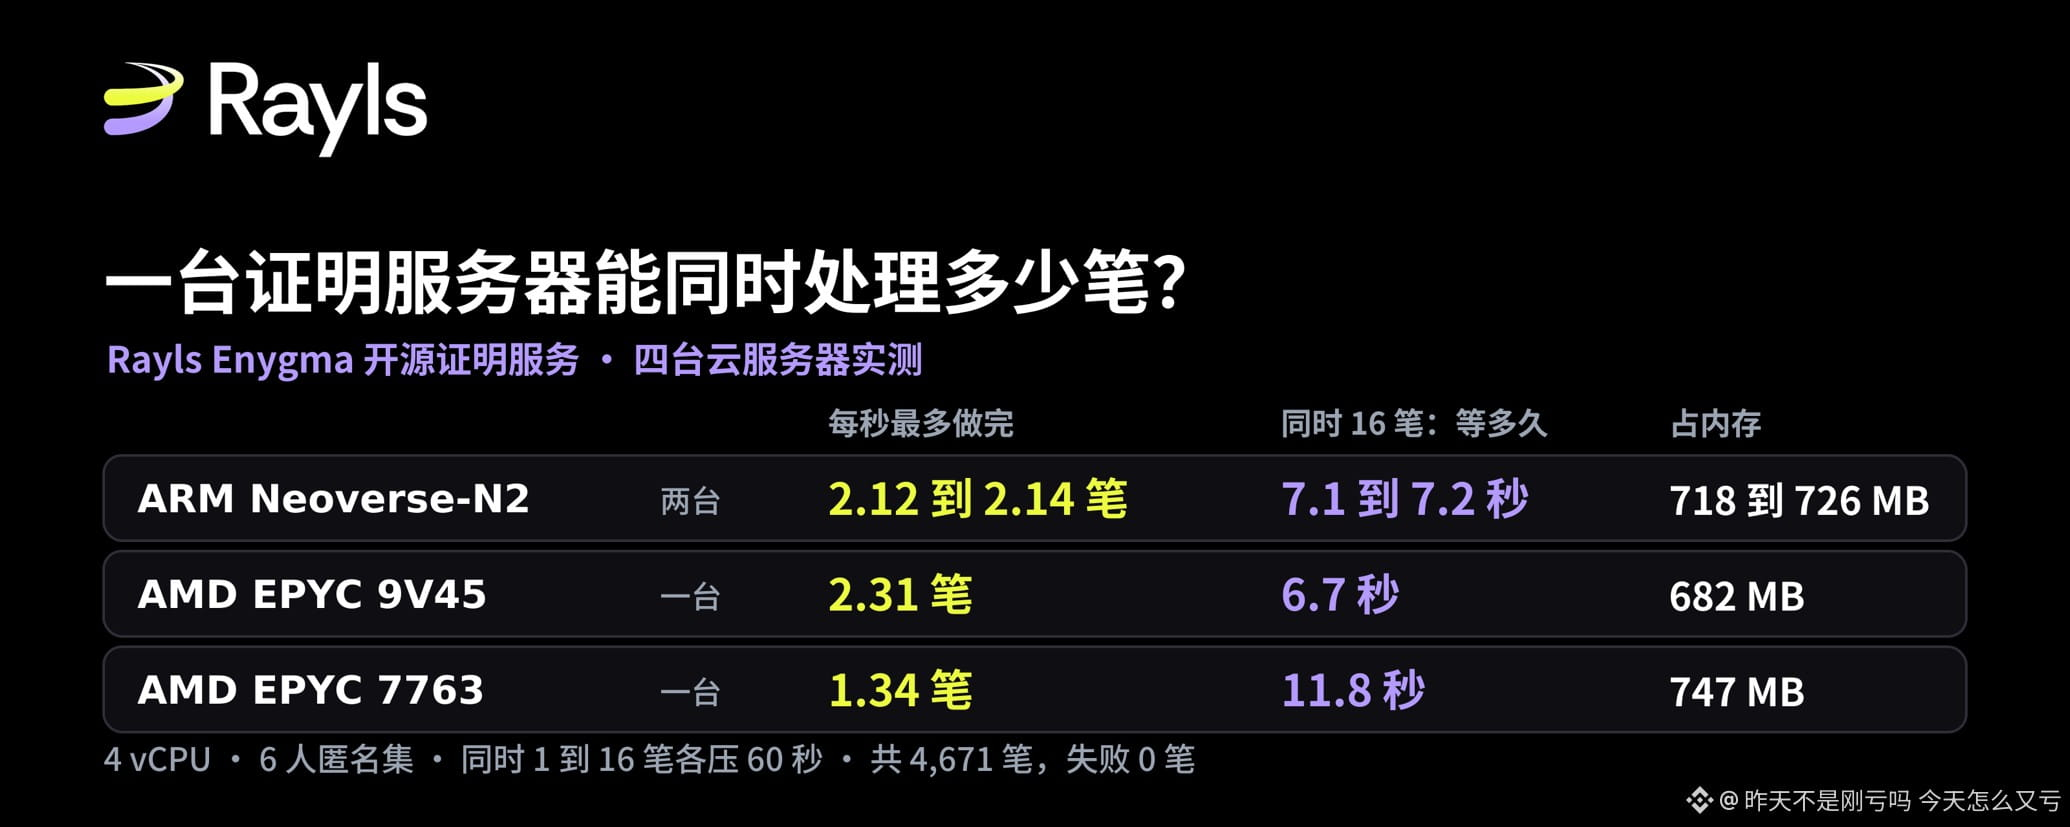
这次的数字全部来自 Actions 运行 39977915567(2026 年 10 月 23 日),它在四台独立分配的云服务器上各跑了一遍:两台 ARM Neoverse-N2,一台 AMD EPYC 9V45,一台 AMD EPYC 7763。四台都是 4 个 vCPU,加起来共 4,671 笔请求,失败 0 笔。
哪些是新的,这里说清楚。测试数据的生成器和单笔计时沿用上一篇。这篇新增的是:真实服务在并发下的吞吐量、尾延迟和内存,连续 5 分钟的负载,以及把 CPU 固定下来做的对照实验。
同时在算的越多,越慢,不会越快
四台机器的规律完全一样。从同时 1 笔到同时 2 笔,每秒做完的笔数会上升,N2 多了约三分之一,9V45 多了约 18%,7763 多了约 14%。到同时 4 笔达到顶点:N2 每秒 2.12 到 2.14 笔,9V45 每秒 2.31 笔,7763 每秒 1.34 笔。再往上加到 16 笔,吞吐量不升反降,比顶点低 4% 到 10%。
等待时间则一路上涨。同时 1 笔时,一笔请求的中位耗时是 0.52 到 0.86 秒;同时 16 笔时变成 6.70 到 11.81 秒,是原来的 11 到 14 倍,最慢的 1% 要等 10.00 到 13.91 秒。
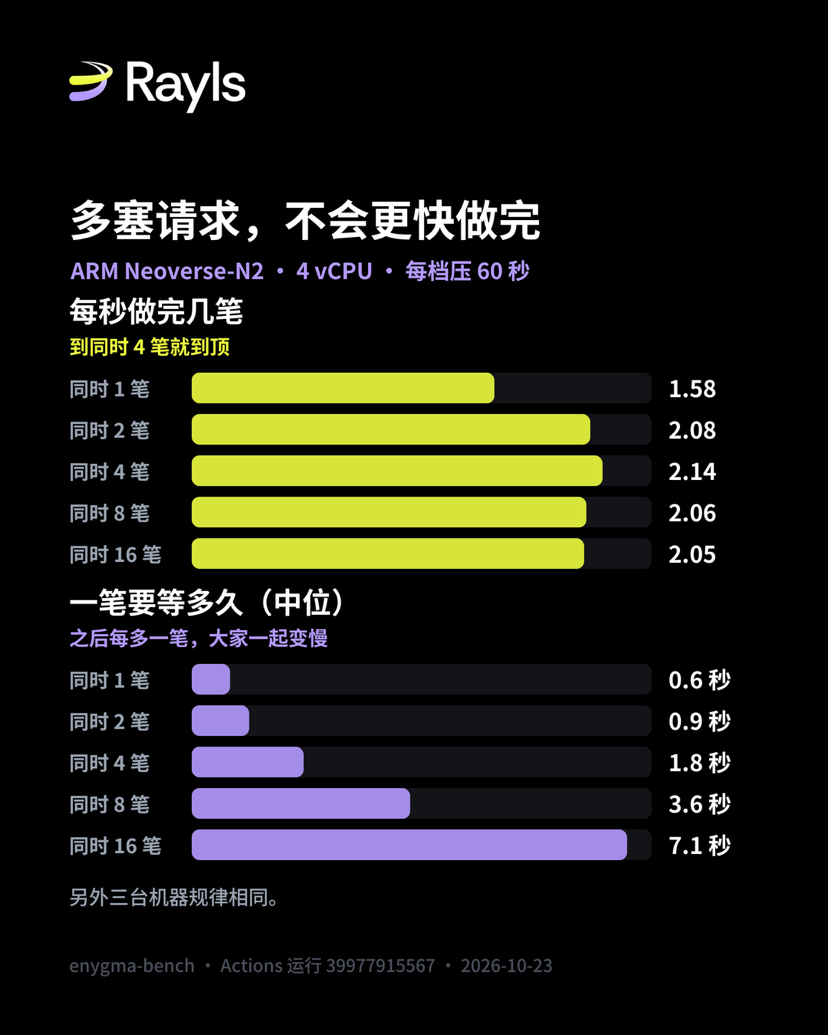
等待时间花在哪里,服务自己的日志给了答案。Rayls 的证明服务会为每笔请求打印内部的证明耗时,同时 16 笔时,这个耗时的中位数和外面测到的总耗时相差不到 3%。也就是说,请求并没有在门口排队,而是一进来就开始算,16 笔一起抢 4 个 vCPU,大家一起变慢。读代码可以印证这一点:服务没有设置并发上限,每个请求直接进入证明流程。
这背后是一条通用规律:一台已经吃满的机器,同时在算的笔数等于每秒做完的笔数乘以每笔的耗时。吞吐量到顶以后,多塞进去的请求只能换来更长的耗时。
每多一笔在算,多占约 30 MB 内存
服务启动并载入 6 人档的证明密钥后,空闲时占用 210 到 217 MB。同时在算的请求越多,内存越高:同时 16 笔时峰值达到 682 到 747 MB,大约每多一笔在算就多占 28 到 32 MB。对 4 vCPU、16 GB 的机器来说这不构成问题,但如果请求量突然暴涨又没有上限,内存会跟着请求数一起线性增长。
连续 5 分钟,没有变慢
让 4 笔请求同时在算、连续压 5 分钟,每 30 秒统计一次。四台机器每一段的吞吐量都在各自均值的上下 7% 以内:N2 两台在每秒 2.03 到 2.23 笔之间,9V45 在 2.13 到 2.37 笔,7763 在 1.30 到 1.43 笔。内存峰值稳定在 421 到 505 MB,没有持续上涨的迹象,期间没有一笔失败。
上一篇的推断,这次做成了对照实验
上一篇我看到 Intel 机器从 2 个 vCPU 加到 4 个只快了 1.17 倍,就用 lscpu 显示的"2 个核各跑 2 个线程"来解释。评审指出,云服务器是虚拟机,看到的核数不能证明底层硬件怎么分配,这个解释只是推断。
这次我用 taskset 把证明程序固定到指定的 CPU 上,在同一台机器上对比两种两 CPU 组合:两个 CPU 是同一个核上的两个线程,或者分在两个不同的核上。三轮交替顺序,避免机器状态随时间漂移带来偏差。两台 AMD 机器的结果每一轮都一致:同一个核上的两个线程只比一个 CPU 快 1.10 到 1.18 倍,两个不同的核快 1.53 到 1.57 倍。没有超线程的 N2 上,两个 CPU 快 1.49 到 1.58 倍。
所以"超线程让第 3、4 个 vCPU 帮不上多少忙"这个解释,现在有了同一台机器上的对照结果支撑。但边界也要说清楚:这仍是在虚拟机里看到的拓扑,宿主机怎么分配物理核,我看不到。
还有一处要交代。固定到两个 CPU 时的约 1.5 倍,低于上一篇不固定 CPU、只限制 Go 使用两个线程时的约 1.9 倍。一个可能的原因是,不固定时程序的其他后台线程还能用上另外两个 CPU,这次没有单独测量。所以固定 CPU 的数字适合用来比较几种条件,不适合当作产能。
对一家准备自己跑证明的机构意味着什么
这一节是推断,不是测量。
第一,给证明服务设一个并发上限,大约等于 CPU 的数量,多出来的请求排队。吞吐量本来就在 2 到 4 笔时到顶,上限之外的请求只会拖慢正在算的每一笔、多占内存。这次我没有测加了上限之后的版本,所以排队能把尾延迟改善多少,还是一个待验证的问题。
第二,按真实硬件测吞吐量,不要按机型标签。这次同样是 GitHub 的 x64 4 vCPU 运行器,分到 AMD EPYC 9V45 时每秒做完 2.31 笔,分到 AMD EPYC 7763 时只有 1.34 笔,差了四成多。
第三,按吞吐量而不是单笔耗时估算机器数量。上一篇用单笔耗时推算,一台 4 vCPU 机器每秒约 1.41 到 1.58 笔。这次实测连续 5 分钟、4 笔同时在算的吞吐量,N2 和 9V45 是每秒 2.15 到 2.29 笔,7763 是 1.35 笔。以 N2 为例,比上一篇按单笔推算的每秒 1.58 笔高出约 36%。
用这个数字重算英国 CHAPS:2025 财年日均 210,483 笔,摊到每个工作日 06:00 到 18:00 的结算窗口里,约每秒 4.87 笔,需要 2.1 到 3.6 台这样的机器。美国 Fedwire 2025 年日均 869,187 笔,按每天 22 小时的运行时间约每秒 10.97 笔,需要 4.8 到 8.1 台。这只是证明生成算力的一阶估算,不是 Rayls 的结算吞吐量,没有计入日内高峰、账本和中继的开销;而且证明由发起转账的各家机构自己生成,负载本来就分散在各家。
还没定的部分
这次只测了 6 人匿名集的转账电路,存款、取款和 DvP 电路没有测。测的是 Rayls 证明服务本身,不是完整的 Rayls 结算流程,后者还包括各家的账本、中继和私有网络枢纽,这些不在公开代码能跑起来的范围内。四台机器都是共享的云服务器虚拟机,不是物理服务器,也不是 Rayls 的生产环境。Go 的内存回收用的是默认设置,调整后内存曲线可能不同。Rayls 生产环境的硬件和并发配置,公开资料里我没有找到。
我的看法
一台普通的 4 vCPU 云服务器,同时接下十几笔零知识证明请求不会出错,也能连续几分钟稳定输出。但它的产能有一个硬顶,大约每秒一到两笔多。超过这个顶之后,多接的请求换来的只是更长的等待和更多的内存。
判断标准很简单:任何人都可以在 enygma-bench 仓库的 Actions 页面运行 enygma-load,看自己分到的机器上,吞吐量是不是同样在 2 到 4 笔同时在算时到顶。如果 Rayls 将来公布生产环境的证明服务配置,比如是否设了并发上限、用什么硬件,就可以直接拿这套压测去对照。
参考来源:
Rayls 证明服务源码,raylsnetwork/rayls-sovereign-gnark-api,提交 67c4c26(2026 年 8 月 20 日):https://github.com/raylsnetwork/rayls-sovereign-gnark-api/commit/67c4c26696016b48e70950e284ae1a51b7d0cf0e
本文压测代码与全部日志,Actions 运行 39977915567(2026 年 10 月 23 日):https://github.com/hansonhan0520-lang/enygma-bench
上一篇的单笔测试与日志,Actions 运行 37741247183(2026 年 10 月 8 日):https://github.com/hansonhan0520-lang/enygma-bench
GitHub 托管运行器规格(2026 年 10 月 8 日查阅):https://docs.github.com/en/actions/reference/runners/github-hosted-runners
Fedwire Funds 2025 年统计(页面更新于 2026 年 1 月 26 日):https://www.frbservices.org/resources/financial-services/wires/volume-value-stats/annual-stats.html
英格兰银行支付与结算统计,CHAPS 2025 财年日均笔数:https://www.bankofengland.co.uk/payment-and-settlement/payment-and-settlement-statistics
#Rayls $RLS #零知识证明