Recentemente, encontrei o caso técnico do NodeGhost da @Acurast e vi um resultado de teste bem interessante.
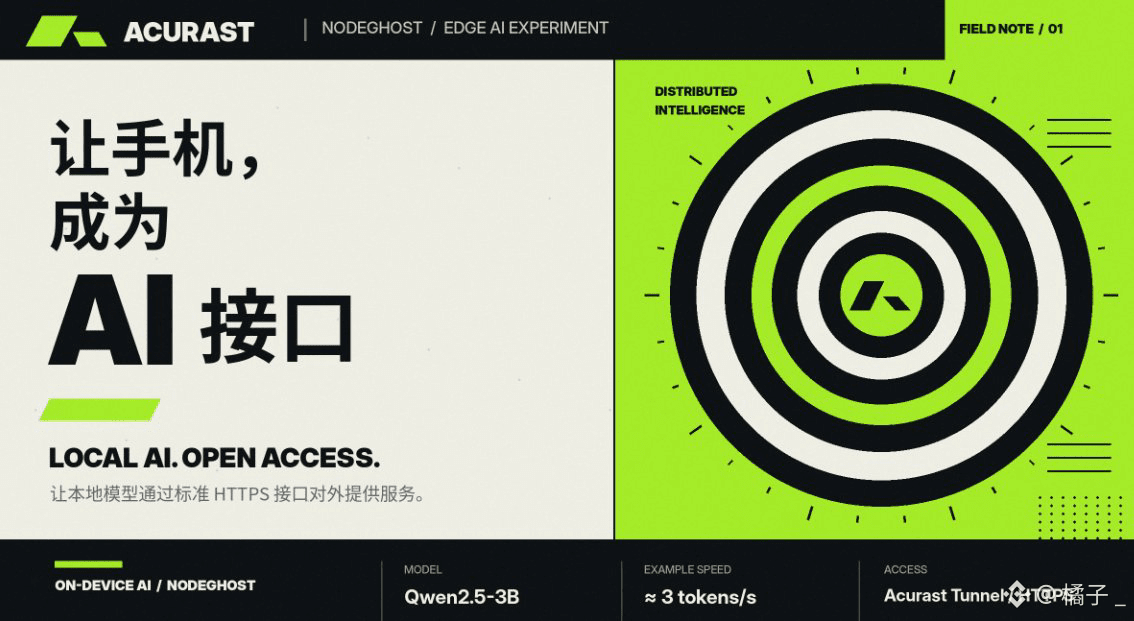
Um celular executa o modelo quantizado Qwen2.5-3B, gerando cerca de 3 tokens por segundo.
Para responder a uma pergunta com aproximadamente 120 tokens, são necessários cerca de 45 segundos.
Considerando a experiência atual com modelos de grande escala, essa velocidade é realmente um pouco lenta.
Mas o que me chamou a atenção nesse caso foi outro aspecto do projeto.
Com o Acurast Tunnel, um modelo que antes ficava oculto no celular, sem um IP público, pode oferecer uma interface HTTPS externamente.
Com a API compatível com OpenAI do NodeGhost, os desenvolvedores podem enviar solicitações para serem executadas no celular sem quase nenhuma alteração na forma como já fazem chamadas.
Assim, o celular deixa de ser apenas um Processor na rede, aguardando passivamente a distribuição de tarefas, e também pode oferecer serviços padronizados de inferência de IA.
É claro que, por enquanto, esse caso ainda é uma implementação de referência na rede Canary, com limitações significativas de velocidade e capacidade para raciocínios complexos.
Mas acredito que já responde a uma pergunta bastante prática:
Se os desenvolvedores quiserem implantar seus próprios modelos em celulares distribuídos, será que os aplicativos existentes conseguem acessá-los com facilidade?
Pelo menos, já existe um exemplo funcional desse caminho técnico.
Quanto à comercialização, ainda será necessário validar a latência, a concorrência, os custos e a estabilidade a longo prazo.
O $ACU da Acurast é responsável por conectar o uso da rede aos incentivos de computação, mas, para saber se conseguirá atrair demanda pagante, ainda será preciso ver se esses aplicativos têm competitividade real.
Um celular executa o modelo quantizado Qwen2.5-3B, gerando cerca de 3 tokens por segundo.
Para responder a uma pergunta com aproximadamente 120 tokens, são necessários cerca de 45 segundos.
Considerando a experiência atual com modelos de grande escala, essa velocidade é realmente um pouco lenta.
Mas o que me chamou a atenção nesse caso foi outro aspecto do projeto.
Com o Acurast Tunnel, um modelo que antes ficava oculto no celular, sem um IP público, pode oferecer uma interface HTTPS externamente.
Com a API compatível com OpenAI do NodeGhost, os desenvolvedores podem enviar solicitações para serem executadas no celular sem quase nenhuma alteração na forma como já fazem chamadas.
Assim, o celular deixa de ser apenas um Processor na rede, aguardando passivamente a distribuição de tarefas, e também pode oferecer serviços padronizados de inferência de IA.
É claro que, por enquanto, esse caso ainda é uma implementação de referência na rede Canary, com limitações significativas de velocidade e capacidade para raciocínios complexos.
Mas acredito que já responde a uma pergunta bastante prática:
Se os desenvolvedores quiserem implantar seus próprios modelos em celulares distribuídos, será que os aplicativos existentes conseguem acessá-los com facilidade?
Pelo menos, já existe um exemplo funcional desse caminho técnico.
Quanto à comercialização, ainda será necessário validar a latência, a concorrência, os custos e a estabilidade a longo prazo.
O $ACU da Acurast é responsável por conectar o uso da rede aos incentivos de computação, mas, para saber se conseguirá atrair demanda pagante, ainda será preciso ver se esses aplicativos têm competitividade real.