

No episódio anterior, combinamos em partes iguais a pontuação do modelo e o momentum. No período de teste, obtivemos um retorno de +172.93%, um drawdown de -18.44% e um índice de Sharpe de 2.076. No final, eu disse que, no próximo episódio, integraríamos a combinação ao buffer e ao stop-loss e depois rodaríamos a validação.
Antes de começar de verdade, parei por um instante. Os resultados das nove estratégias com melhor desempenho estavam espalhados por diferentes scripts de ablação e diretórios de cache; os parâmetros estavam em dicionários de configuração, e os arquivos de sinal não seguiam um padrão de nomenclatura. Se eu trocasse de computador ou voltasse ao projeto duas semanas depois, ainda conseguiria reproduzir exatamente esses nove resultados? A resposta é não.
Por isso, neste episódio não vamos continuar perseguindo retornos. Primeiro, vamos consolidar as nove estratégias em um diretório que possa ser reproduzido com um único clique. Um backtest que não pode ser reproduzido não é diferente de inventar uma história.
Esta entrega inclui três elementos: nove ficheiros de estratégia, seis ficheiros de sinais e um notebook unificado. As nove estratégias foram executadas com sucesso; os 9/9 resultados coincidiram, item a item, com os valores esperados.
Um: por que começar pela reprodução em vez de continuar a ajustar os parâmetros
Nas duas primeiras partes desta série, uma tratou da limpeza do universo de moedas e a outra da correção da interface de seleção de moedas. Nesta parte, já temos nove estratégias; é fácil continuar a acrescentar parâmetros, mas cada um torna a reprodução mais difícil.
As nove estratégias anteriores vinham dos dicionários de configuração de `robust_ablation.py` e `risk_guard_ablation.py`. A mesma lógica de seleção de moedas era copiada para configurações diferentes, com os parâmetros fixos no código. Ao alterar um sinal, não era possível distinguir se tinha mudado o sinal ou o percurso do código. Mais complicado ainda: ao ver um número, ninguém conseguia saber que versão do código, que ficheiro de sinais ou que conjunto de parâmetros o tinha produzido.
A reprodução não é uma formalidade. Transforma o resultado de um script executado uma única vez num ficheiro que pode ser citado, comparado e entregue a outras pessoas para verificação. Quer se acrescentem custos de financiamento, slippage ou se faça walk-forward mais tarde, é preciso ter um ponto de partida estável.
Dois: nove ficheiros de estratégia, apenas com parâmetros fixos, sem duplicar a lógica
Foi criado o diretório `alpha/crypto/strategy_catalog/`, onde foram colocados os nove ficheiros de estratégia. Cada ficheiro corresponde a uma estratégia:
- top5 combinado
- Modelo buf4 stop35
- mom10 top5 long-only buf5
- Modelo buf4 stop10
- Modelo long-only buf5 stop10
- mom10 top5
- Modelo buf4
- Modelo long-only buf5
- mom10 top20 long-only buf5
Os nove ficheiros são subclasses leves, sem duplicar a lógica das classes base. A seleção de moedas, o buffer de classificação e a máquina de estados do stop continuam em `CryptoRobustStrategy` e `CryptoRobustGuardedStrategy`; as subclasses apenas fixam os parâmetros.
Cada ficheiro exporta os mesmos seis objetos: nome da estratégia, família de sinais, classe da estratégia, parâmetros do backtest, métricas esperadas para o período de teste e valores de referência do período de validação. Só os três modelos mom10 têm valores de referência para o período de validação; os do modelo e do sinal combinado ficam temporariamente vazios. O notebook monta tudo automaticamente com base nestes objetos, sem ser necessário escrever à mão nove blocos de código de backtest.
Por que não criar nove implementações independentes? Porque, se cada um dos nove ficheiros copiasse a lógica de seleção de moedas, haveria nove potenciais fontes de bugs. Uma alteração na classe base beneficia as nove estratégias; uma alteração nos parâmetros exige mexer apenas num ficheiro e não afeta as outras oito.
A documentação em chinês no cabeçalho de cada ficheiro esclarece quatro aspetos: como são escolhidas as duas extremidades long/short, de que família de sinais e colunas precisa, o que significam os parâmetros fixos e em que circunstâncias a estratégia falha. Este último ponto é importante. Se um ficheiro só explicar como ganhar dinheiro e não disser quando se perde, é fácil continuar a ajustar os parâmetros de uma estratégia que já deixou de funcionar.
Há aqui uma armadilha concreta. `stop_pct` e `stop_cooldown` têm de ser incluídos simultaneamente em `BACKTEST_SETTING` nas três estratégias com stop. Isto porque o runner do backtest lê `setting.get("stop_pct")`, e não o atributo da classe. Se estiver definido apenas na classe, a própria estratégia continua a detetar o stop, mas o runner não corrige o P&L posteriormente; o backtest termina normalmente, mas as contas do dia do stop ficam erradas. O notebook inclui uma asserção: o atributo da classe e o setting têm de coincidir; caso contrário, gera um erro.
Outra limitação é que `on_bars` de `CryptoRobustGuardedStrategy` tem p5 e p0 codificados diretamente; só suporta seleção de moedas por nível, não seleção combinada. Nenhuma das nove estratégias combina sinal com stop, por isso desta vez não alterámos a classe base e apenas esclarecemos este ponto na documentação dos três ficheiros com stop. Para combinar o sinal com stop no futuro, será necessário primeiro extrair a interface de seleção de moedas da classe base.
Três: seis ficheiros de sinais, três famílias, um para teste e outro para validação
As nove estratégias partilham três famílias de sinais; não é necessário fazer nove cópias:
- Sinal do modelo: p5, p0, score, provenientes de um modelo LightGBM de cinco classes
- Sinal mom10: momentum dos últimos 10 dias de negociação
- Sinal combinado: metade da classificação do score do modelo e metade da classificação do momentum
Cada família de sinais tem dois ficheiros, um para o período de teste e outro para o de validação, num total de seis ficheiros.
Porque não copiar um sinal para cada estratégia? Porque o sinal é uma entrada e a estratégia é a forma de o consumir. O mesmo sinal do modelo pode ser consumido de formas diferentes por top5, buffer4 e stop10. Fazer nove cópias tornaria inútil a verificação de hash e facilitaria alterar uma cópia e esquecer as restantes.
Todos os sinais partilham o mesmo schema; o ficheiro combinado tem mais três colunas de diagnóstico:
| Coluna | Tipo | Significado |
|---|---|---|
| datetime | Datetime("us") | Meia-noite do dia de negociação, hora sem fuso |
| vt_symbol | String | Código do contrato |
| signal | Array(Float64, 6) | Probabilidades das cinco classes |
| p5 | Float64 | signal[5], probabilidade de entrar no escalão mais alto |
| p0 | Float64 | signal[0], probabilidade de entrar no escalão mais baixo |
| score | Float64 | p5 menos p0 |
| mom_return_10 | Float64 | Momentum a 10 dias |
| score_rank_pct | Float64 | Percentil da classificação transversal do score do modelo, apenas no ficheiro combinado |
| mom_rank_pct | Float64 | Percentil da classificação transversal do momentum, apenas no ficheiro combinado |
| blend_score | Float64 | Metade de cada uma das duas colunas, apenas no ficheiro combinado |
Antes de gravar, verificam-se quatro coisas: a combinação da data e do contrato, que é a chave principal, é única; não há interseção entre os contratos e a lista de exclusão de criptoativos puros; `signal` continua a ser `Array(Float64, 6)` e não se transforma em `List`; e p5, p0 e score são coerentes entre si.
Há ainda um pormenor fácil de ignorar: a ordem das linhas não pode ser alterada.
Ao selecionar moedas, se houver um empate na fronteira da classificação, a ordenação estável usa a ordem original das linhas para decidir o que entra e o que sai. Ordenar o ficheiro de sinais por data ou contrato pode alterar as posições e, consequentemente, os retornos. Por isso, todas as projeções e colunas acrescentadas preservam a ordem das linhas do ficheiro de origem; é proibido ordenar. Não é uma questão de estilo de código, mas de conseguir ou não reproduzir os resultados.
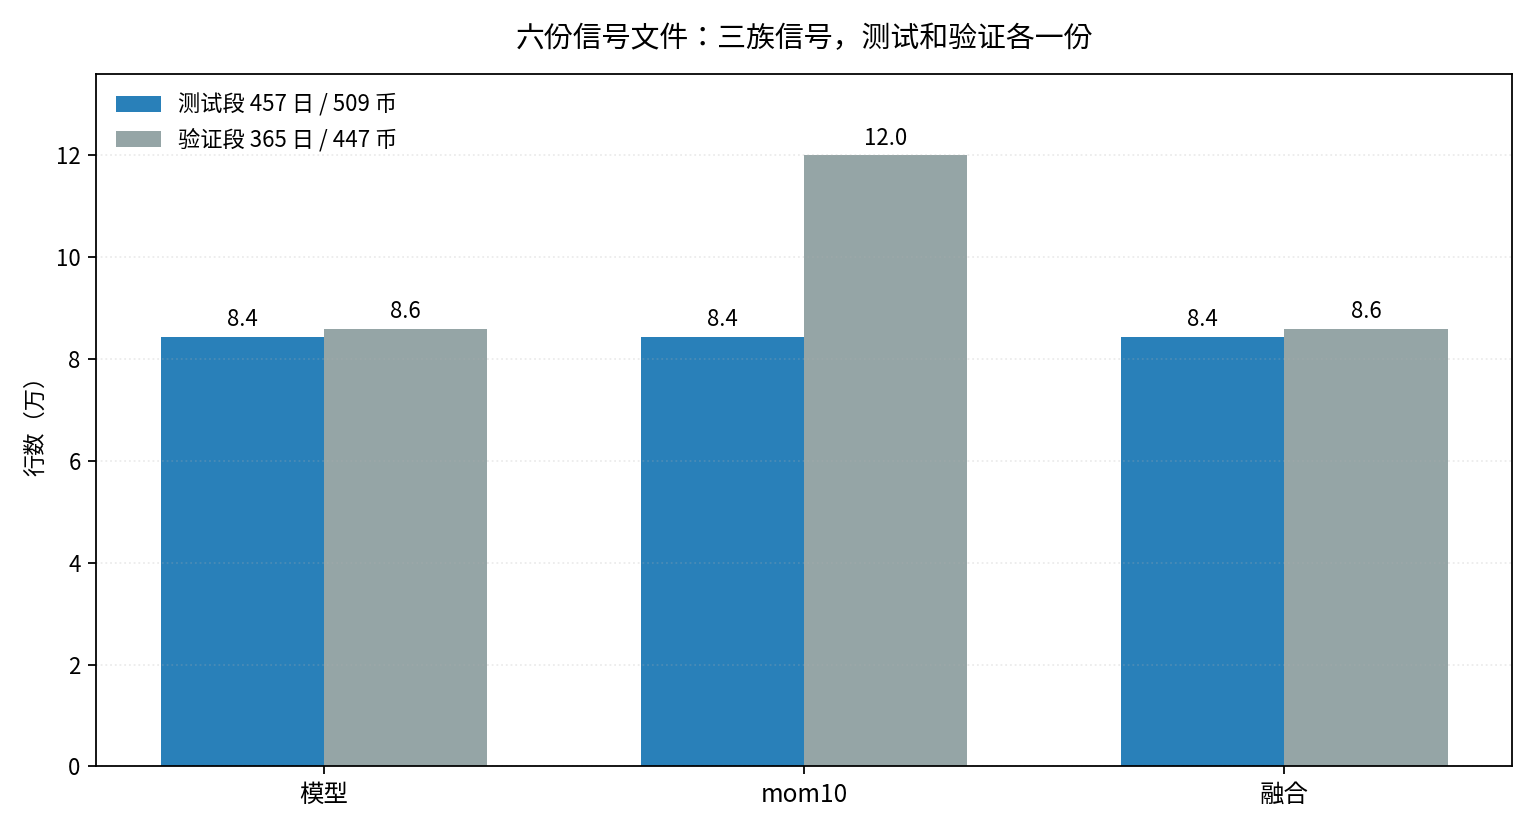
Figura 1: cada ficheiro do período de teste tem 84 mil linhas; os ficheiros do modelo e do sinal combinado no período de validação têm 86 mil linhas, e o mom10 do período de validação tem 120 mil linhas. O maior número de linhas do mom10 no período de validação não significa que haja mais moedas, mas sim que a codificação é diferente.
Quatro: os períodos de teste e validação do mom10 não são intercambiáveis
Esta foi a armadilha mais fácil de cair desta vez.
O mom10 do período de teste usa `mom_return_10`, truncado pelo conjunto de dados, com valores limitados ao intervalo entre -3 e 3. O mom10 do período de validação usa `mom10` sem truncamento, na tabela de risco. Os dois ficheiros parecem conter o mesmo sinal, mas a codificação é diferente.
Não são intercambiáveis, nem se pode usar um para recalcular o outro. Antes de comparar períodos, é preciso verificar a definição usada. Se juntarmos diretamente os resultados dos dois períodos, parecem ambos ser mom10, mas na realidade não medem a mesma coisa.
O período de validação do modelo tem ainda outra limitação. VALID participa na paragem antecipada do IC diário, pelo que `model_valid` só pode ser considerado parcialmente dentro da amostra. O `best_iteration` do modelo desta vez é 290 e o IC diário do período de validação é 0.0373. Este valor não pode ser considerado um resultado de amostra fora da amostra limpo; as conclusões posteriores sobre o período de validação devem ser ponderadas.
Para garantir que o treino e a projeção não divergiram, o notebook inclui uma verificação de paridade de teste: volta a prever o período de teste e compara, linha a linha, com o `model_test` já guardado; a diferença absoluta máxima tem de ser inferior a `1e-6`. Desta vez, a diferença observada foi 0.0.
Cinco: um notebook para validação, carregamento, backtest e reconciliação
O ponto de entrada unificado é `strategy_catalog_backtest.ipynb`. Quatro opções controlam o modo de execução:
- `RUN_SEGMENTS=["test"]`: executar primeiro apenas o período de teste
- `FORCE_REBUILD_SIGNALS=False`: reconstruir os sinais apenas se estiverem em falta
- `RETRAIN_MODEL=False`: por predefinição, não voltar a treinar; usar diretamente o modelo em cache
- `ALLOW_MODEL_MISMATCH=False`: interromper se o modelo não corresponder, sem continuar silenciosamente
O processo tem seis passos:
1. Carregar AlphaLab, os constituintes de CRYPTO.LOCAL e o filtro de criptoativos puros
2. Validar ou gerar os seis ficheiros de sinais
3. Importar dinamicamente os nove módulos de estratégia e montar o catálogo de estratégias
4. Carregar as três famílias de sinais e os dados OHLC para cada período e chamar o runner de backtest para cada uma
5. Escrever as métricas JSON e o parquet do valor líquido diário de cada estratégia
6. Gerar uma tabela de reconciliação com os valores reais, esperados e as diferenças, bem como a indicação de aprovação ou não
O backtest reutiliza `risk_guard_ablation.run_config`; não se cria um novo runner. Este já inclui a substituição do P&L no dia em que o stop é acionado, a liquidação do residual no dia seguinte, a manutenção das comissões e o recálculo das métricas. Se criássemos outro backtest para este catálogo, mais cedo ou mais tarde os dois motores produziriam resultados diferentes.
Os critérios de reconciliação são fixos:
- Erro no retorno e na perda máxima não superior a 0,01 pontos percentuais
- Erro no Sharpe não superior a 0,001
- Erro no Calmar não superior a 0,01
- Número de transações e número de stops exatamente iguais
Desta vez, os 9/9 passaram. O valor líquido diário de cada estratégia tem 457 linhas; o capital final é igual a 10 milhões multiplicados por 1 mais a taxa de retorno. O número de stops das três estratégias com stop foi, respetivamente, 121, 646 e 652, exatamente igual ao registo das estratégias.
Não é uma correspondência aproximada: os valores coincidem item a item.
Seis: resultados das nove estratégias
As nove estratégias na mesma tabela, ordenadas por retorno decrescente:
| Estratégia | Sinal | Retorno | Perda máxima | Sharpe | Número de transações | Número de stops |
|---|---|---:|---:|---:|---:|---:|
| top5 combinado | Combinado | +172.93% | -18.44% | 2.076 | 7251 | 0 |
| mom10 top5 long-only buf5 | mom10 | +152.67% | -30.13% | 1.577 | 5879 | 0 |
| Modelo buf4 stop35 | Modelo | +151.47% | -31.42% | 1.635 | 4787 | 121 |
| Modelo buf4 | Modelo | +137.55% | -54.80% | 1.368 | 4745 | 0 |
| mom10 top5 | mom10 | +134.22% | -39.03% | 1.385 | 6201 | 0 |
| Modelo buf4 stop10 | Modelo | +130.86% | -16.25% | 1.906 | 4719 | 646 |
| Modelo long-only buf5 | Modelo | +115.08% | -51.89% | 1.174 | 4855 | 0 |
| Modelo long-only buf5 stop10 | Modelo | +114.01% | -14.39% | 1.846 | 4743 | 652 |
| mom10 top20 long-only buf5 | mom10 | +68.98% | -21.81% | 1.563 | 22474 | 0 |
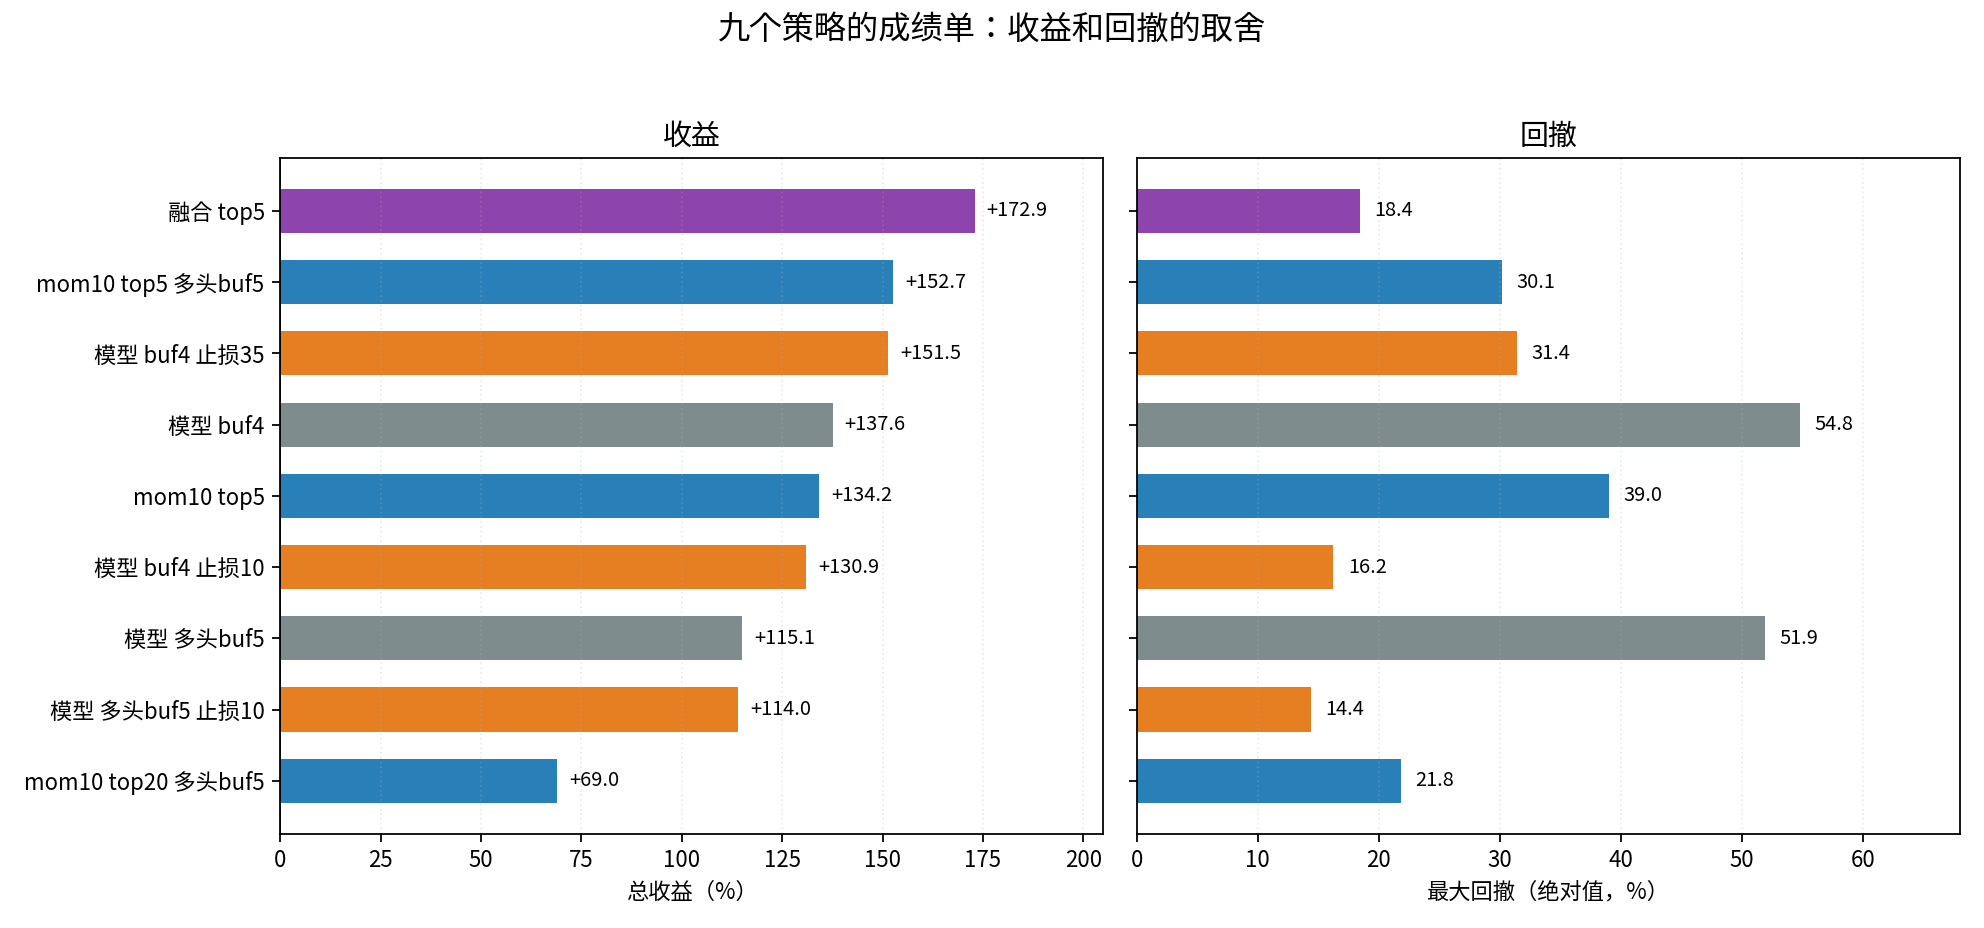
Figura 2: à esquerda está o retorno e à direita o valor absoluto da perda máxima, pela mesma ordem. A cor de laranja representa as estratégias do modelo com stop, a cinzenta as estratégias do modelo sem stop, a azul o mom10 e a roxa o sinal combinado.
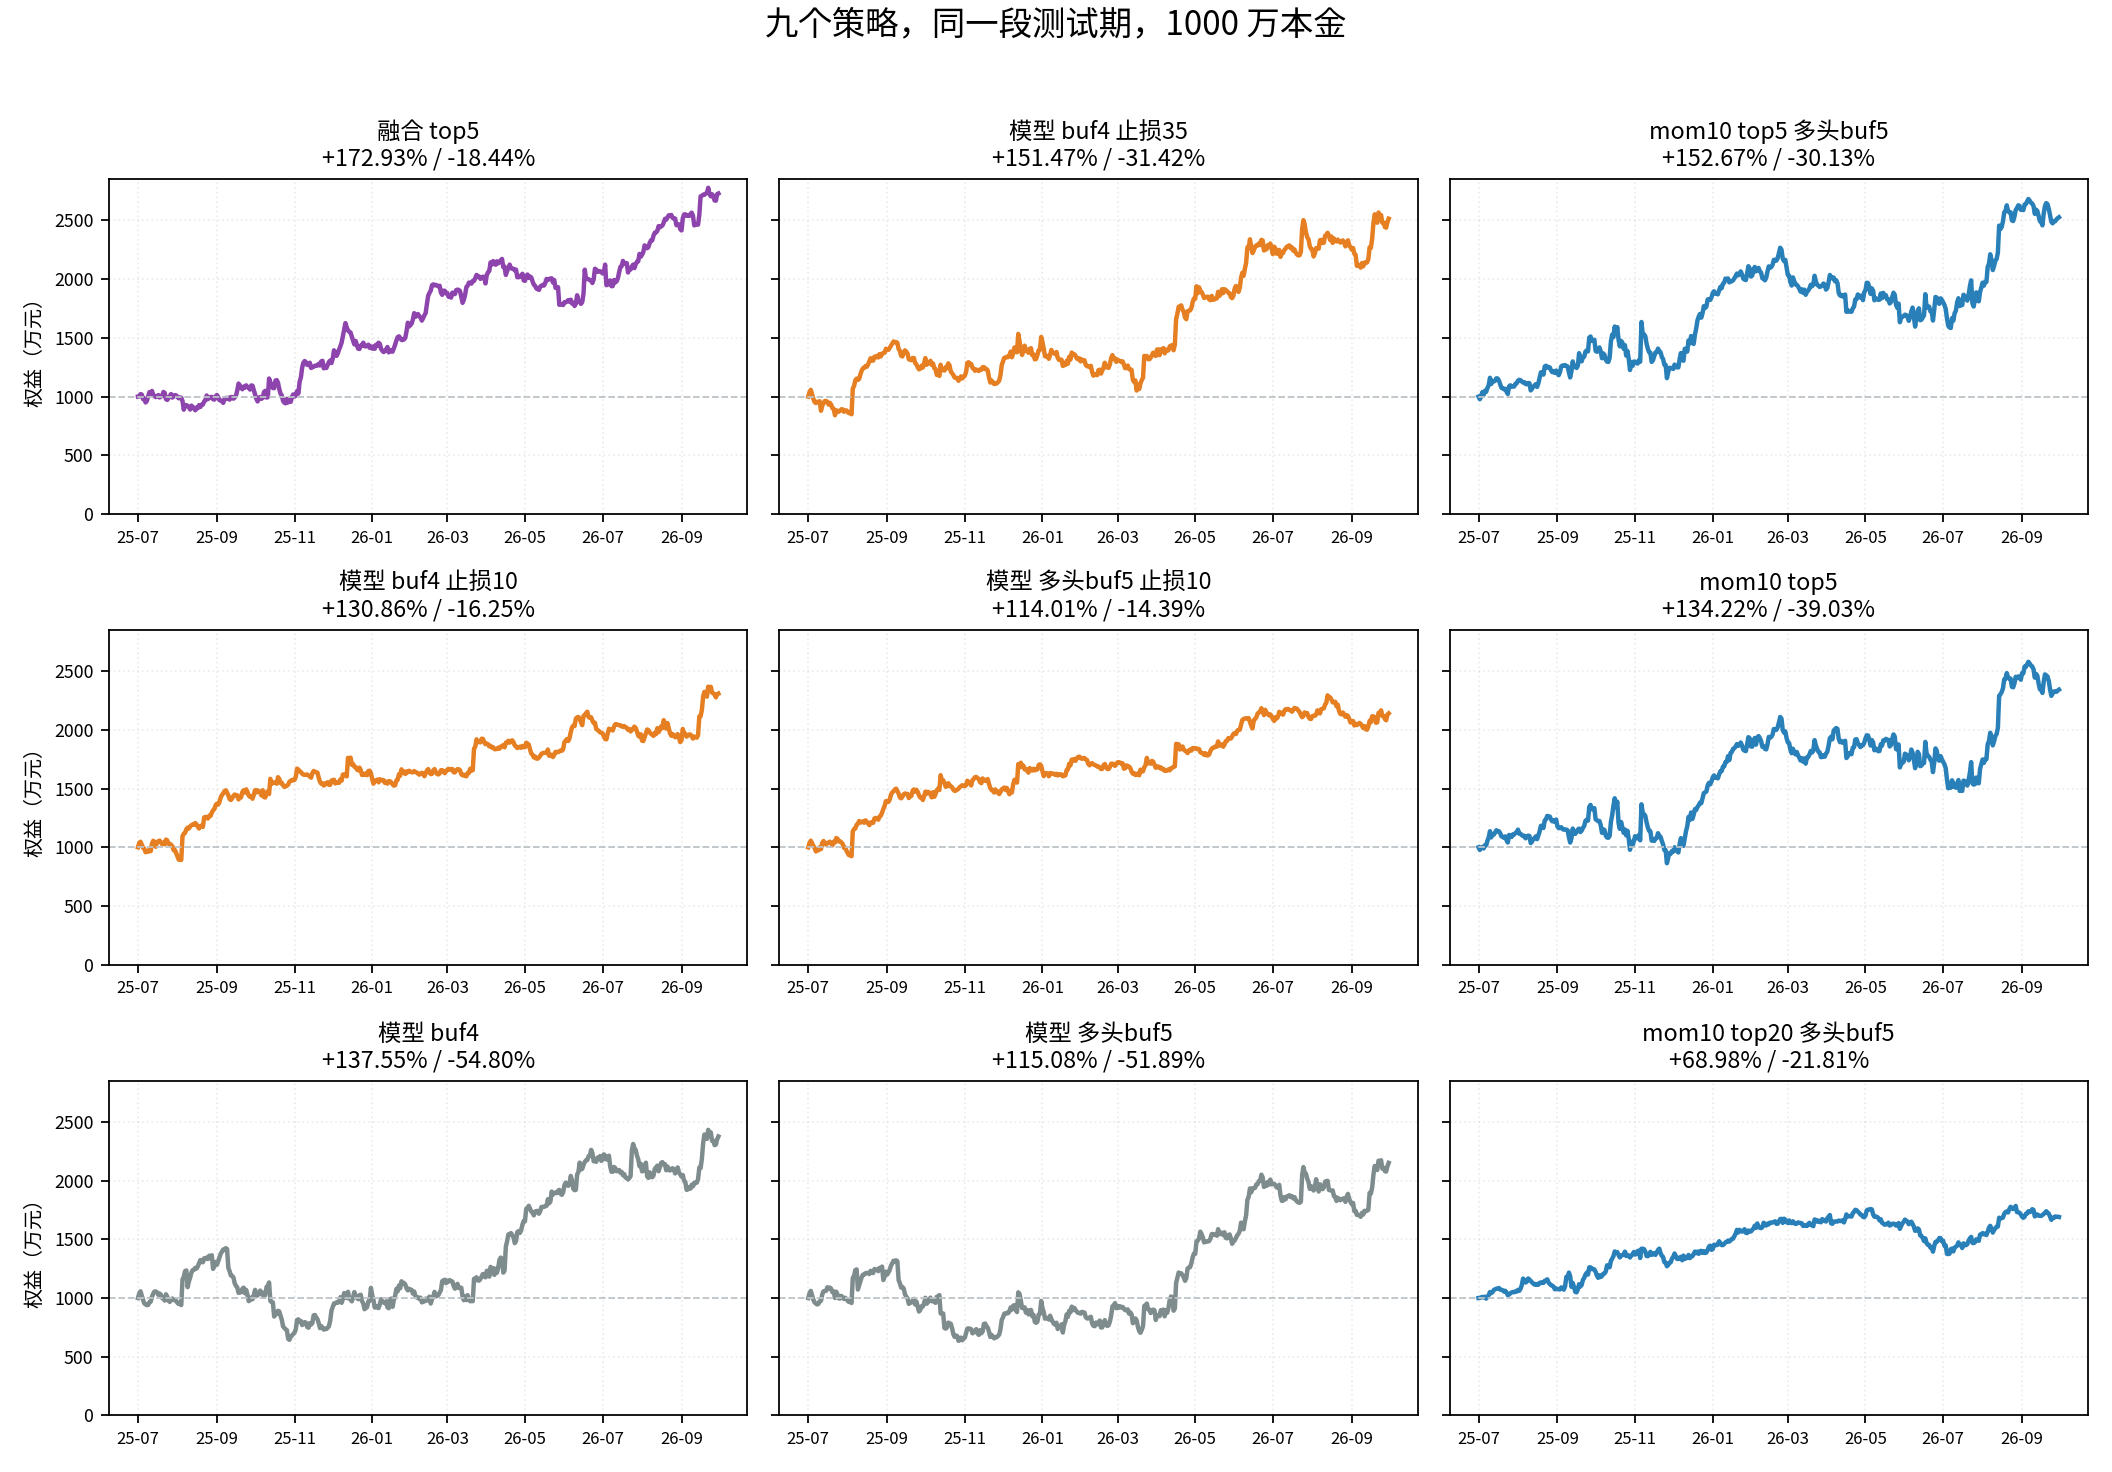
Figura 3: curvas do valor líquido das nove estratégias no mesmo período de teste e com o mesmo capital inicial de 10 milhões, usando um eixo vertical comum. Os dois números no título são o retorno total e a perda máxima.
Algumas observações:
Primeiro, o sinal combinado continua em primeiro lugar. Retorno de +172.93%, perda máxima de -18.44% e Sharpe de 2.076: é o melhor das nove estratégias nos três indicadores. O Calmar é 7.49; é também a única configuração que supera simultaneamente a melhor variante mom10 em retorno, perda máxima e Sharpe. Comparada apenas com mom10 top5, a estratégia Modelo buf4 stop35 também vence nos três indicadores, mas não supera mom10 long-only buffer5, com +152.67%.
Segundo, o stop reduz a perda máxima, mas não é grátis. As duas variantes stop10 reduziram a perda máxima para -14.39% e -16.25% e alcançaram Sharpe de 1.846 e 1.906, mas a parte anterior já confirmou que stop10 é extremamente sensível ao slippage: com 2% de slippage, o retorno fica praticamente a zero. stop35 tem retorno de +151.47% e perda máxima de -31.42%; é mais estável e adequado a situações em que o slippage é incerto.
Terceiro, a perda máxima das variantes de referência do modelo continua entre -52% e -55%. O buffer transformou retornos negativos em retornos de +115% a +137%, mas não resolveu o risco de cauda. Melhorar o retorno e melhorar o risco são coisas distintas; não se deve ignorar a perda máxima só porque o retorno passou a ser positivo.
Quarto, mom10 top20 tem o retorno mais baixo, apenas +68.98%, e 22474 transações, sendo a estratégia com mais transações entre as nove. Alargar as posições não significa obter um resultado melhor: os custos de transação podem consumir parte dos retornos. É também por isso que será necessário incluir os custos mais à frente.
Este catálogo mostra compromissos, não um único vencedor. A escolha depende do capital, do nível de slippage, da tolerância à perda máxima e dos custos de rebalanceamento.
Sete: registo de reprodução: commit, versões e hash
Cada execução gera um registo de reprodução no notebook. O desta vez contém:
- Hora de execução: 2026-10-20T09:39:45
- commit do git: `261a7147ed6810bd4e7a76397a9149f7353a6470`
- Estado da área de trabalho: há alterações por submeter
- Python 3.13.13, polars 1.41.2, lightgbm 4.6.0, vnpy 4.4.0
- `best_iteration` do modelo: 290
- IC diário do período de validação: 0.03727
- Diferença absoluta máxima de paridade no período de teste: 0.0
Também foram registados os SHA256 dos seis ficheiros de sinais:
| Ficheiro de sinal | 12 primeiros caracteres do SHA256 |
|---|---|
| model_test | c8e9e5642a78 |
| model_valid | 77e53a0a794b |
| mom10_test | d59cf2be7a10 |
| mom10_valid | 70e25941c252 |
| blend_mom10_test | 1d5b40457ab2 |
| blend_mom10_valid | c379b7b1bab9 |
É importante indicar honestamente que a área de trabalho contém alterações por submeter. Isso significa que o código correspondente a estes resultados não coincide com um commit limpo; em rigor, o número do commit, por si só, pode não ser suficiente para outra pessoa reproduzir tudo exatamente. Antes da próxima execução, deve submeter-se as alterações ou guardar também o diff. O valor do registo de reprodução não está em parecer bem, mas em deixar as diferenças num local rastreável.
Da próxima vez que alguém perguntar de onde veio este número, basta entregar-lhe o registo de execução, os hashes dos sinais e o notebook.
Oito: limites e próximo episódio
Comecemos por eliminar as ilusões.
Os nove resultados são todos de um único período de teste, de julho de 2025 a setembro de 2026, num total de 457 dias. Os parâmetros também foram escolhidos repetidamente durante este período de teste, que não é uma amostra fora da amostra limpa. A reprodução dos 9/9 só prova que o código e os sinais conseguem reproduzir estes números; não prova que estes números se repetirão no futuro.
O período de validação do modelo está parcialmente dentro da amostra, porque VALID participou na paragem antecipada. O universo de moedas do mom10 no período de validação é diferente do universo do modelo nesse período; os resultados de famílias diferentes não podem ser comparados diretamente. Os custos de financiamento, liquidações forçadas, slippage real, moedas novas e filtros de baixa liquidez ainda não foram incluídos.
No próximo episódio, faremos três coisas: ligar o sinal combinado ao buffer e ao stop, executar o período de validação e, depois, fazer walk-forward. Se os resultados não se mantiverem no período de validação, os +172.93% serão apenas um número bonito do período de teste e teremos de voltar atrás e fazer alterações.
A reprodução não é o destino, mas o ponto de partida. Primeiro assentamos as fundações; depois construímos.
Este laboratório de trading quantitativo continuará a publicar os seus registos, dos dados e fatores à gestão do risco. Se achar útil, guarde-o. Até ao próximo episódio.