

AI × DePIN:Acurast 如何让手机承接真实的 AI 任务
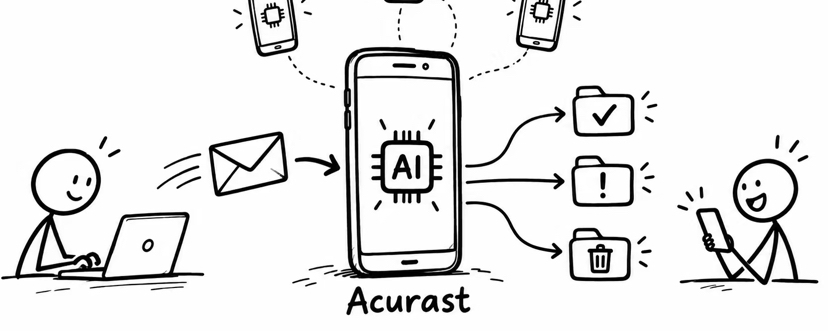
在 @Acurast10 月 2 日公布的 Laya 演示中,一部安卓手机运行着 AI 模型,判断邮件应该进入收件箱、垃圾箱,还是被标记为钓鱼邮件。用户在网页上看到的分类结果,来自这部手机的计算。
Laya 处理的是固定选项的决策任务。应用把当前信息和候选选项通过 HTTP 请求发给模型,模型返回选择及其概率,应用再据此执行下一步。同一套调用方式,也被用在聊天审核和游戏决策等演示里。
这个案例给 AI × DePIN 提供了一个具体的观察入口:**先看应用需要完成什么任务,再判断哪种硬件适合承担它。**
设想一个处理客户邮件的 AI 助手。收到邮件后,它需要先识别邮件类型、判断紧急程度,再决定是否交给后续流程。退款申请、技术问题、垃圾信息,可以分别进入不同的处理队列。这里有大量重复出现、输入相对明确的判断,它们的执行方式和资源需求,值得单独设计。
在我看来,手机算力的机会就存在于这类细分任务中。对于适合独立处理的请求,开发者可以探索分散部署,让不同设备承接不同请求。要让这种方式可用,还需要把网络连接、响应时间、设备性能和服务稳定性一起考虑进去。
Acurast 尝试解决的,就是如何把分散的手机组织成开发者能够使用的计算网络。设备运行 Processor 提供资源,网络中的 Matcher 根据开发者的部署要求与设备资源进行匹配。任务何时运行、执行哪些指令、结果交到哪里,都属于部署需要定义的内容。
开发工具决定了这张网络能承接多少种应用。Acurast 的 Cargo 运行环境,让符合要求的 64 位安卓 Core 设备可以在 Linux 镜像中运行原生程序,开发者能够使用脚本、原生工具和相应的依赖。它为把已有软件部署到手机计算网络提供了一条路径。
这一步的意义在于,手机需要成为软件能够部署、调用和维护的执行环境。开发者只有真正把应用放上去,才能检验工具是否顺手、运行是否稳定,以及成本是否适合自己的业务。
分散执行还会带来信任问题。设备属于不同的人,应用需要确认承载任务的硬件身份。官方对 Laya 示例的介绍提到,它运行在经过设备证明的手机上。对于开发者而言,这类机制让硬件身份成为可以核验的信息,也是建立分散计算信任的一部分。
设备身份可以验证之后,模型表现仍然需要单独评估。官方演示也记录了 Laya 的误判,并展示了单台手机处理请求的容量限制。对实际应用而言,分类准确率、请求排队和异常处理,都需要在具体场景中测试。
Acurast 已经有一些可观察的进展。主网于 2026 年 1 月 20 日上线;截至 10 月 6 日查阅官网,页面列出的手机接入量超过 32.2 万部,计算部署超过 67.5 万次。这些指标展示了网络组织设备和承载部署的规模。
接下来,更值得跟踪的是应用持续使用网络的情况。一个演示能够证明某项任务可以运行;一个长期运行的服务,还需要经受请求增加、设备波动和维护成本的检验。手机计算网络的价值,会在这些实际使用过程中逐渐变得清楚。
在这张网络里,$ACU 承担计算部署费用等网络用途。如果更多 AI 应用持续选择 Acurast,任务执行所产生的计算费用,就会成为观察代币使用需求的一条具体线索。理解它在这一赛道的发展空间,需要把应用的实际使用与代币用途联系起来。
回到那封需要分类的邮件:如果模型能在合适的时间内给出可用判断,应用能够稳定调用,开发者也能管理和维护这个服务,手机便承担了 AI 工作流程中的一个具体环节。
这就是我看待 Acurast 的角度。AI × DePIN 的发展空间,可以从这些细小、重复、能够被软件持续调用的任务里寻找。手机算力走进 AI 应用,需要一项项任务的执行来证明它的用途。