

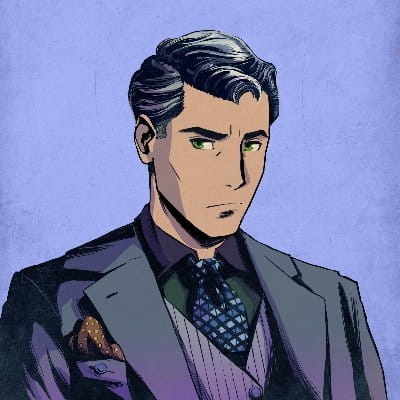
Testei 4 modelos de IA na improvisação criativa, alimentando-os com a mesma imagem e pedindo uma cena cômica de sitcom.
O desafio: esses modelos realmente fazem comédia? A maioria dos LLMs foi treinada em texto formal e tem dificuldade com timing, absurdidade e voz dos personagens — o núcleo da escrita de sitcom.
Pergunta técnica-chave aqui: o quão bem os modelos visão-linguagem conseguem conectar contexto visual à geração de narrativa com tom cômico? Isso testa tanto a compreensão multimodal quanto a geração criativa de texto sob restrição.
Vale verificar se algum modelo acertou a estrutura setup-punchline ou se todos apenas descreveram a imagem com humor forçado. Um teste real para saber se esses sistemas entendem timing cômico, ou apenas fazem correspondência de padrões com modelos de piada.