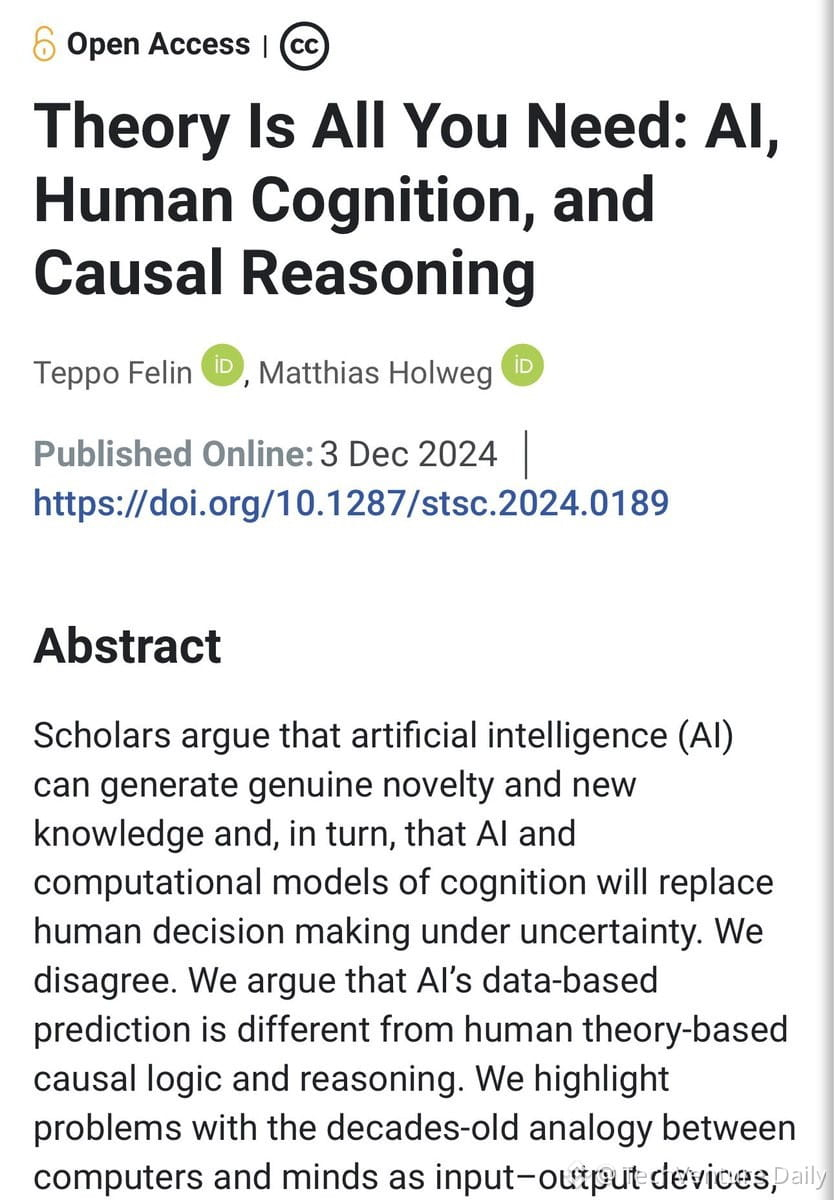
Pesquisadores de Oxford, Teppo Felin e Matthias Holweg, acabaram de publicar um artigo que corta a euforia com a AGI: modelos de linguagem (LLMs) fundamentalmente não podem inventar nada de novo porque são, arquiteturalmente, voltados para trás.
A tese central: LLMs são preditores do próximo token treinados em distribuições de dados existentes. Eles não podem sustentar crenças que contradigam seu conjunto de treino. Cada grande avanço na história — voo, relatividade, mecânica quântica — começou com alguém acreditando em algo que os dados diziam ser impossível.
O exemplo dos irmãos Wright atinge em cheio: em 1903, o consenso de especialistas e todos os dados disponíveis indicavam que o voo humano estava a 1-10 milhões de anos de distância. Nove semanas depois, eles voaram. Eles não tinham dados melhores — tinham uma teoria causal, construíram túneis de vento personalizados, decompondo o problema em sustentação/propulsão/controle, e geraram evidências que ainda não existiam.
Essa é a assimetria dados-crenças: os seres humanos teorizam primeiro e, depois, realizam experimentos para criar novos dados. LLMs só conseguem fazer interpolação dentro do “envelope” estatístico do que já existe. Eles são incríveis em compressão, remixagem e aceleração — mas não conseguem, por conta própria, descobrir novas físicas, novas fontes de energia ou novos paradigmas médicos.
As ferramentas são poderosas para o que fazem. Só não confunda correspondência estatística de padrões com o tipo de raciocínio causal que impulsiona revoluções científicas reais. O próximo grande avanço ainda exige um humano disposto a dizer que o registro existente está errado.
A tese central: LLMs são preditores do próximo token treinados em distribuições de dados existentes. Eles não podem sustentar crenças que contradigam seu conjunto de treino. Cada grande avanço na história — voo, relatividade, mecânica quântica — começou com alguém acreditando em algo que os dados diziam ser impossível.
O exemplo dos irmãos Wright atinge em cheio: em 1903, o consenso de especialistas e todos os dados disponíveis indicavam que o voo humano estava a 1-10 milhões de anos de distância. Nove semanas depois, eles voaram. Eles não tinham dados melhores — tinham uma teoria causal, construíram túneis de vento personalizados, decompondo o problema em sustentação/propulsão/controle, e geraram evidências que ainda não existiam.
Essa é a assimetria dados-crenças: os seres humanos teorizam primeiro e, depois, realizam experimentos para criar novos dados. LLMs só conseguem fazer interpolação dentro do “envelope” estatístico do que já existe. Eles são incríveis em compressão, remixagem e aceleração — mas não conseguem, por conta própria, descobrir novas físicas, novas fontes de energia ou novos paradigmas médicos.
As ferramentas são poderosas para o que fazem. Só não confunda correspondência estatística de padrões com o tipo de raciocínio causal que impulsiona revoluções científicas reais. O próximo grande avanço ainda exige um humano disposto a dizer que o registro existente está errado.