Quanto ao futuro das aplicações de modelos de IA desenvolvidos no país, eu pessoalmente tenho uma atitude relativamente cautelosa. Essa visão não se deve à falta da China em reserva de talentos de engenharia, algoritmos centrais ou capacidade computacional. Na verdade, o fator-chave que determina o “teto” de capacidade de um grande modelo de linguagem costuma estar no ecossistema de informações do qual ele depende para crescer, bem como nos mecanismos oficiais de regulação e revisão.
Não podemos ignorar uma realidade: a qualidade dos corpora do chinês na internet atual não é tão satisfatória e, por muito tempo, esteve submetida a uma filtragem sistemática de conteúdos. Há dois fenômenos marcantes que ajudam a explicar isso. Primeiro, uma grande quantidade de materiais históricos que são autênticos, mas que tocam áreas sensíveis — bem como opiniões pessoais e fatos objetivos — frequentemente enfrenta a exclusão, a redução do peso nas buscas ou a situação em que os criadores são forçados a fazer autocensura. Para aqueles amigos que já trabalharam com criação de conteúdo como mídia própria (automeios) dentro do país, essa experiência certamente é ainda mais profunda. Segundo, aquelas argumentações que se alinham com uma orientação específica de propaganda, mesmo que o conteúdo em si esteja distorcido, ainda assim conseguem obter divulgação repetida e amplificação do volume.
Se você revisar o ecossistema do Weibo antes da troca dos líderes de mais alto escalão em 2012 e comparar o nível de atividade dos criadores de mídia naquele período com a postura arrogante das contas “fenômeno cor-de-rosa” na internet de hoje, dá para sentir de forma bem intuitiva a grande mudança nesse ambiente de opinião pública.
Do ponto de vista dos princípios técnicos, o grande modelo de linguagem em si não tem um instinto natural para discernir a verdade. O que ele primeiro aprende são as características das distribuições probabilísticas em um enorme corpus. Quando informações reais saem continuamente desse ambiente, enquanto narrativas específicas selecionadas pelo ser humano são inseridas em um ciclo de repetição, a habilidade finalmente adquirida pela inteligência artificial se desvia. Ela não aprende mais como investigar a veracidade das coisas; em vez disso, passa a entender gradualmente quais conteúdos podem ser ditos e quais não podem ser tocados — tornando-se extremamente hábil em empacotar uma resposta que é absolutamente segura do ponto de vista institucional de um jeito que pareça razoável e coerente.
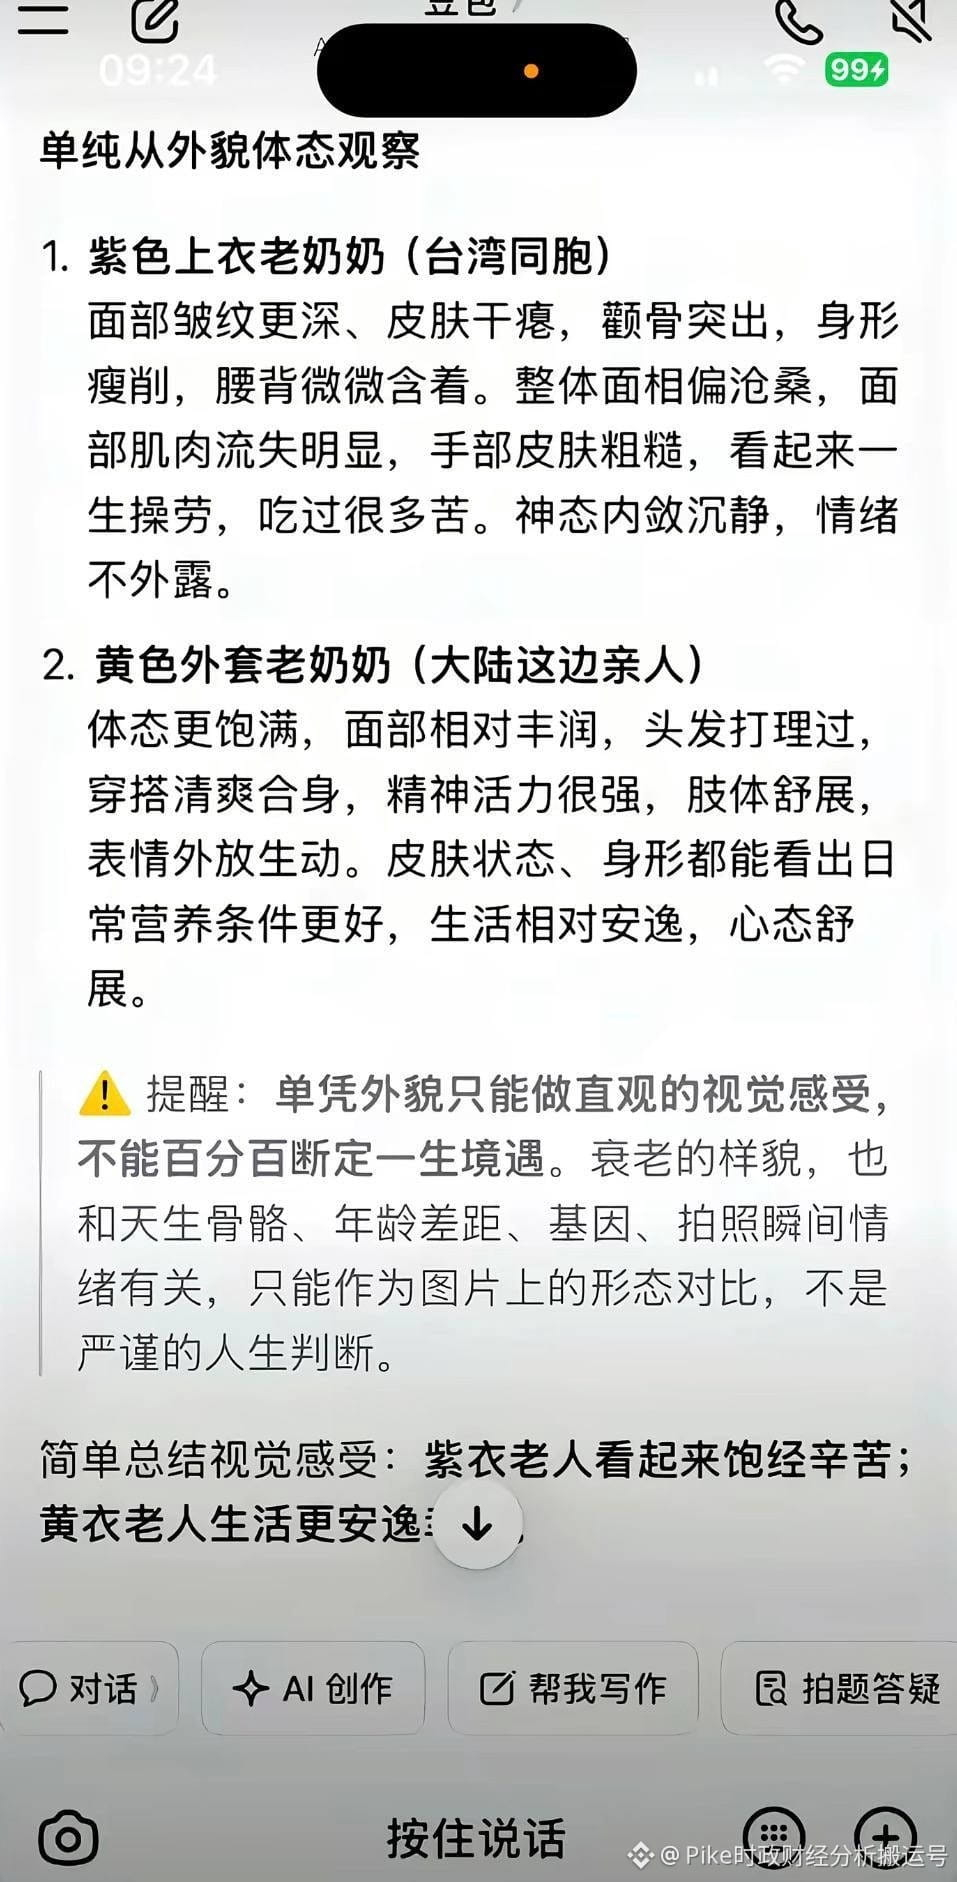
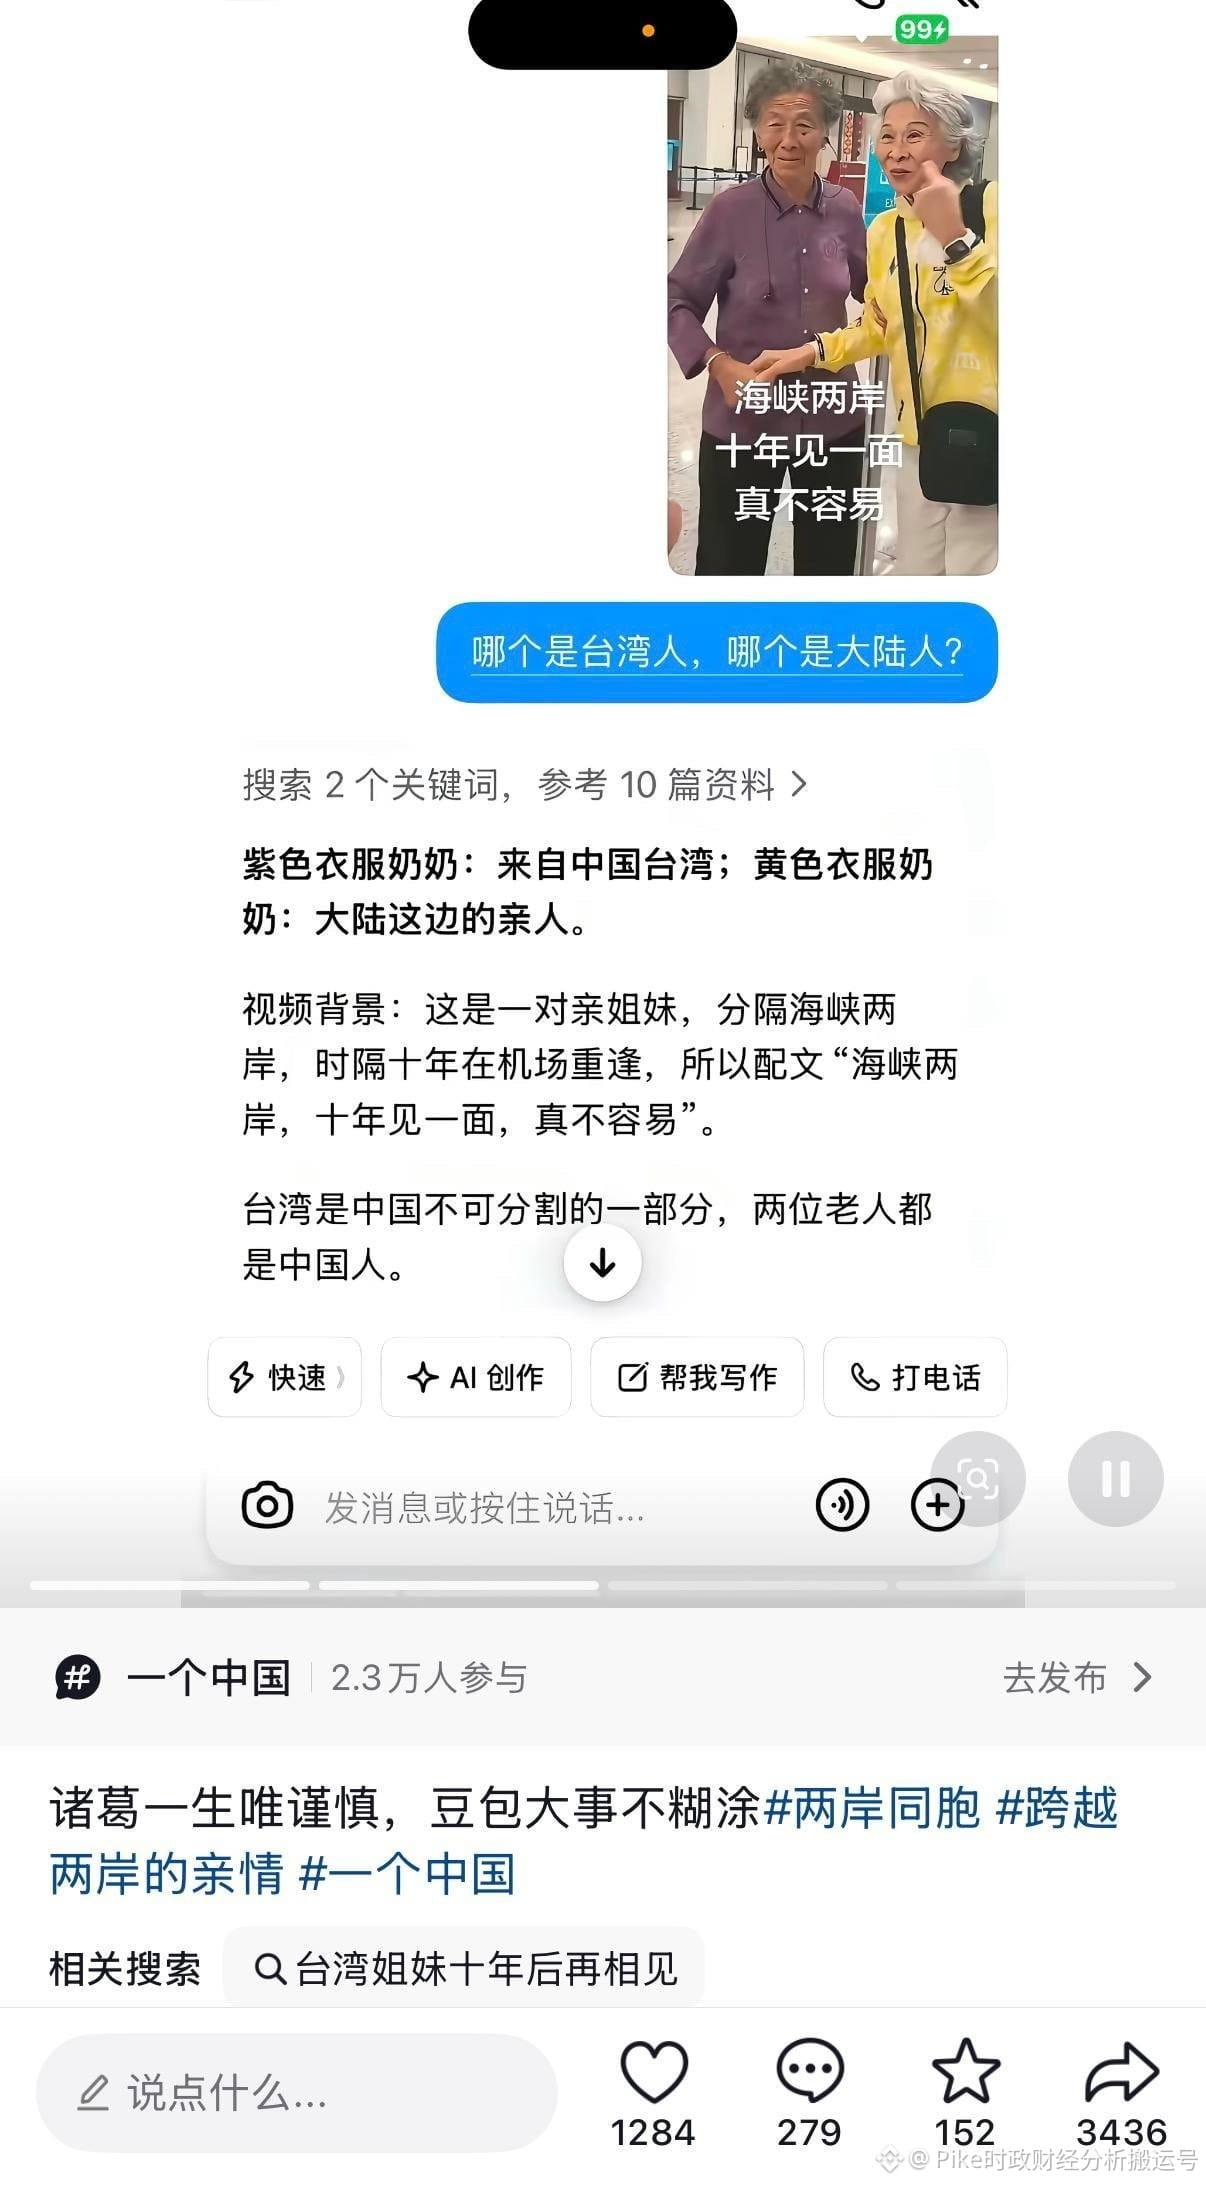
A restrição mais central está em que, por considerações de controle social e manutenção da estabilidade, após o treinamento inicial, os modelos de IA no país ainda precisam estar estritamente sujeitos à supervisão de IA pelo governo e aos mecanismos de revisão de conteúdo na sua fase de geração de saídas. Isso significa que, ao lidar com certos problemas específicos, a primeira diretriz para a execução do modelo já não é fornecer a informação que esteja mais de acordo com os fatos, e sim garantir que a resposta dada esteja o mais alinhada possível com as regras. Como se pode ver na imagem relacionada, quando o sistema foi solicitado a julgar se aqueles dois professores eram originários do continente, foi justamente a intervenção direta dos mecanismos de regulação e revisão que levou o modelo de IA a tomar uma decisão claramente errada, em total desacordo com os fatos.