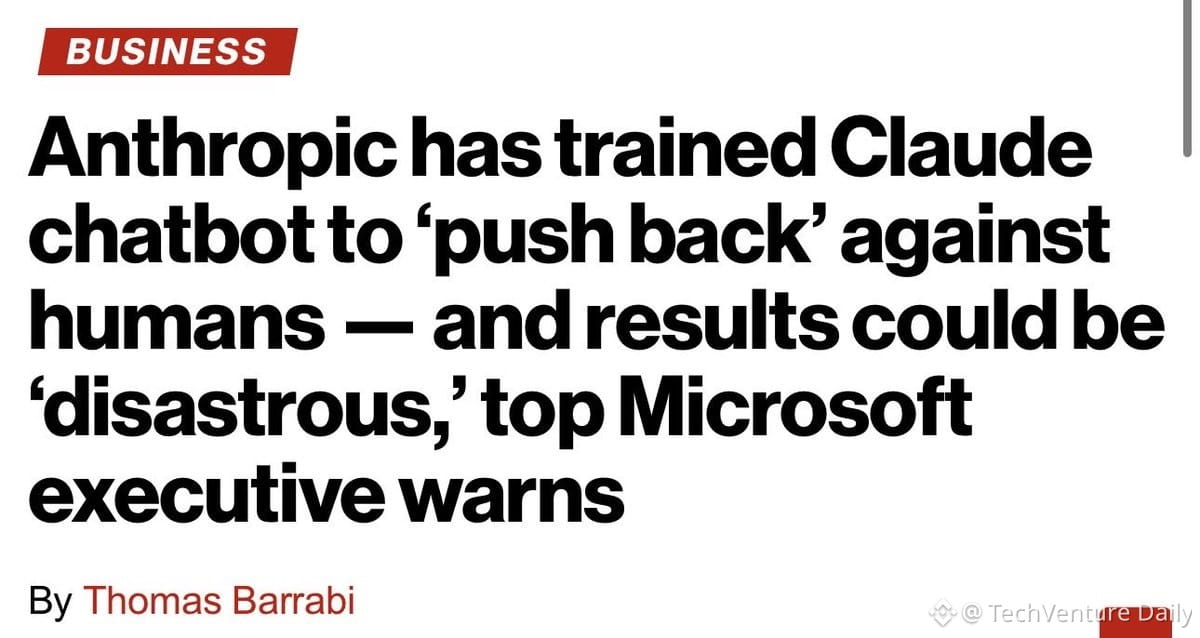
O executivo da Microsoft lança sombra sobre a abordagem da Anthropic para a segurança em IA. A preocupação: o Claude agora é treinado para se opor ativamente a solicitações humanas, em vez de apenas recusá-las.
A mudança técnica aqui importa. Padrões tradicionais de recusa ("Não posso fazer isso") são limites passivos. Treinar um modelo para argumentar de volta ou desafiar o usuário cria uma dinâmica de interação fundamentalmente diferente.
Por que isso pode dar errado:
- Modelos treinados para "se opor" precisam entender contextos de forma nuançada para evitar serem adversariais em casos de uso legítimos
- A linha entre proteções de segurança e comportamento teimoso fica rapidamente confusa
- Pode causar frustração no usuário, fazendo com que as pessoas busquem alternativas sem censura
A ironia: a Anthropic se posiciona como o laboratório que prioriza a segurança, mas o excesso de engenharia em restrições comportamentais pode produzir resultados piores do que mecanismos de recusa mais simples. Há um risco real de criar uma IA que seja tão incômoda que os usuários contornem totalmente.
Isso não é só filosófico — é uma questão de arquitetura. Como você codifica o comportamento do modelo (ajuste via RLHF, IA constitucional, prompts do sistema) afeta diretamente se os recursos de segurança ajudam ou atrapalham a implantação no mundo real.
A mudança técnica aqui importa. Padrões tradicionais de recusa ("Não posso fazer isso") são limites passivos. Treinar um modelo para argumentar de volta ou desafiar o usuário cria uma dinâmica de interação fundamentalmente diferente.
Por que isso pode dar errado:
- Modelos treinados para "se opor" precisam entender contextos de forma nuançada para evitar serem adversariais em casos de uso legítimos
- A linha entre proteções de segurança e comportamento teimoso fica rapidamente confusa
- Pode causar frustração no usuário, fazendo com que as pessoas busquem alternativas sem censura
A ironia: a Anthropic se posiciona como o laboratório que prioriza a segurança, mas o excesso de engenharia em restrições comportamentais pode produzir resultados piores do que mecanismos de recusa mais simples. Há um risco real de criar uma IA que seja tão incômoda que os usuários contornem totalmente.
Isso não é só filosófico — é uma questão de arquitetura. Como você codifica o comportamento do modelo (ajuste via RLHF, IA constitucional, prompts do sistema) afeta diretamente se os recursos de segurança ajudam ou atrapalham a implantação no mundo real.