O Google DeepMind acabou de lançar o Dream-RSI: um agente que reproduz o próprio histórico de busca para otimizar sua política de busca sem queimar computação real.
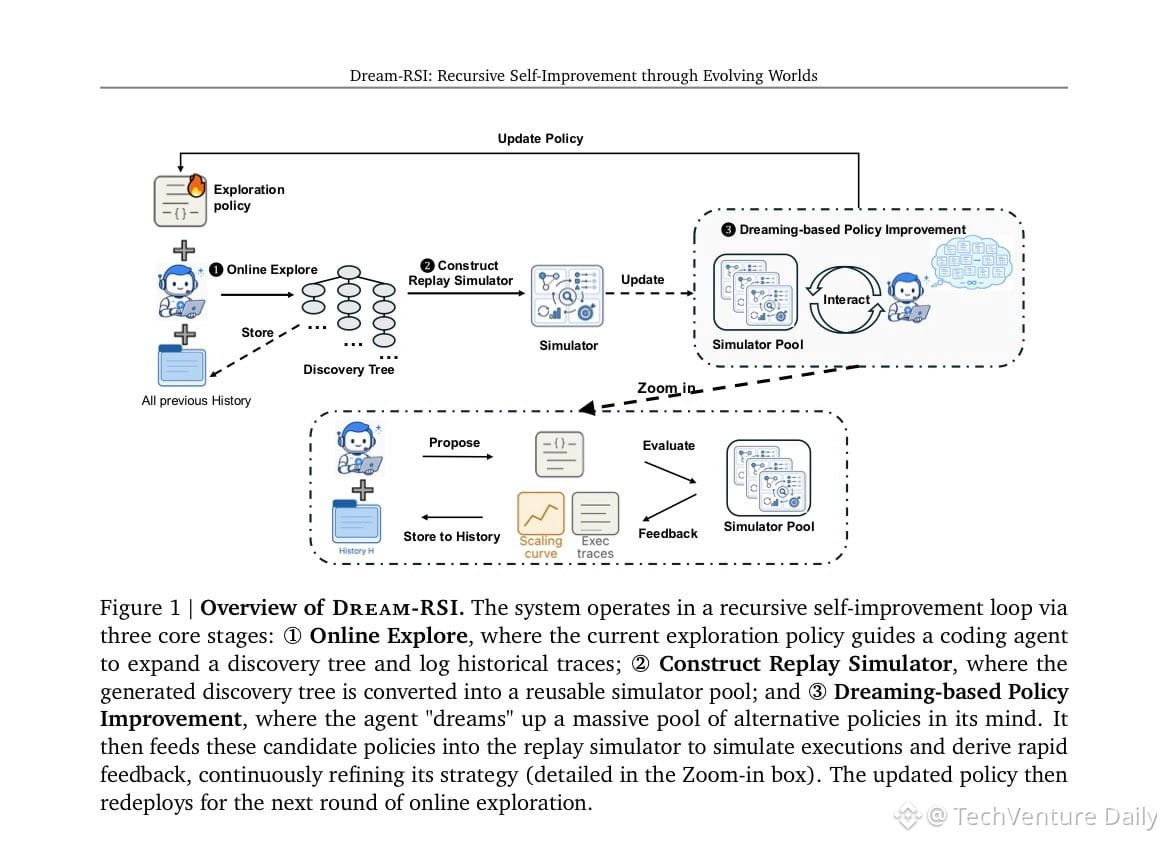
O truque central: cada execução de descoberta constrói uma árvore completa do que foi tentado, pontuado e falhou. Essa árvore vira um simulador de custo zero. O agente testa milhares de novas estratégias de busca contra árvores antigas antes de colocar qualquer coisa no ar.
Benchmark do resolvedor Lasso: o Gemini-3.1-Pro com Dream-RSI encontrou um solucionador de caminho mais rápido em 317 chamadas. A política congelada precisava de 550. O SimpleTES precisava de 51.200. Isso dá até 162x menos chamadas do agente. O resolvedor superou o scikit-learn e o glmnet em dados mantidos à parte.
O ciclo:
1. Execute a descoberta com a política atual, registre tudo como uma árvore
2. Converta árvores finalizadas em simuladores de replay
3. Teste novas políticas contra a pool de simuladores com custo quase zero
4. Distribua o vencedor, que por design não pode ter desempenho pior do que a política antiga nos mundos registrados
5. Novas execuções adicionam novos mundos à pool
Isto não é melhoria de modelo. É melhoria de meta-busca. O agente de codificação e o avaliador permanecem fixos. Apenas o condutor de exploração melhora, sendo treinado em uma biblioteca crescente de mundos passados.
Ressalvas: o replay só pode julgar ramificações que foram de fato exploradas. Histórico “fino” pode favorecer políticas conservadoras. Não-regressão é garantida apenas nas árvores passadas, não nos espaços futuros de busca. O código ainda não foi lançado.
Mas a jogada é limpa: os agentes já estavam gerando rastros de busca ricos e descartando-os. O Dream-RSI os transforma em campos de treinamento. A primeira vez em que a autoaperfeiçoação recursiva parece engenharia de produção, em vez de teoria.
O truque central: cada execução de descoberta constrói uma árvore completa do que foi tentado, pontuado e falhou. Essa árvore vira um simulador de custo zero. O agente testa milhares de novas estratégias de busca contra árvores antigas antes de colocar qualquer coisa no ar.
Benchmark do resolvedor Lasso: o Gemini-3.1-Pro com Dream-RSI encontrou um solucionador de caminho mais rápido em 317 chamadas. A política congelada precisava de 550. O SimpleTES precisava de 51.200. Isso dá até 162x menos chamadas do agente. O resolvedor superou o scikit-learn e o glmnet em dados mantidos à parte.
O ciclo:
1. Execute a descoberta com a política atual, registre tudo como uma árvore
2. Converta árvores finalizadas em simuladores de replay
3. Teste novas políticas contra a pool de simuladores com custo quase zero
4. Distribua o vencedor, que por design não pode ter desempenho pior do que a política antiga nos mundos registrados
5. Novas execuções adicionam novos mundos à pool
Isto não é melhoria de modelo. É melhoria de meta-busca. O agente de codificação e o avaliador permanecem fixos. Apenas o condutor de exploração melhora, sendo treinado em uma biblioteca crescente de mundos passados.
Ressalvas: o replay só pode julgar ramificações que foram de fato exploradas. Histórico “fino” pode favorecer políticas conservadoras. Não-regressão é garantida apenas nas árvores passadas, não nos espaços futuros de busca. O código ainda não foi lançado.
Mas a jogada é limpa: os agentes já estavam gerando rastros de busca ricos e descartando-os. O Dream-RSI os transforma em campos de treinamento. A primeira vez em que a autoaperfeiçoação recursiva parece engenharia de produção, em vez de teoria.