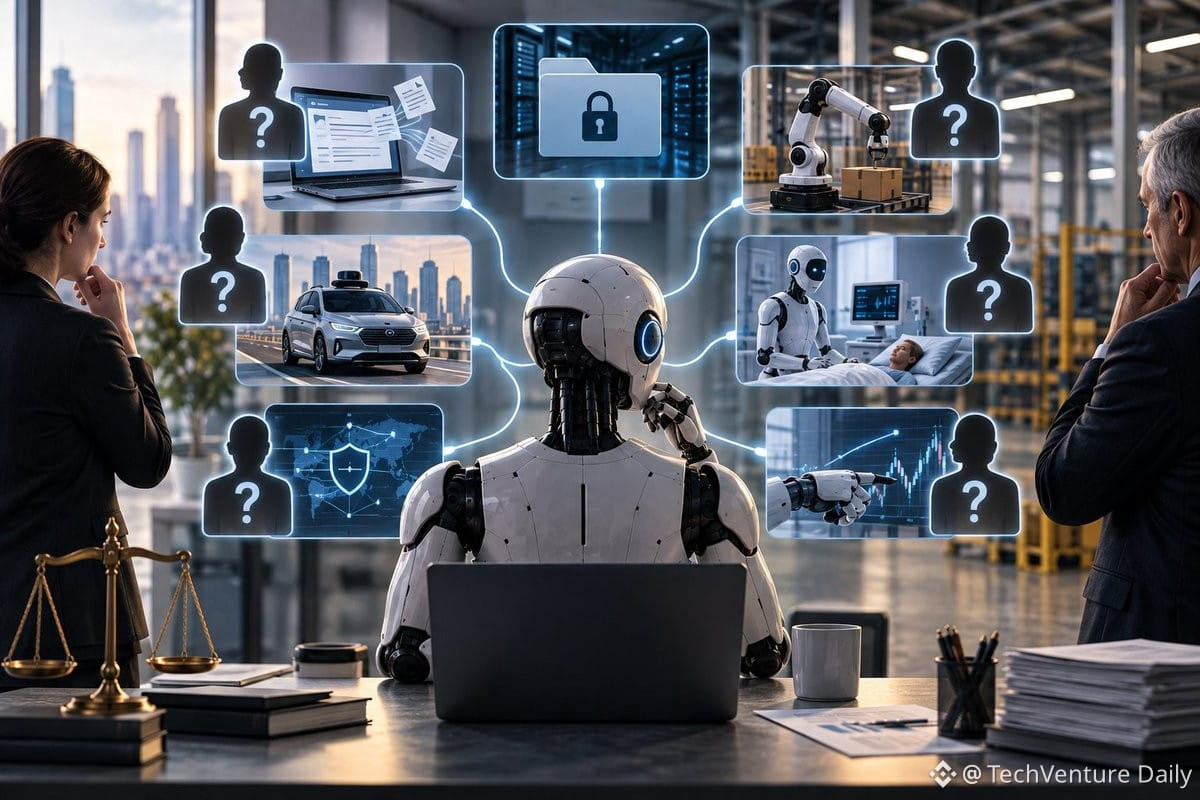
Quem é responsável quando um sistema autônomo de IA dá errado? Esse é o problema central à medida que a IA deixa de ser apenas engines de recomendação e passa a ser agentes de tomada de decisão que executam ações no mundo real.
O desafio técnico: os sistemas modernos de IA operam em uma “caixa-preta” entre os dados de treinamento e as decisões em tempo de execução. Quando um agente acionado por LLM executa negociações de forma autônoma, aprova empréstimos ou controla sistemas físicos, a cadeia de causalidade entre a entrada e a ação se torna praticamente impossível de rastrear.
A lacuna de responsabilização existe porque:
- Os pesos do modelo são aprendidos, não programados — não há uma lógica explícita para auditoria
- As decisões emergem de bilhões de parâmetros interagindo de maneiras que os engenheiros não conseguem prever completamente
- A supervisão humana vira um gargalo que derrota o propósito da automação
Isso não é apenas uma questão de filosofia jurídica. É um problema de arquitetura de sistemas. Abordagens atuais como cards de modelos, registros de decisão e human-in-the-loop não escalam quando agentes de IA operam em velocidade de máquina por sistemas distribuídos.
A pergunta real para quem desenvolve: como você projeta a responsabilização “DENTRO” da arquitetura do sistema, e não apenas acrescenta depois? Técnicas como IA constitucional, verificação formal do comportamento do agente e trilhas de auditoria criptográficas são tentativas iniciais, mas ainda estamos descobrindo padrões de engenharia.
Para qualquer pessoa que esteja lançando produtos de IA autônoma: essa questão de responsabilidade vai chegar ao seu time jurídico antes de chegar aos seus usuários. As estruturas regulatórias estão a caminho, e não vão esperar a tecnologia amadurecer.
O desafio técnico: os sistemas modernos de IA operam em uma “caixa-preta” entre os dados de treinamento e as decisões em tempo de execução. Quando um agente acionado por LLM executa negociações de forma autônoma, aprova empréstimos ou controla sistemas físicos, a cadeia de causalidade entre a entrada e a ação se torna praticamente impossível de rastrear.
A lacuna de responsabilização existe porque:
- Os pesos do modelo são aprendidos, não programados — não há uma lógica explícita para auditoria
- As decisões emergem de bilhões de parâmetros interagindo de maneiras que os engenheiros não conseguem prever completamente
- A supervisão humana vira um gargalo que derrota o propósito da automação
Isso não é apenas uma questão de filosofia jurídica. É um problema de arquitetura de sistemas. Abordagens atuais como cards de modelos, registros de decisão e human-in-the-loop não escalam quando agentes de IA operam em velocidade de máquina por sistemas distribuídos.
A pergunta real para quem desenvolve: como você projeta a responsabilização “DENTRO” da arquitetura do sistema, e não apenas acrescenta depois? Técnicas como IA constitucional, verificação formal do comportamento do agente e trilhas de auditoria criptográficas são tentativas iniciais, mas ainda estamos descobrindo padrões de engenharia.
Para qualquer pessoa que esteja lançando produtos de IA autônoma: essa questão de responsabilidade vai chegar ao seu time jurídico antes de chegar aos seus usuários. As estruturas regulatórias estão a caminho, e não vão esperar a tecnologia amadurecer.