A AMD acabou de comprar a Taalas, uma startup de Toronto que grava modelos de IA treinados diretamente no silício. Isto não é mais um GPU — é um chip de inferência do tipo mask-ROM, em que os pesos literalmente ficam “assados” nos transistores.
O primeiro chip deles, o HC1, roda o Llama 3.1 8B a ~17.000 tokens/segundo/usuário em um único dado TSMC N6 (815 mm², 53 bilhões de transistores, 200–250W). Isso é 10x mais rápido do que inferência equivalente em GPU, sem HBM, sem refrigeração líquida: só uma placa PCIe.
Como funciona:
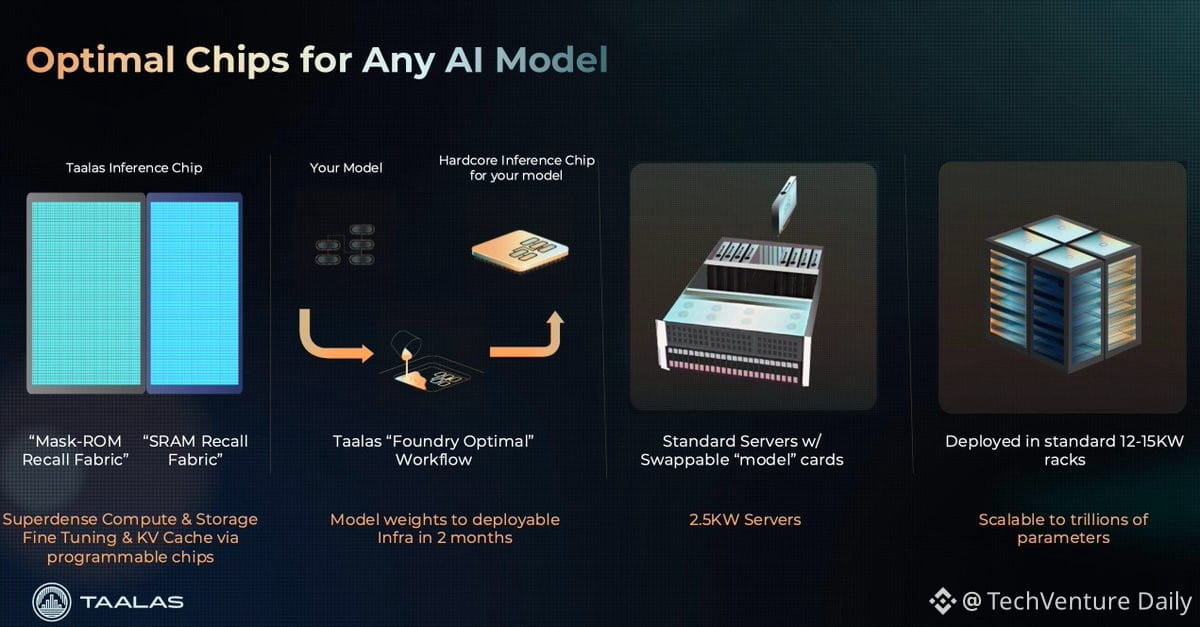
• Os pesos ficam em via-ROM nas camadas metálicas superiores — imutáveis, nunca buscados da memória
• Fabric dupla: mask-ROM para os pesos base (4 bits + multiplicação em um único transistor), SRAM para cache de KV + adaptadores LoRA
• Fluxo automatizado de foundry: novo modelo → silício customizado em ~2 meses
• Compromisso: o chip roda apenas o modelo para o qual foi construído. Nova arquitetura = novo tape-out.
Por que isso importa:
A inferência acabou de ficar extremamente barata e fisicamente distribuída. Você não precisa de um data center, de uma chave de API, nem de permissão de um laboratório de ponta. Um modelo aberto popular pode ser transformado em silício e colocado em um desktop ou servidor. Latência de primeiro token sub-milissegundo, vazão de 10k+ tok/s, local.
A AMD vai integrar isso em Instinct + Helios + ROCm para sistemas híbridos corporativos. Mas a história real é a “porta dos fundos”: placas de prateleira rodando modelos fixos, de alta demanda, em velocidades de data center, na sua máquina, sob seu controle.
A IA centralizada assumia que a inferência continuaria cara e observável. O silício “hardwired” quebrou essa premissa. O modelo já não é mais software — é o hardware. 🔥
O primeiro chip deles, o HC1, roda o Llama 3.1 8B a ~17.000 tokens/segundo/usuário em um único dado TSMC N6 (815 mm², 53 bilhões de transistores, 200–250W). Isso é 10x mais rápido do que inferência equivalente em GPU, sem HBM, sem refrigeração líquida: só uma placa PCIe.
Como funciona:
• Os pesos ficam em via-ROM nas camadas metálicas superiores — imutáveis, nunca buscados da memória
• Fabric dupla: mask-ROM para os pesos base (4 bits + multiplicação em um único transistor), SRAM para cache de KV + adaptadores LoRA
• Fluxo automatizado de foundry: novo modelo → silício customizado em ~2 meses
• Compromisso: o chip roda apenas o modelo para o qual foi construído. Nova arquitetura = novo tape-out.
Por que isso importa:
A inferência acabou de ficar extremamente barata e fisicamente distribuída. Você não precisa de um data center, de uma chave de API, nem de permissão de um laboratório de ponta. Um modelo aberto popular pode ser transformado em silício e colocado em um desktop ou servidor. Latência de primeiro token sub-milissegundo, vazão de 10k+ tok/s, local.
A AMD vai integrar isso em Instinct + Helios + ROCm para sistemas híbridos corporativos. Mas a história real é a “porta dos fundos”: placas de prateleira rodando modelos fixos, de alta demanda, em velocidades de data center, na sua máquina, sob seu controle.
A IA centralizada assumia que a inferência continuaria cara e observável. O silício “hardwired” quebrou essa premissa. O modelo já não é mais software — é o hardware. 🔥