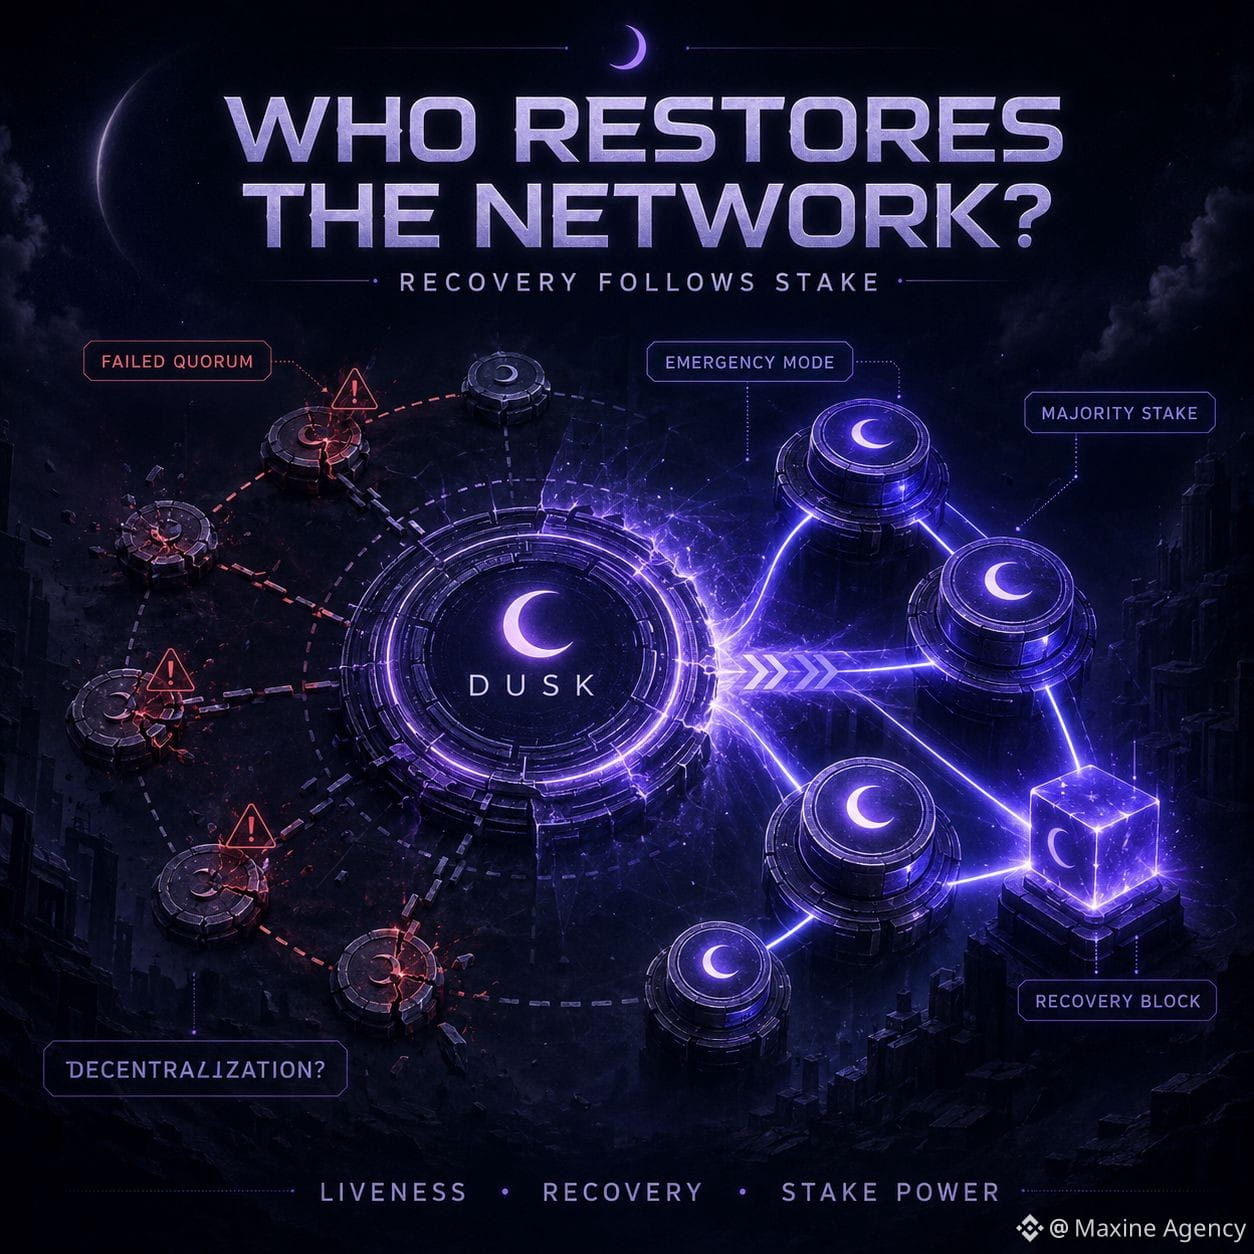
À medida que o Dusk encontra problemas, eu fico ainda mais atento a quem está no controle da recuperação da rede
Ao ler a seção de consenso do Dusk, vejo que o mecanismo “padrão” ainda não é o ponto mais preocupante. O que chama atenção é o momento em que a rede não consegue atingir quorum de forma contínua.
Após 16 iterações malsucedidas, a Succinct Attestation muda para o modo de emergência. O timeout de cada etapa é removido e várias iterações podem ser abertas ao mesmo tempo para aumentar as chances de encontrar um bloco válido. Se vários candidatos atingirem o consenso, o bloco pertencente à iteração mais baixa é priorizado.
Esse desenho ajuda a rede a não ficar travada apenas por causa de alguns provisioners lentos ou desconectados. Mas também me faz observar outro limite: quando as condições de rede pioram, a capacidade de recuperação passa a depender de forma ainda mais clara da distribuição de stake.
No plano final, o bloco de emergência só é criado quando o grupo de provisioners solicita que ele detenha a maioria do stake total da rede. Enquanto isso, para querer participar diretamente do consenso, um provisioner precisa atualmente de pelo menos 1.000 DUSK em stake.
Assim, eu não considero o staking apenas como uma forma de obter recompensas. Ele também determina quem tem mais peso quando o sistema precisa sair de um estado anormal.
Para mim, o teste mais importante para o Dusk não é um único dia em que a rede roda sem problemas. Mas sim quando a congestão aumenta, alguns nós ficam para trás e os comitês mudam continuamente, e a rede consegue se recuperar sem concentrar demais o poder de decisão em um grupo com um stake muito grande ou não.
Um mecanismo de recovery pode ser muito sólido do ponto de vista técnico.
Mas se o poder de salvar a rede está cada vez mais concentrado por stake, então a descentralização é o que precisa ser medido com mais cuidado.
@Dusk $DUSK #dusk
$ONDO $BTC
Ao ler a seção de consenso do Dusk, vejo que o mecanismo “padrão” ainda não é o ponto mais preocupante. O que chama atenção é o momento em que a rede não consegue atingir quorum de forma contínua.
Após 16 iterações malsucedidas, a Succinct Attestation muda para o modo de emergência. O timeout de cada etapa é removido e várias iterações podem ser abertas ao mesmo tempo para aumentar as chances de encontrar um bloco válido. Se vários candidatos atingirem o consenso, o bloco pertencente à iteração mais baixa é priorizado.
Esse desenho ajuda a rede a não ficar travada apenas por causa de alguns provisioners lentos ou desconectados. Mas também me faz observar outro limite: quando as condições de rede pioram, a capacidade de recuperação passa a depender de forma ainda mais clara da distribuição de stake.
No plano final, o bloco de emergência só é criado quando o grupo de provisioners solicita que ele detenha a maioria do stake total da rede. Enquanto isso, para querer participar diretamente do consenso, um provisioner precisa atualmente de pelo menos 1.000 DUSK em stake.
Assim, eu não considero o staking apenas como uma forma de obter recompensas. Ele também determina quem tem mais peso quando o sistema precisa sair de um estado anormal.
Para mim, o teste mais importante para o Dusk não é um único dia em que a rede roda sem problemas. Mas sim quando a congestão aumenta, alguns nós ficam para trás e os comitês mudam continuamente, e a rede consegue se recuperar sem concentrar demais o poder de decisão em um grupo com um stake muito grande ou não.
Um mecanismo de recovery pode ser muito sólido do ponto de vista técnico.
Mas se o poder de salvar a rede está cada vez mais concentrado por stake, então a descentralização é o que precisa ser medido com mais cuidado.
@Dusk $DUSK #dusk
$ONDO $BTC