

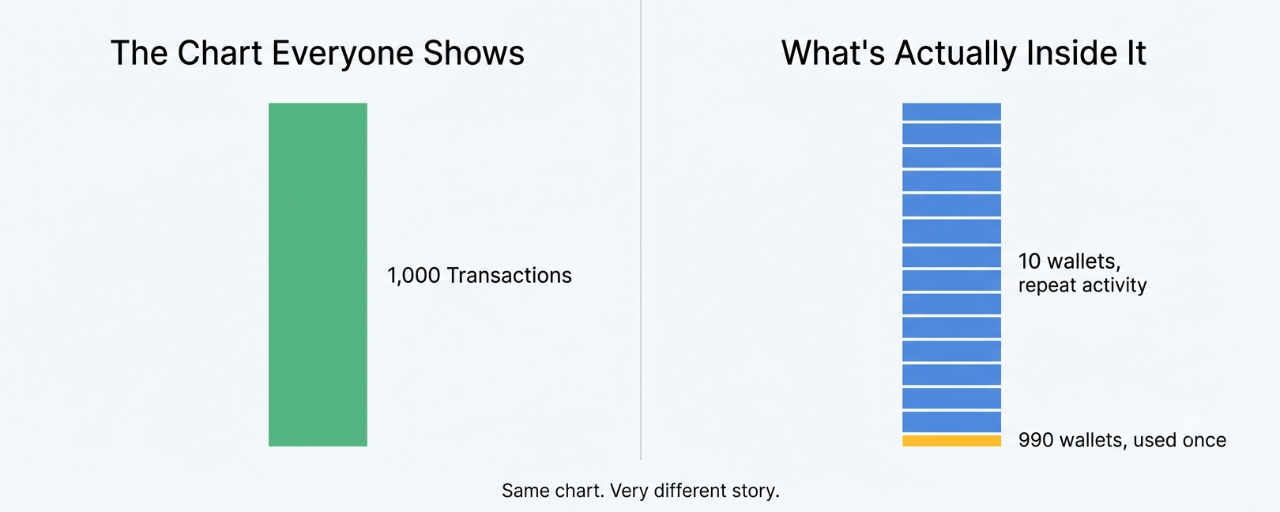

Eu estava atualizando um agregador de DEX mais cedo só para ver se o slippage melhorou em uma troca que eu estava adiando e acabei me distraindo lendo uma thread discutindo quais projetos de “cripto IA” têm “utilidade real”. Todo mundo ficava jogando gráficos de uso como se eles tivessem encerrado o debate. Fechei essa aba também, sinceramente.
Então, por curiosidade, eu fui lá e consultei pessoalmente a atividade on-chain do Newton Protocol, só para ver como essa “utilidade” realmente parece em números crus, e não no gráfico de alguém do Twitter.
E algo clicou de um jeito que eu não esperava — a contagem de transações parece saudável, de verdade. Mas quando comecei a fuçar quais endereços estavam gerando esse volume, é um conjunto muito menor de carteiras do que o número principal sugere. Não é falso, não está vazio, só... concentrado. Um punhado de endereços fazendo muita atividade repetida, e uma cauda bem mais longa de endereços que tocaram o protocolo uma vez e nunca mais voltaram.
O que as pessoas assumem quando dizem “utilidade vai decidir o vencedor” é que utilidade equivale ao volume de transações, ponto final — mais atividade significa mais uso no mundo real, mais capacidade de sustentar. O que parece estar acontecendo de fato é que uma parte desse volume é de um grupo pequeno de carteiras — possivelmente bots, possivelmente usuários avançados, possivelmente a infraestrutura de testes do time — que, de fora, não dá para saber com certeza — repetindo transações em ciclo, o que infla o número de “uso” sem necessariamente refletir uma adoção orgânica ampla. Dez carteiras fazendo mil transações cada parece idêntico, em um gráfico de barras, a mil carteiras fazendo dez cada. Mas não é a mesma coisa de jeito nenhum.
Não estou totalmente convencido de que isso seja exclusivo de Newton; para deixar claro, isso é basicamente verdade na maioria das cadeias e protocolos em fase inicial, hoje em dia. Mas aqui está a parte que me incomoda: se “utilidade” é a métrica que todo mundo está usando para escolher os vencedores, e se a utilidade atualmente é indistinguível entre “uma demanda ampla e genuína” e “uso repetido concentrado de um grupo pequeno”, então o arcabouço inteiro que as pessoas estão usando para classificar esses projetos pode estar medindo a coisa errada. Ou, pelo menos, medindo algo que parece ser a coisa certa sem realmente ser.
Achei que talvez o crescimento único de carteiras esclarecesse isso — tipo, se novos endereços estão subindo de forma constante, isso é um bom proxy para adoção ampla, independentemente do que as principais carteiras estejam fazendo. Mas, na prática, verificando especificamente isso, os novos endereços únicos estão crescendo, só que a uma taxa perceptivelmente mais lenta do que a contagem bruta de transações. Então não é “crescimento falso”; é mais como um crescimento acontecendo em dois trilhos diferentes, com duas velocidades diferentes, e apenas um deles aparece no número da manchete.
Isso importa para qualquer pessoa que tente classificar projetos de “IA cripto” de forma realmente baseada em utilidade, e não por narrativa, porque, se a métrica padrão não consegue distinguir a diferença entre um protocolo com demanda distribuída real e um com um grupo menor de usuários pesados, então a maioria das comparações que estão sendo feitas agora — Newton versus seus pares, esta geração de projetos uns contra os outros — provavelmente é menos significativa do que parece. Não é que utilidade não importe. É que “utilidade”, como está sendo medida atualmente, pode não estar medindo utilidade.
Quem isso afeta de verdade: qualquer pessoa que esteja alocando capital com base em comparações de gráficos de uso entre projetos de IA-cripto, assumindo que esses gráficos são iguais “de maçã com maçã”. Talvez não sejam, de projeto para projeto, dependendo de quão concentrada é a atividade subjacente das carteiras.
Quando isso deixaria de ser um problema? Provavelmente quando alguém construir um jeito decente de separar “uso único significativo” de “uso repetido por um conjunto pequeno de endereços” como uma métrica pública e comparável. Eu ainda não vi isso ser feito bem, nem para Newton nem, de verdade, para ninguém nesse espaço. Talvez já exista em algum lugar e eu só não tenha encontrado.
@NewtonProtocol #Newt $NEWT