



Organizado e compilado por: Sunny, Shenchao TechFlow
O protocolo de computação Blockchain AI Gensyn anunciou em 12 de junho que havia concluído um financiamento Série A de US$ 43 milhões liderado por a16z.
A missão da Gensyn é fornecer aos usuários acesso a uma escala de computação equivalente à posse de um cluster de computação privado e, principalmente, alcançar um acesso justo que evite o controle ou desligamento por qualquer entidade central. Enquanto isso, Gensyn é um protocolo de computação descentralizado focado no treinamento de modelos de aprendizado de máquina.
Olhando para o podcast dos fundadores da Gensyn, Harry e Ben, com a Epicenter no final do ano passado, você pode descobrir que eles discutiram profundamente a investigação de recursos de computação, incluindo AWS, infraestrutura local e infraestrutura de nuvem, para entender como otimizar e utilizar esses recursos para apoiar o desenvolvimento de aplicações de IA.
Ao mesmo tempo, eles também discutiram detalhadamente a filosofia de design, os objetivos e o posicionamento de mercado da Gensyn, bem como as diversas restrições, suposições e estratégias de execução enfrentadas durante o processo de design.
O podcast apresenta as quatro funções principais da rede fora da cadeia Gensyn, explora as características da rede on-chain Gensyn e a importância dos tokens e governança Gensyn.
Além disso, Ben e Harry também compartilharam algumas ciências interessantes sobre IA para dar a todos uma compreensão mais profunda dos princípios básicos e aplicações da inteligência artificial.
Apresentador: Dra. Friederike Ernst, Podcast Epicentro
Palestrantes: Ben Fielding e Harry Grieve, cofundadores da Gensyn
Título original: "Ben Fielding & Harry Grieve: Gensyn – The Deep Learning Compute Protocol"
Data de transmissão: 24 de novembro de 2022
Blockchain como camada de confiança para infraestrutura de IA descentralizada
O anfitrião perguntou a Ben e Harry por que eles combinaram sua rica experiência em IA e aprendizado profundo com blockchain.
Ben disse que a decisão deles não foi tomada da noite para o dia, mas após um período de tempo relativamente longo. O objetivo da Gensyn é construir uma infraestrutura de IA em grande escala e, ao pesquisar como alcançar a escalabilidade máxima, eles perceberam que era necessária uma camada sem confiança.
Eles precisam ser capazes de consolidar os recursos de computação sem depender da integração centralizada de novos provedores ou de enfrentar restrições de expansão administrativa. Para resolver esse problema, eles começaram a explorar pesquisas de computação verificável, mas descobriram que isso sempre exigia um terceiro ou juiz de confiança para verificar a computação.
Essa limitação os levou ao blockchain. Blockchain fornece uma maneira de acabar com a necessidade de um único tomador de decisão ou árbitro porque permite o consenso entre grandes grupos.
Harry também compartilhou sua filosofia de que ele e Ben apoiam fortemente a liberdade de expressão e estão preocupados com a censura.
Antes de migrarem para o blockchain, eles estavam analisando o aprendizado federado, um campo de aprendizado profundo onde você treina vários modelos em fontes de dados distribuídas e depois os combina para criar um metamodelo que pode aprender com todas as fontes de dados. Eles trabalham com bancos nesta abordagem. Porém, logo perceberam que o maior problema era adquirir os recursos computacionais ou processadores que pudessem treinar esses modelos.
Para maximizar a integração dos recursos computacionais, eles precisam de um método de coordenação descentralizado, e é aí que entra o blockchain.
Pesquisa de recursos de computação de mercado: AWS, infraestrutura local e infraestrutura em nuvem
Harry explicou as diferentes opções de recursos computacionais para executar modelos de IA, dependendo do tamanho do modelo.
Os alunos podem usar AWS ou máquinas locais, as startups podem escolher AWS sob demanda ou opções programadas mais baratas.
Mas para necessidades de GPU em grande escala, a AWS pode ser limitada pelo custo e pela escalabilidade e muitas vezes opta por construir infraestrutura interna.
A pesquisa mostra que muitas organizações estão lutando para escalar, e algumas até optam por comprar e gerenciar elas próprias GPUs. No geral, comprar uma GPU é mais econômico no longo prazo do que executá-la na AWS.
As opções para recursos de computação de aprendizado de máquina incluem computação em nuvem, execução local de modelos de IA ou construção de seu próprio cluster de computação. O objetivo da Gensyn é fornecer acesso à mesma escala computacional de ter seu próprio cluster, e a chave é alcançar um acesso justo, que não pode ser controlado ou desativado por nenhuma entidade central.
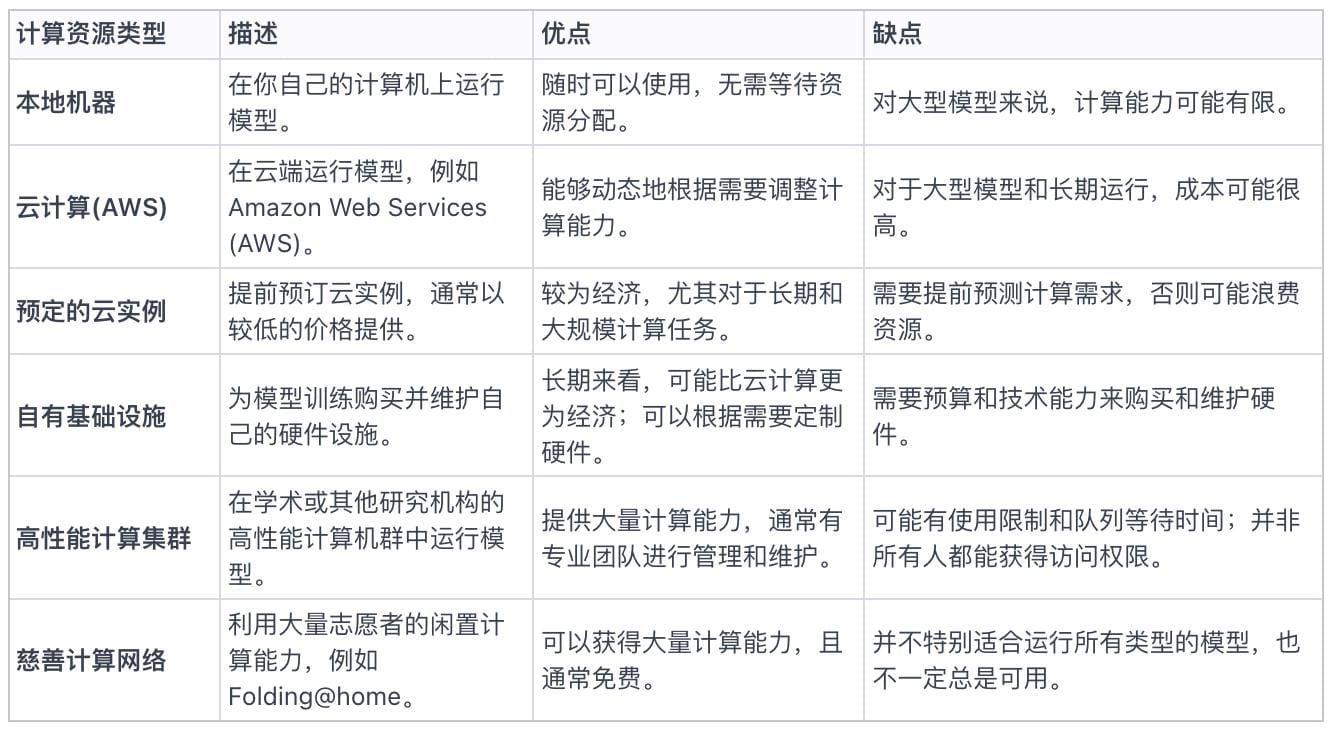
Tabela 1: Todas as opções de recursos computacionais atualmente no mercado
Discussão sobre a filosofia de design, objetivos e posicionamento de mercado da Gensyn
O anfitrião perguntou como o Gensyn é diferente dos projetos anteriores de computação blockchain, como a Golem Network.
Harry explica que a filosofia de design da Gensyn é considerada principalmente em dois eixos:
A granularidade do protocolo: Ao contrário dos protocolos de computação de uso geral como o Golem, o Gensyn é um protocolo granular focado no treinamento de modelos de aprendizado de máquina.
Escalabilidade verificada: Os primeiros projetos geralmente dependem de métodos de reputação ou replicação que são menos tolerantes a falhas bizantinas, que não têm confiança suficiente nos resultados do aprendizado de máquina. Gensyn visa aproveitar o aprendizado de protocolos computacionais no mundo criptográfico e aplicá-los especificamente ao aprendizado de máquina para otimizar velocidade e custo, garantindo ao mesmo tempo um nível satisfatório de verificação.
Harry acrescentou que, ao considerar a natureza do que a rede deve fazer, ela precisa ser direcionada a engenheiros e pesquisadores de aprendizado de máquina. Ele precisa ter um componente de verificação, mas o segredo é que ele precisa ser resistente à censura e neutro em termos de hardware em termos de permitir a participação de qualquer pessoa.
Restrições, suposições e execução durante o processo de design
Durante o processo de design da plataforma Gensyn, Ben enfatizou a importância das restrições e suposições do sistema. O seu objetivo é criar uma rede que possa transformar o mundo inteiro num supercomputador de IA e, para isso, precisam de encontrar um equilíbrio entre pressupostos de produto, pressupostos de investigação e pressupostos tecnológicos.
O motivo pelo qual construíram o Gensyn como seu próprio blockchain de primeira camada foi manter maior flexibilidade e liberdade de tomada de decisão em áreas técnicas importantes, como mecanismos de consenso. Eles querem poder preparar seu protocolo para o futuro e não querem impor restrições desnecessárias nos estágios iniciais do projeto. Além disso, acreditam que no futuro as cadeias poderão interagir através de um protocolo de mensagens amplamente aceite, pelo que a sua decisão está alinhada com esta visão.
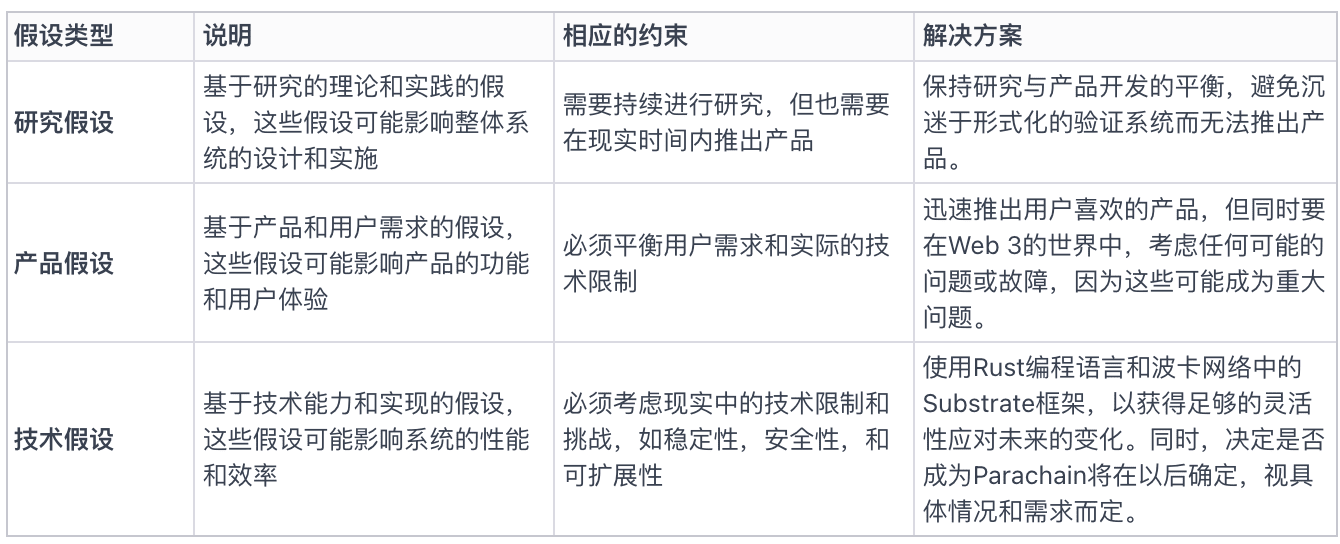
Figura 2: Suposições de produto, suposições de pesquisa e suposições de tecnologia, limitações e execução
Os quatro principais atores da rede fora da cadeia Gensyn
Nesta discussão da economia Gensyn, são introduzidas quatro funções principais: committers, trabalhadores, validadores e denunciantes. Os remetentes podem enviar uma variedade de problemas para a rede Gensyn, incluindo a geração de imagens específicas ou o desenvolvimento de modelos de IA que podem dirigir carros.
O remetente envia a tarefa
Harry explica como usar o Gensyn para treinar modelos. O usuário primeiro define o resultado desejado, como gerar uma imagem com base em um prompt de texto, e então constrói um modelo que recebe o prompt de texto como entrada e gera a imagem correspondente. Os dados de treinamento são essenciais para o aprendizado e melhoria do modelo. Depois de preparar a arquitetura do modelo e os dados de treinamento, os usuários os enviam à rede Gensyn junto com hiperparâmetros, como cronograma de taxa de aprendizagem e duração do treinamento. O resultado desse processo de treinamento é um modelo treinado que os usuários podem hospedar e usar.
Quando questionado sobre como selecionar um modelo não treinado, Harry sugeriu dois métodos.
O primeiro é baseado no conceito de modelo básico atualmente popular, no qual grandes empresas como OpenAI ou Midjourney construirão um modelo básico e, em seguida, os usuários poderão treinar o modelo básico em dados específicos.
A segunda opção é construir o modelo do zero, em oposição à abordagem do modelo básico.
No Gensyn, os desenvolvedores podem enviar várias arquiteturas para treinamento e teste usando métodos semelhantes à otimização evolutiva e otimizar continuamente para construir o modelo desejado.
Ben fornece uma visão aprofundada do modelo subjacente a partir da perspectiva deles, que eles acreditam ser o futuro da área.
Gensyn como protocolo, esperamos que possa ser usado por DApps que implementem técnicas de otimização evolutiva ou métodos semelhantes. Esses DApps podem enviar arquiteturas individuais ao protocolo Gensyn para treinamento e teste e construir o modelo ideal por meio de refinamento iterativo.
O objetivo da Gensyn é fornecer uma base de computação de aprendizado de máquina pura e incentivar o desenvolvimento de um ecossistema em torno dela.
Embora os modelos pré-treinados possam introduzir preconceitos porque as organizações podem utilizar conjuntos de dados proprietários ou reter informações sobre o processo de formação, a solução da Gensyn é abrir o processo de formação em vez de eliminar caixas negras ou confiar no determinismo total. Ao projetar e treinar coletivamente modelos básicos, podemos criar modelos globais que não são influenciados pelo conjunto de dados de nenhuma empresa específica.
Solucionador
Para distribuição de tarefas, uma tarefa corresponde a um servidor. Mas um modelo pode ser dividido em múltiplas tarefas.
Modelos de linguagens grandes são projetados para aproveitar a capacidade máxima de hardware disponível no momento. Este conceito pode ser estendido às redes para considerar a heterogeneidade dos dispositivos.
Para tarefas específicas, como validadores ou trabalhadores, existe a opção de assumir o controle do Mempool. Um trabalhador é selecionado aleatoriamente entre aqueles que expressam vontade de assumir a tarefa. Se o modelo e os dados não puderem ser adaptados a um dispositivo específico, mas o proprietário do dispositivo afirmar que pode, poderão ocorrer multas devido ao congestionamento do sistema.
Se uma tarefa pode ser executada em uma máquina é determinada por uma função aleatória verificável que seleciona um trabalhador de um subconjunto de trabalhadores disponíveis.
Relativamente à questão da verificação das capacidades dos trabalhadores, caso os trabalhadores não possuam as capacidades informáticas reivindicadas, não conseguirão realizar as tarefas informáticas, o que será detectado aquando da apresentação do comprovativo.
No entanto, o tamanho da tarefa é um problema. Se as tarefas forem definidas muito grandes, isso pode levar a problemas no sistema, como ataques de negação de serviço (DoS), em que os trabalhadores afirmam ter concluído a tarefa, mas nunca a concluem, desperdiçando tempo e recursos.
Portanto, a decisão do tamanho da tarefa é crucial e precisa levar em consideração fatores como paralelização e estrutura otimizada da tarefa. Os pesquisadores estão estudando e explorando ativamente os melhores métodos com base em várias restrições.
Uma vez lançada a testnet, também serão consideradas condições práticas para observar como o sistema funciona no mundo real.
Definir o tamanho perfeito da tarefa pode ser desafiador, e a Gensyn está pronta para ajustar e melhorar com base no feedback e na experiência do mundo real.
Mecanismo de verificação e pontos de verificação para cálculos em larga escala na cadeia
Harry e Ben mostraram que verificar a exatidão de um cálculo é um desafio importante porque não é determinístico como uma função hash, portanto não é possível simplesmente verificar por hash se um cálculo foi executado. Para solucionar esse problema, a solução ideal é utilizar a aplicação da prova de conhecimento zero de todo o processo de cálculo. Atualmente, a Gensyn ainda está trabalhando para implementar esse recurso.
Atualmente, Gensyn introduz uma abordagem híbrida usando checkpointing para verificar cálculos de aprendizado de máquina por meio de mecanismos probabilísticos e checkpointing. Ao combinar um esquema de auditoria estocástica com caminhos espaciais gradientes, uma verificação relativamente robusta pode ser estabelecida. Além disso, provas de conhecimento zero são introduzidas para aprimorar o processo de verificação e aplicadas na perda global do modelo.
Verificador e Denunciante
O moderador e Harry discutiram as duas funções adicionais envolvidas no processo de verificação: o verificador e o denunciante. Eles detalham as responsabilidades e funções específicas dessas duas funções.
A tarefa do validador é garantir a exatidão dos pontos de verificação, enquanto a tarefa do denunciante é garantir a precisão com que o validador desempenha as suas funções. Os denunciantes resolvem o problema do dilema do validador, garantindo que o trabalho do validador seja correto e confiável. Os verificadores introduzem erros intencionalmente no seu trabalho e o papel do denunciante é identificar e expor esses erros, garantindo assim a integridade do processo de verificação.
Os verificadores introduzem erros deliberadamente para testar o estado de alerta dos denunciantes e garantir a eficácia do sistema. Caso haja algum erro no trabalho, o validador detecta o erro e notifica o relator. O erro é então registrado na blockchain e verificado na cadeia. Periodicamente, e a taxas relevantes para a segurança do sistema, os validadores introduzem intencionalmente bugs para manter os denunciantes envolvidos. Se os denunciantes encontrarem um problema, eles participarão de um jogo chamado “protocolo pinpoint”, por meio do qual poderão restringir o cálculo a um ponto específico na árvore Merkle de uma região específica da rede neural. Essas informações são então submetidas à arbitragem na rede. Esta é uma versão simplificada do processo para validadores e denunciantes que conduzirão desenvolvimentos e pesquisas adicionais após a rodada inicial.
Rede on-chain Gensyn
Ben e Harry discutiram detalhadamente como o protocolo de coordenação Gensyn funciona na cadeia e os detalhes de implementação. Eles mencionaram primeiro o processo de construção de blocos de rede, que envolve o piqueteamento de tokens como parte dessa rede de piquetagem. Eles então explicam como esses componentes se relacionam com o protocolo Gensyn.
Ben explicou que o protocolo Gensyn é em grande parte um protocolo de rede Polkadot com substrato básico. Eles adotam o mecanismo de consenso do Vovô Babe baseado em prova de aposta, e os validadores operam da maneira usual. No entanto, todos os componentes de aprendizagem automática introduzidos anteriormente ocorrem fora da cadeia, envolvendo vários intervenientes fora da cadeia que executam as suas respetivas tarefas.
Esses participantes são incentivados por piquetagem, seja por meio da seção de piquetagem no Substrato ou pelo envio de um número específico de tokens em um contrato inteligente. Quando seu trabalho for finalmente verificado, eles serão recompensados.
O desafio mencionado por Ben e Harry é garantir um equilíbrio entre o valor da aposta, o valor da possível redução e o valor da recompensa para evitar a criação de incentivos para comportamentos preguiçosos ou maliciosos.
Além disso, discutiram a complexidade que advém da adição de denunciantes, mas a sua presença é fundamental para garantir a honestidade dos verificadores devido às exigências de escalonamento da computação. Enquanto continuam a explorar formas de potencialmente eliminar denunciantes através de tecnologia à prova de conhecimento zero. Afirmaram que o sistema actual corresponde ao descrito no documento, mas estão a trabalhar activamente para simplificar todos os aspectos.
O moderador perguntou se eles tinham algum tipo de solução de disponibilidade de dados e Henry explicou que introduziram uma camada no topo do substrato chamada prova de disponibilidade (POA). Essa camada utiliza tecnologias como codificação de eliminação para lidar com as limitações encontradas no amplo mercado de camadas de armazenamento. Eles disseram que estariam muito interessados em desenvolvedores que já implementaram tal solução.
Ben acrescentou que suas necessidades envolvem não apenas o armazenamento de dados de treinamento, mas também dados de prova intermediários que não requerem armazenamento de longo prazo. Por exemplo, eles podem precisar esperar apenas cerca de 20 segundos quando terminarem de publicar um determinado número de blocos. No entanto, as taxas de armazenamento que pagam atualmente na Arweave cobrem centenas de anos e são desnecessárias para estas necessidades de curto prazo. Eles procuravam uma solução que tivesse as garantias e os recursos do Arweave, ao mesmo tempo que atendesse às suas necessidades de armazenamento de curto prazo a um custo menor.
Token Gensyn e governança
Ben explicou a importância do token gensyn no ecossistema, desempenhando um papel fundamental na aposta, na punição, no fornecimento de recompensas e na manutenção do consenso. Seu principal objetivo é garantir a solidez financeira e a integridade do sistema. Ben também mencionou o uso cuidadoso das taxas de inflação para pagar validadores e o aproveitamento dos mecanismos da teoria dos jogos.
Ele enfatizou o uso puramente técnico do token Gensyn e disse que eles garantirão tecnicamente o momento e a necessidade de introdução do token Gensyn.
Harry disse que eles são minoria na comunidade de aprendizagem profunda, especialmente em meio ao ceticismo generalizado entre os estudiosos de IA em relação às criptomoedas. No entanto, eles percebem o valor dos aspectos técnicos e ideológicos das criptomoedas.
No entanto, quando a rede for lançada, eles esperam que a maioria dos usuários de aprendizagem profunda transacionem principalmente usando moedas fiduciárias, e a conversão em tokens ocorrerá perfeitamente nos bastidores.
Do lado da oferta, os trabalhadores e os committers estarão ativamente envolvidos na negociação de tokens e já estão recebendo interesse dos mineradores Ethereum que possuem recursos significativos de GPU e buscam novas oportunidades.
Aqui, é importante garantir que o medo dos profissionais de aprendizado profundo e de aprendizado de máquina em relação à terminologia de criptomoeda (como tokens) seja removido, dissociando-o da interface da experiência do usuário. Gensyn diz que este é um caso de uso interessante que une os mundos da Web 2 e da Web 3 porque faz sentido do ponto de vista econômico e a tecnologia necessária para apoiar sua existência.
Ciência Popular Inteligência Artificial
IA, aprendizado profundo e aprendizado de máquina
Ben compartilhou suas opiniões sobre o desenvolvimento do campo de IA nos últimos anos. Ele acredita que, embora o campo da IA e do aprendizado de máquina tenha experimentado uma série de pequenas explosões nos últimos sete anos, os avanços atuais parecem estar criando um impacto real e aplicações valiosas que repercutem em um público mais amplo. O aprendizado profundo é um impulsionador fundamental dessas mudanças. As redes neurais profundas demonstraram sua capacidade de superar os benchmarks estabelecidos pelos métodos tradicionais de visão computacional. Além disso, modelos como o GPT-3 aceleraram esse progresso.
Harry explicou ainda as diferenças entre IA, aprendizado de máquina e aprendizado profundo. Ele acredita que esses três termos são frequentemente usados de forma intercambiável, mas apresentam diferenças significativas. Ele disse metaforicamente que a IA, o aprendizado de máquina e o aprendizado profundo são como bonecas matryoshka russas, com a IA sendo a camada mais externa.
Em termos gerais, IA refere-se à programação de máquinas para executar tarefas.
O aprendizado de máquina, que se tornou popular na década de 1990 e no início de 2000, utiliza dados para determinar a probabilidade de decisões, em vez de depender de sistemas especialistas com regras do tipo "se-então".
O aprendizado profundo baseia-se no aprendizado de máquina, mas permite modelos mais complexos.
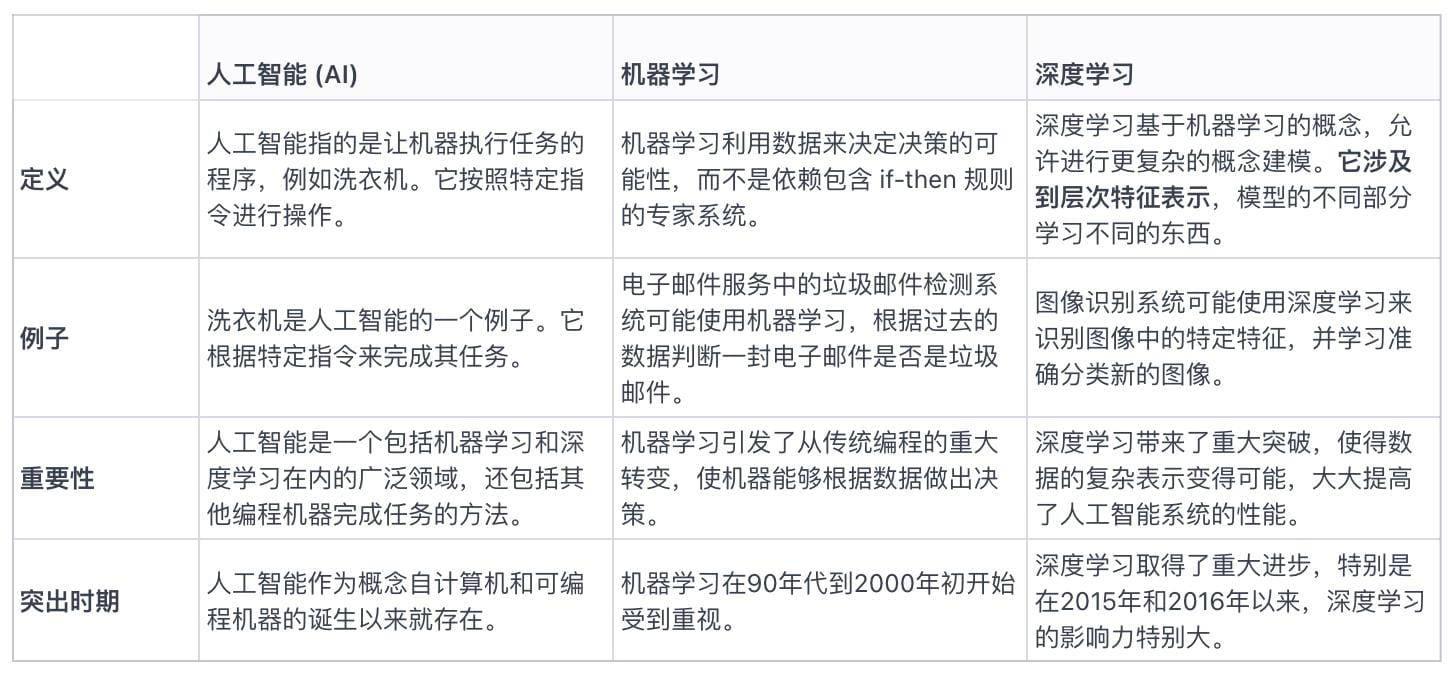
Figura 3: A diferença entre inteligência artificial, aprendizado de máquina e aprendizado profundo
Inteligência artificial estreita, inteligência artificial geral, superinteligência artificial
Neste segmento, anfitriões e convidados fornecem uma visão aprofundada de três áreas principais da inteligência artificial: inteligência artificial estreita (ANI), inteligência artificial geral (AGI) e superinteligência artificial (ASI).
Inteligência Artificial Narrow (ANI): A IA atual está principalmente nesta fase, onde as máquinas são muito boas na execução de tarefas específicas, como a detecção de tipos específicos de cancro a partir de exames médicos através do reconhecimento de padrões.
Inteligência Geral Artificial (AGI): AGI refere-se à capacidade das máquinas de executar tarefas que são relativamente simples para os humanos, mas que são muito desafiadoras quando refletidas em sistemas de computação. Por exemplo, permitir que uma máquina navegue suavemente em um ambiente lotado enquanto faz suposições discretas sobre todas as entradas ao redor é um exemplo de AGI. AGI refere-se à capacidade de um modelo ou sistema de realizar tarefas cotidianas como um ser humano.
Superinteligência Artificial (ASI): Depois de atingir a inteligência artificial geral, as máquinas podem evoluir para uma superinteligência artificial. Isto se refere à capacidade das máquinas de superar as capacidades humanas devido à complexidade de seus modelos, ao aumento do poder de computação, à vida útil ilimitada e à memória perfeita. Este conceito é frequentemente explorado em filmes de ficção científica e terror.
Além disso, os convidados também mencionaram que a integração do cérebro humano e das máquinas, por exemplo, através de interfaces cérebro-computador, pode ser uma forma de alcançar a AGI, mas isto também levanta uma série de questões morais e éticas.
Desbloqueando a caixa preta do aprendizado profundo: determinístico versus probabilístico
Ben explica que a natureza de caixa preta dos modelos de aprendizagem profunda se deve ao seu tamanho. Você ainda está traçando um caminho através de uma série de pontos de decisão na rede. No entanto, esse caminho é muito grande e é difícil conectar os pesos ou parâmetros dentro do modelo aos seus valores específicos, porque esses valores são derivados após a entrada de milhões de amostras. Você pode fazer isso com certeza e acompanhar cada atualização, mas a quantidade de dados que você acabará gerando será muito grande.
Ele viu duas coisas acontecendo:
À medida que entendemos cada vez mais sobre os modelos que construímos, a natureza da caixa preta está desaparecendo gradualmente. A aprendizagem profunda é um campo de pesquisa que passou por um período interessante e rápido, com muitos experimentos que não foram orientados pelos fundamentos da pesquisa. É mais uma questão de ver o que podemos tirar disso. Então, lançamos mais dados nele, experimentamos novas arquiteturas e apenas vemos o que acontece, em vez de partirmos dos princípios básicos, projetarmos essa coisa e sabermos exatamente como ela funciona. Então houve um período emocionante em que tudo era uma caixa preta. Mas ele acha que esse rápido crescimento está começando a desacelerar, e estamos vendo pessoas revisitando essas arquiteturas e examinando e dizendo: "Por que isso funciona tão bem? Vamos investigar e provar isso, de certa forma, esta cortina." está sendo levantado.
Outra coisa que aconteceu, talvez de forma mais controversa, foi uma mudança de visão sobre se os sistemas computacionais precisam ser completamente determinísticos ou se podemos viver num mundo probabilístico. Nós, como humanos, vivemos em um mundo probabilístico. O exemplo do carro autônomo pode ser mais claro. Quando dirigimos, aceitamos que eventos aleatórios acontecerão, podem ocorrer pequenos acidentes e podem haver problemas com o sistema do carro autônomo. Mas não podemos aceitar isto de forma alguma e dizemos que este deve ser um processo completamente determinista. Um dos desafios da indústria automóvel autónoma é que assumem que as pessoas aceitarão os mecanismos probabilísticos que se aplicam aos automóveis autónomos, mas na verdade as pessoas não o fazem. Ele acha que isso vai mudar, e pode ser controverso se nós, como sociedade, permitiremos que sistemas de computação probabilísticos coexistam conosco. Ele não tem certeza se o caminho será tranquilo, mas acha que isso vai acontecer.
Método de otimização de gradiente: o principal método de otimização de aprendizado profundo
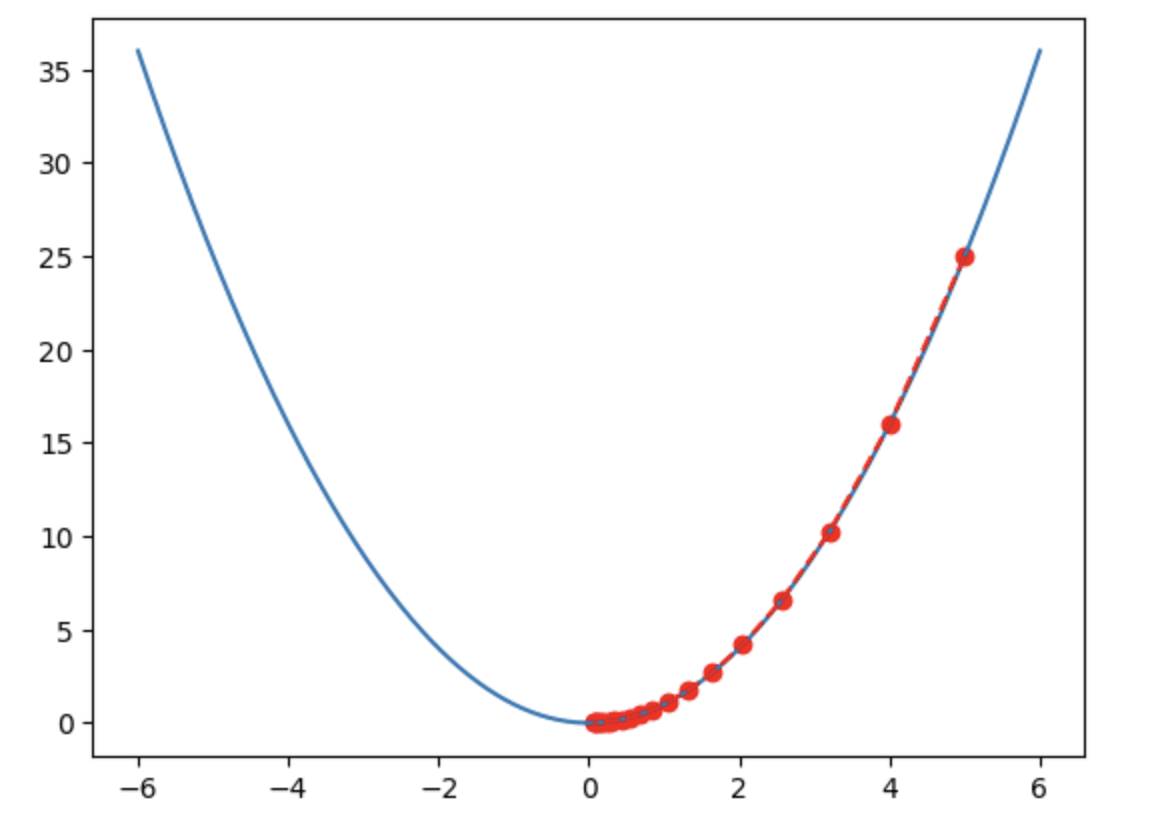
A otimização de gradiente é um dos principais métodos de aprendizagem profunda, que desempenha um papel fundamental no treinamento de redes neurais. Nas redes neurais, uma série de parâmetros de camada são essencialmente números reais. O treinamento da rede envolve definir esses parâmetros para valores realistas que permitem que os dados sejam transmitidos corretamente e acionem a saída desejada nos estágios finais da rede.
Os métodos de otimização baseados em gradiente trouxeram mudanças tremendas nas áreas de redes neurais e aprendizado profundo. Este método utiliza gradientes, que são a diferenciação dos parâmetros de cada camada da rede em relação ao erro. Ao aplicar a regra da cadeia, os gradientes podem ser retropropagados por toda a rede hierárquica. Neste processo, você pode determinar onde está na superfície de erro. O erro pode ser modelado como uma superfície no espaço euclidiano, que aparece como uma região cheia de altos e baixos. O objetivo da otimização é encontrar a área que minimiza o erro.
O gradiente mostra para cada camada onde você está na superfície e a direção na qual você deve atualizar os parâmetros. Você pode usar gradientes para navegar nesta superfície ondulada e encontrar direções que reduzam erros. O tamanho do degrau depende da inclinação da superfície. Se for íngreme, você pulará mais longe; se não for íngreme, você pulará menor. Essencialmente, você está apenas navegando pela superfície, procurando uma ranhura, e o gradiente ajuda a determinar a posição e a direção.
Este método é um grande avanço porque os gradientes fornecem um sinal claro e uma direção útil que pode guiá-lo de forma mais eficaz para onde você está na superfície e onde está do que fazer saltos aleatórios no espaço de parâmetros, ainda está no topo da montanha. em ravinas ou em áreas planas.
Embora existam muitas técnicas de aprendizagem profunda para resolver o problema de encontrar soluções ótimas, a situação no mundo real é muitas vezes mais complexa. Existem muitas técnicas de regularização usadas no treinamento de aprendizagem profunda, tornando-o mais uma arte do que uma ciência. E é por isso que a otimização baseada em gradiente é mais uma arte do que uma ciência exata quando aplicada na vida real.
Resumir
O objetivo da Gensyn é construir o maior sistema de recursos computacionais de aprendizado de máquina do mundo, que possa aproveitar ao máximo recursos computacionais ociosos ou subutilizados, como smartphones pessoais, computadores e outros dispositivos.
No contexto do aprendizado de máquina e do blockchain, os registros mantidos pelo livro razão são geralmente os resultados de cálculos, ou seja, o estado dos dados que processamos por meio do aprendizado de máquina. Esse status pode ser: "Aprendi automaticamente esta onda de dados, ela é válida e ocorreu em X ano e X mês." O objetivo principal deste registro é expressar o status resultante, em vez de detalhar o processo de cálculo.
Nesta estrutura, o blockchain desempenha um papel importante:
Blockchain fornece uma maneira de registrar os resultados do status dos dados. Ele foi projetado para garantir a autenticidade dos dados e evitar adulterações e repúdio.
Existe um mecanismo de incentivo econômico dentro do blockchain, por meio do qual podem ser coordenados os comportamentos de diferentes papéis na rede computacional, como os quatro papéis mencionados: remetente, trabalhador, verificador e denunciante.
Através de uma pesquisa sobre o mercado atual de computação em nuvem, descobrimos que a computação em nuvem não é totalmente indesejável, mas que vários métodos de computação têm seus próprios problemas específicos. O método de computação descentralizada do blockchain pode desempenhar um papel em alguns cenários, mas não pode substituir completamente a computação em nuvem tradicional. Em outras palavras, o blockchain não é uma solução panacéia.
Finalmente, a IA pode ser considerada uma espécie de produtividade. No entanto, a forma de organizar e treinar eficazmente a IA pertence à categoria das relações de produção. Isso inclui fatores como colaboração, crowdsourcing e incentivos. Neste sentido, a Web 3.0 oferece um grande número de soluções e cenários possíveis.
Portanto, podemos entender que a combinação de blockchain e IA, especialmente em termos de compartilhamento de dados e modelos, coordenação de recursos computacionais e verificação de resultados, fornece novas soluções para alguns problemas na possibilidade de treinamento e uso de IA.
Citar
1. https://docs.gensyn.ai/litepaper/
2. https://a16zcrypto.com/posts/announcement/investing-in-gensyn/