


Obrigado a Brian Retford, SunYi, Jason Morton, Shumo, Feng Boyuan, Daniel, Aaron Greenblatt, Nick Matthew, Baz, Marcin e Brent por seus valiosos insights, comentários e análises deste artigo.
Autor: Grace&Hill
Para nós, entusiastas da criptografia, a inteligência artificial está na moda há algum tempo. Curiosamente, ninguém quer ver a IA enlouquecida. A intenção original da invenção do blockchain é evitar que o dólar fique fora de controle, para que possamos tentar evitar que a inteligência artificial fique fora de controle. Além disso, agora temos uma nova tecnologia chamada provas de conhecimento zero para garantir que as coisas não possam dar errado. No entanto, para dominar a fera que é a IA, devemos compreender como ela funciona.
Uma breve introdução ao aprendizado de máquina
A inteligência artificial passou por diversas mudanças de nome, de “sistemas especialistas” para “redes neurais”, depois para “modelos gráficos” e finalmente para “aprendizado de máquina”. Todos estes são subconjuntos de “inteligência artificial” que recebem nomes diferentes e que a nossa compreensão da IA continua a crescer. Vamos nos aprofundar um pouco mais no aprendizado de máquina e desmistificá-lo.
Observação: hoje, a maioria dos modelos de aprendizado de máquina são redes neurais devido ao seu desempenho superior em muitas tarefas. Referimo-nos principalmente ao aprendizado de máquina como aprendizado de máquina de rede neural.
Como funciona o aprendizado de máquina?
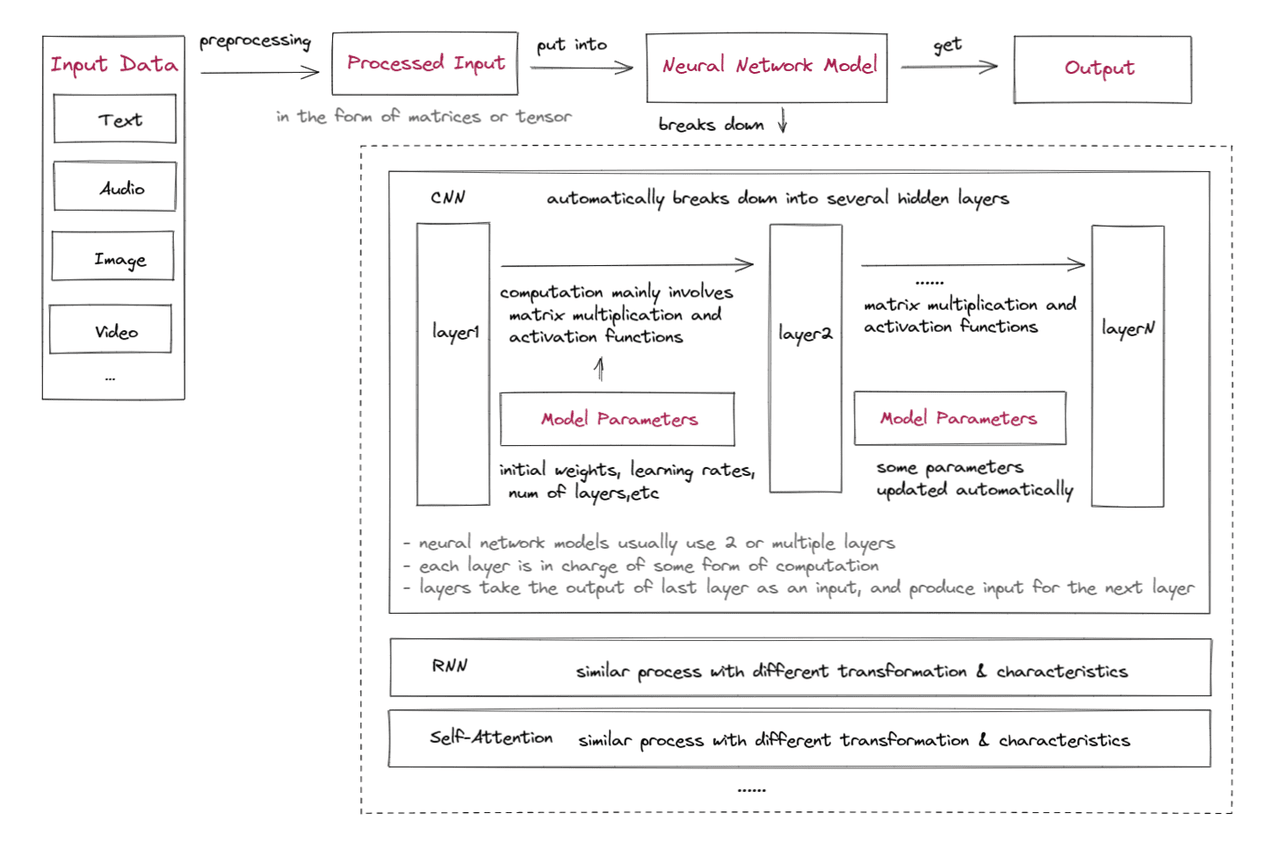 Primeiro, vamos dar uma olhada rápida no funcionamento interno do aprendizado de máquina:
Pré-processamento de dados de entrada: Os dados de entrada precisam ser processados em um formato que possa ser usado como entrada do modelo. Isso geralmente envolve pré-processamento e engenharia de recursos para extrair informações úteis e converter os dados em um formato adequado, como matrizes de entrada ou tensores (matrizes de alta dimensão). Esta é a abordagem do sistema especialista. Com o advento do aprendizado profundo, a camada de processamento lida automaticamente com o pré-processamento.
Definir parâmetros iniciais do modelo: Os parâmetros iniciais do modelo incluem múltiplas camadas, funções de ativação, pesos iniciais, vieses, taxas de aprendizagem, etc. Alguns parâmetros podem ser ajustados por algoritmos de otimização durante o treinamento para melhorar a precisão do modelo.
Dados de treinamento:
Os dados de entrada são alimentados em uma rede neural, normalmente começando com uma ou mais camadas de extração de recursos e modelagem de relacionamento, como camadas convolucionais (CNN), camadas recorrentes (RNN) ou camadas de autoatenção. Essas camadas aprendem a extrair recursos relevantes dos dados de entrada e modelar os relacionamentos entre esses recursos.
As saídas dessas camadas são então passadas para uma ou mais camadas adicionais, que realizam diferentes cálculos e transformações nos dados de entrada. Essas camadas geralmente envolvem principalmente a multiplicação de matrizes de pesos que podem ser aprendidas e a aplicação de funções de ativação não lineares, mas também podem incluir outras operações, como convolução e agrupamento em redes neurais convolucionais ou iteração em redes neurais recorrentes. A saída dessas camadas serve como entrada para a próxima camada do modelo ou como saída final prevista.
Obtenha a saída do modelo: A saída calculada por uma rede neural é geralmente um vetor ou matriz que representa a probabilidade de classificação da imagem, pontuação de análise de sentimento ou outros resultados, dependendo da aplicação da rede. Geralmente também existe um módulo de avaliação de erros e atualização de parâmetros que atualiza automaticamente os parâmetros de acordo com a finalidade do modelo.
A saída de um cálculo de rede neural é geralmente um vetor ou matriz que representa a probabilidade de classificação da imagem, uma pontuação de análise de sentimento ou outros resultados, dependendo da aplicação da rede. Geralmente também existe um módulo de avaliação de erros e atualização de parâmetros que atualiza automaticamente os parâmetros de acordo com a finalidade do modelo. Se a explicação acima parecer muito obscura, aqui está um exemplo de uso de um modelo CNN para identificar imagens de maçãs.
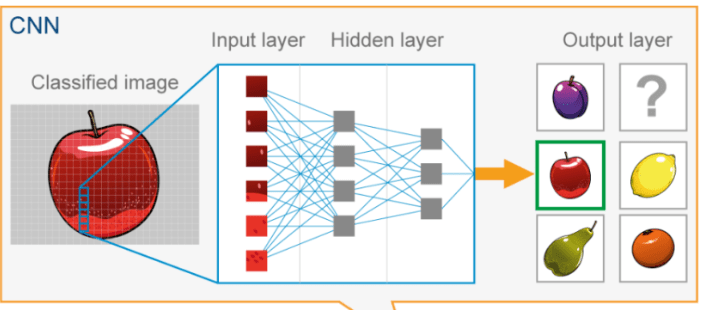
Carregue a imagem no modelo como uma matriz de valores de pixel. Esta matriz pode ser representada como um tensor 3D com dimensões (altura, largura, canais).
Defina os parâmetros iniciais do modelo CNN.
A imagem de entrada passa por múltiplas camadas ocultas em uma CNN, com cada camada aplicando um filtro convolucional para extrair características cada vez mais complexas da imagem. A saída de cada camada é passada por uma função de ativação não linear e então agrupada para reduzir a dimensionalidade do mapa de características. A última camada geralmente é uma camada totalmente conectada que gera previsões de saída com base nos recursos extraídos.
O resultado final da CNN é a categoria com maior probabilidade. Este é o rótulo previsto da imagem de entrada.
Uma estrutura de confiança para aprendizado de máquina
Podemos resumir o que foi dito acima em uma estrutura de confiança de aprendizado de máquina, incluindo quatro camadas básicas de aprendizado de máquina. Todo o processo de aprendizado de máquina exige que essas camadas sejam confiáveis para serem confiáveis:
Entrada: Os dados brutos precisam ser pré-processados e às vezes mantidos em segredo.
Integridade: os dados de entrada não foram adulterados, não foram contaminados por entradas maliciosas e foram pré-processados corretamente.
Privacidade: Os dados inseridos não serão divulgados se necessário.
Saída: Precisa ser gerado e transmitido com precisão
Integralidade: a saída é gerada corretamente.
Privacidade: a saída não será divulgada se necessário.
Tipo/algoritmo de modelo: o modelo deve calcular corretamente
Completude: o modelo funciona corretamente.
Privacidade: O modelo em si ou os cálculos não serão divulgados se necessário.
Diferentes modelos de redes neurais possuem diferentes algoritmos e camadas adequadas para diferentes casos de uso e entradas.
Redes neurais convolucionais (CNNs) são comumente usadas para tarefas que envolvem dados semelhantes a grades, como imagens, onde padrões e recursos locais podem ser capturados aplicando operações de convolução a pequenas regiões de entrada.
As redes neurais recorrentes (RNN), por outro lado, são adequadas para dados sequenciais, como séries temporais ou linguagem natural, onde estados ocultos podem capturar informações de etapas de tempo anteriores e modelar dependências temporais.
As camadas de autoatenção são úteis para capturar relacionamentos entre elementos em uma sequência de entrada, tornando-as eficazes para tarefas como tradução automática ou resumo, onde dependências de longo alcance são cruciais.
Também existem outros tipos de modelos, incluindo perceptrons multicamadas (MLPs) e outros.
Parâmetros do modelo: Em alguns casos, os parâmetros devem ser transparentes ou gerados democraticamente, mas em todos os casos não suscetíveis de adulteração. Integridade: Os parâmetros são gerados, mantidos e gerenciados da maneira correta. Privacidade: os proprietários do modelo muitas vezes mantêm os parâmetros do modelo de machine learning em segredo para proteger a propriedade intelectual e a vantagem competitiva da organização que desenvolveu o modelo. Esse fenômeno só era comum até que os modelos de transformadores se tornassem extremamente caros para treinar, mas ainda é um grande problema para a indústria.
A questão da confiança no aprendizado de máquina
Com o crescimento explosivo das aplicações de aprendizagem automática (ML) (CAGR superior a 20%) e a sua crescente integração na vida quotidiana, como a recente popularidade do ChatGPT, a questão da confiança no ML está a tornar-se cada vez mais crítica e não pode ser ignorada. Portanto, é fundamental identificar e resolver estas questões de confiança para garantir o uso responsável da IA e prevenir o seu potencial uso indevido. Porém, quais são os problemas? Vamos dar uma olhada mais de perto.
Transparência ou comprovabilidade insuficiente
Os problemas de confiança há muito atormentam o aprendizado de máquina por dois motivos principais:
Natureza de privacidade: conforme mencionado acima, os parâmetros do modelo são frequentemente privados e, em alguns casos, as entradas do modelo também precisam ser mantidas privadas, o que naturalmente cria alguns problemas de confiança entre proprietários e usuários do modelo.
Caixas pretas algorítmicas: Os modelos de aprendizado de máquina são às vezes chamados de “caixas pretas” porque envolvem muitas etapas automatizadas em seus cálculos que são difíceis de entender ou explicar. Estas etapas envolvem algoritmos complexos e grandes quantidades de dados, resultando em resultados incertos e por vezes aleatórios, tornando os algoritmos vulneráveis a acusações de preconceito ou mesmo de discriminação.
Antes de prosseguir, uma das maiores suposições deste artigo é que o modelo está “pronto para uso”, o que significa que está bem treinado e adequado ao propósito. Os modelos podem não funcionar em todas as situações e os modelos melhoram a um ritmo alarmante. A vida útil normal de um modelo de aprendizagem automática é entre 2 e 18 meses, dependendo do cenário da aplicação.
Uma análise detalhada dos problemas de confiança no aprendizado de máquina
Existem alguns problemas de confiança no processo de treinamento do modelo, e Gensyn está atualmente trabalhando na geração de provas válidas para facilitar esse processo. No entanto, este artigo concentra-se principalmente no processo de inferência de modelos. Vamos agora usar quatro blocos de construção de aprendizado de máquina para descobrir possíveis problemas de confiança:
digitar:
As fontes de dados são à prova de falsificação
Os dados de entrada privados não são roubados pelos operadores do modelo (questão de privacidade)
Modelo:
O modelo em si é tão preciso quanto anunciado
O processo de cálculo foi concluído corretamente
parâmetro:
Os parâmetros do modelo não foram alterados ou estão conforme anunciado
Durante o processo, os parâmetros do modelo que têm valor para o proprietário do modelo não são vazados (questão de privacidade)
Resultado: O resultado está comprovadamente correto (pode melhorar à medida que todos os elementos acima são melhorados)
Como aplicar ZK em uma estrutura de confiança de aprendizado de máquina
Alguns dos problemas de confiança acima podem ser resolvidos através do upload de entradas e parâmetros de aprendizado de máquina para a cadeia e do cálculo de modelos na cadeia, o que pode garantir a exatidão das entradas, parâmetros e cálculos do modelo. Mas esta abordagem pode sacrificar a escalabilidade e a privacidade. Giza está fazendo esse trabalho no Starknet, mas devido a questões de custo, ele suporta apenas modelos simples de aprendizado de máquina, como regressão, não redes neurais. A tecnologia ZK pode resolver os problemas de confiança acima de forma mais eficaz. Atualmente, o ZK do ZKML geralmente se refere a zkSNARK. Primeiro, vamos revisar rapidamente alguns conceitos básicos do zkSNARK:
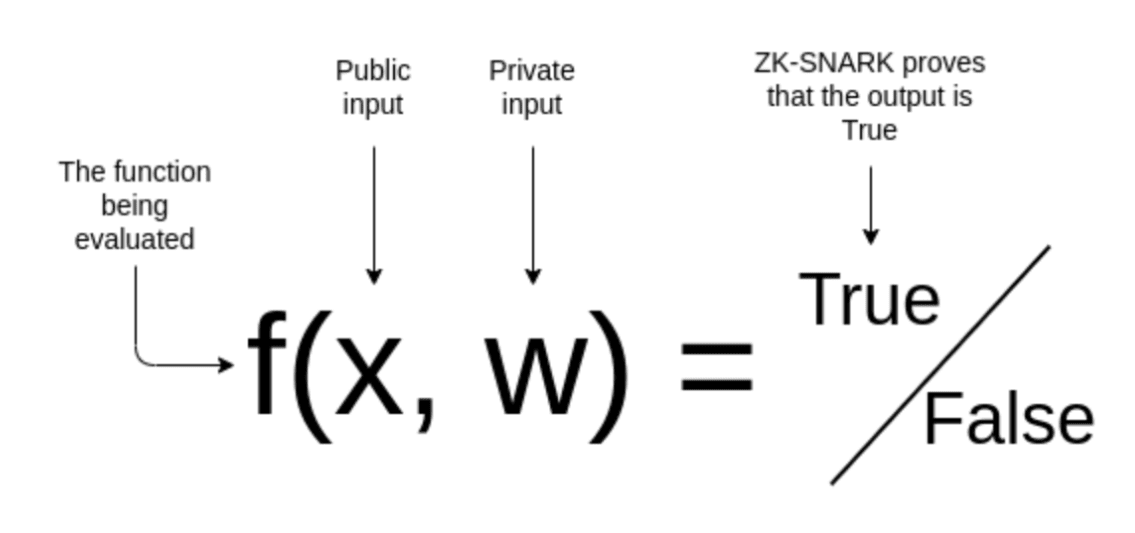
Uma prova zkSNARK é a prova de que conheço alguma entrada secreta w tal que é verdade que o resultado deste cálculo f é OUT, sem dizer o que w é. O processo de geração de provas pode ser resumido nas seguintes etapas:
Formule a afirmação a ser provada: f(x,w)=true
"Classifiquei corretamente esta imagem x usando um modelo de aprendizado de máquina f com parâmetros privados w."
Converter instruções em circuitos (aritmetização): Diferentes métodos de construção de circuitos incluem R1CS, QAP, Plonkish, etc.
Comparado a outros casos de uso, o ZKML requer uma etapa extra chamada quantização. A inferência de redes neurais normalmente é feita usando aritmética de ponto flutuante, que é muito cara para emular no domínio principal dos circuitos aritméticos. Diferentes métodos de quantificação proporcionam um compromisso entre a precisão e os requisitos do equipamento.
Alguns métodos de construção de circuitos como o R1CS não são eficientes para redes neurais. Esta parte pode ser ajustada para melhorar o desempenho.
Gere uma chave de certificação e uma chave de verificação
Crie uma testemunha: quando w=w*, f(x,w)=true
Crie um compromisso de hash: A testemunha w* se compromete a gerar um valor de hash usando uma função hash criptográfica. Este hash pode ser tornado público.
Isto ajuda a garantir que as entradas privadas ou os parâmetros do modelo não foram adulterados ou modificados durante os cálculos. Esta etapa é crucial porque mesmo pequenas modificações podem ter um impacto significativo no comportamento e na saída do modelo.
Geração de provas: Diferentes sistemas de provas usam diferentes algoritmos de geração de provas.
Regras especiais de conhecimento zero precisam ser projetadas para operações de aprendizado de máquina, como multiplicação de matrizes e camadas convolucionais, a fim de implementar protocolos sublineares com eficiência de tempo para esses cálculos.
✓ Sistemas zkSNARK genéricos como groth16 podem não ser capazes de lidar com redes neurais de forma eficiente devido à carga computacional excessiva.
✓ Desde 2020, muitos novos sistemas de prova ZK surgiram para otimizar a prova ZK para o processo de inferência de modelo, incluindo vCNN, ZEN, ZKCNN e pvCNN. No entanto, a maioria deles é otimizada para modelos CNN. Eles só podem ser aplicados a alguns conjuntos de dados importantes, como MNIST ou CIFAR-10.
✓ Em 2022, Daniel Kang Tatsunori Hashimoto, Ion Stoica e Yi Sun (fundadores da Axiom) propuseram um novo esquema de prova baseado em Halo 2, alcançando pela primeira vez a geração de prova ZK para o conjunto de dados ImageNet. Sua otimização concentra-se na parte aritmética, com novos parâmetros de pesquisa para não linearidade e reutilização de subcircuitos entre camadas.
✓Modulus Labs está comparando diferentes sistemas de prova para raciocínio on-chain e descobriu que em termos de tempo de prova, ZKCNN e plonky2 apresentam melhor desempenho em termos de uso máximo de memória do provador, ZKCNN e halo2 apresentam bom desempenho, mas consumo de memória; é sacrificado e o ZKCNN só funciona em modelos CNN. Também está desenvolvendo um novo sistema zkSNARK projetado especificamente para ZKML, bem como uma nova máquina virtual.
Prova de Verificação: O verificador usa a chave de verificação para verificar sem o conhecimento da testemunha.
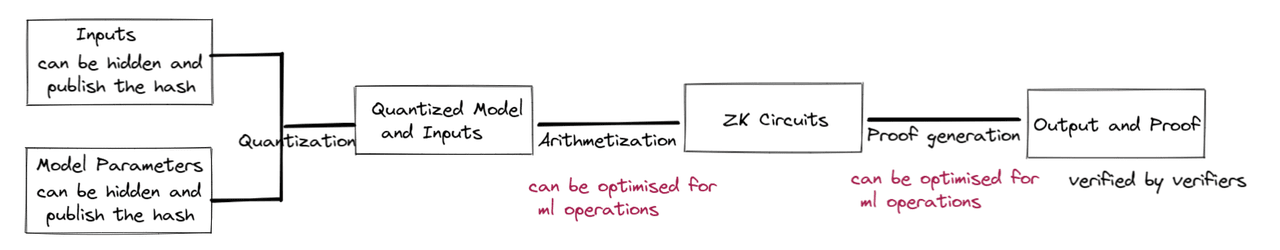
Portanto, podemos mostrar que a aplicação de técnicas de conhecimento zero a modelos de aprendizado de máquina pode resolver muitos problemas de confiança. Técnicas semelhantes que utilizam verificação interativa podem alcançar resultados semelhantes, mas exigirão mais recursos do lado do verificador e poderão enfrentar mais problemas de privacidade. É importante notar que, dependendo do modelo específico, gerar provas para eles pode levar tempo e recursos, portanto, haverá compensações ao aplicar essa tecnologia em casos de uso do mundo real.
Status atual das soluções atuais
A seguir, quais são as soluções existentes? Observe que um provedor de modelo pode ter vários motivos para não querer gerar provas ZKML. Para aqueles que são corajosos o suficiente para experimentar o ZKML e a solução faz sentido, eles podem escolher entre algumas soluções diferentes dependendo do modelo e de onde estão as entradas:
Se os dados de entrada estiverem on-chain, considere usar Axiom como solução:
A Axiom está construindo um coprocessador de conhecimento zero para Ethereum para melhorar o acesso do usuário aos dados do blockchain e fornecer uma visão digital mais complexa dos dados na cadeia. São possíveis cálculos confiáveis de aprendizado de máquina em dados on-chain:
Primeiro, a Axiom importa dados on-chain armazenando a raiz Merkle do hash do bloco Ethereum em seu contrato inteligente AxiomV0, que é verificado sem confiança por meio do processo de verificação ZK-SNARK. O contrato AxiomV0StoragePf permite então a verificação em lote de provas históricas arbitrárias de armazenamento Ethereum em relação a uma raiz de confiança fornecida por hashes de bloco armazenados em cache no AxiomV0.
Em seguida, os dados de entrada do aprendizado de máquina podem ser extraídos dos dados históricos importados.
A Axiom pode então aplicar operações comprovadas de aprendizado de máquina usando halo2 otimizado como backend para validar a eficácia de cada parte computacional;
Finalmente, o Axiom anexará a prova zk para cada resultado da consulta e o contrato inteligente Axiom verificará a prova zk. Qualquer interessado que queira comprovar pode acessá-lo a partir do contrato inteligente.
Se você colocar seu modelo on-chain, considere usar RISCZero como solução:
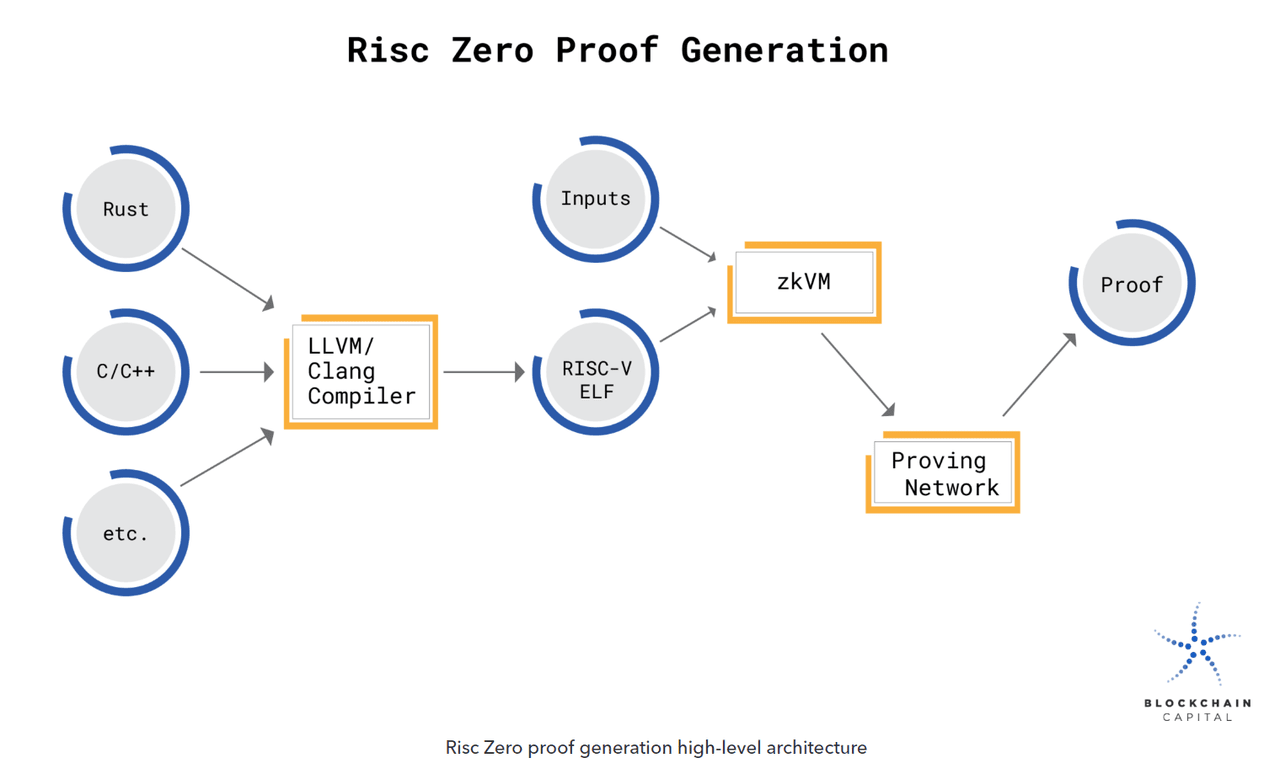
Primeiro, o código-fonte do modelo precisa ser compilado em um binário RISC-V. Quando este binário é executado no ZKVM, a saída é emparelhada com um recibo computado contendo um selo criptográfico. Este selo serve como um argumento de conhecimento zero para integridade computacional, associando um imageID criptografado (identificando o binário RISC-V em execução) com a saída do código declarado para verificação rápida por terceiros.
Quando um modelo é executado no ZKVM, os cálculos sobre mudanças de estado são feitos inteiramente dentro da VM. Não vaza nenhuma informação sobre o estado interno do modelo para o mundo exterior.
Uma vez executado o modelo, o selo resultante torna-se uma prova de conhecimento zero de integridade computacional. RISC ZeroZKVM é uma máquina virtual RISC-V que pode gerar provas de conhecimento zero do código que executa. Utilizando o ZKVM, é possível gerar um recibo criptográfico que qualquer pessoa pode verificar se foi gerado pelo código do cliente do ZKVM. Quando um recibo é emitido, nenhuma outra informação sobre a execução do código (como a entrada fornecida) é revelada.
Ao executar um modelo de aprendizado de máquina no ZKVM do RISC Zero, você pode provar que os cálculos exatos envolvidos no modelo foram realizados corretamente. O processo de cálculo e verificação pode ser feito offline no ambiente preferido do usuário, ou na Bonsai Network, um roll-up de uso geral.
O processo específico de geração de provas ZK envolve um protocolo interativo com um oráculo aleatório como verificador. O selo num recibo RISC Zero é essencialmente um registo deste acordo de interação.
Se você deseja importar modelos diretamente de softwares populares de aprendizado de máquina, como Tensorflow ou Pytorch, considere usar ezkl como solução:
Primeiro, exporte o modelo final como um arquivo .onnx e algumas entradas de amostra como um arquivo .json.
Em seguida, aponte ezkl para os arquivos .onnx e .json para gerar circuitos ZK-SNARK que possam provar declarações ZKML.
Ezkl é uma biblioteca e ferramenta de linha de comando para inferência de modelos de aprendizado profundo e outros gráficos computacionais em zkSNARK.
Parece simples, certo? O objetivo do Ezkl é fornecer uma camada de abstração que permita que operações de alto nível sejam chamadas e dispostas em circuitos Halo 2. Ezkl elimina muita complexidade enquanto mantém uma flexibilidade incrível. Seu modelo quantizado possui um fator de escala quantizado automaticamente. Eles oferecem flexibilidade na mudança para outros sistemas de prova envolvidos em novas soluções. Eles também oferecem suporte a vários tipos de máquinas virtuais, incluindo EVM e WASM.
Em relação ao sistema de provas, ezkl adapta o circuito halo2 agregando provas (convertendo provas difíceis de verificar em provas fáceis de verificar através de intermediários) e recursão (pode resolver problemas de memória, mas é difícil de adaptar ao halo2). Ezkl também otimiza todo o processo por meio de fusão e abstração que pode reduzir a sobrecarga por meio de provas avançadas.
É importante notar que, em comparação com outros projetos zkml gerais, o Accessor Labs se concentra em fornecer ferramentas zkml especialmente projetadas para jogos totalmente on-chain, que podem envolver NPCs de IA, atualizações automáticas de jogabilidade, interfaces de jogos envolvendo linguagem natural, etc.
onde estão os casos de uso
Resolver o problema de confiança com o aprendizado de máquina por meio da tecnologia ZK significa que agora ele pode ser aplicado a mais casos de uso de “alto risco” e “alta certeza” do que apenas acompanhar as conversas das pessoas ou combinar fotos de gatos com fotos de cachorros diferenciados. A Web3 já está explorando muitos desses casos de uso. Isso não é coincidência, já que a maioria dos aplicativos Web3 são executados ou devem ser executados em blockchains, pois os blockchains têm propriedades específicas para operar com segurança, são difíceis de adulterar e possuem cálculos determinísticos. Uma IA comprovadamente bem comportada deve ser aquela que pode operar em um ambiente descentralizado e sem confiança, certo?
Casos de uso onde ZK+ML pode ser aplicado em Web3
Muitos aplicativos Web3 sacrificam a experiência do usuário em prol da segurança e da descentralização porque essa é claramente sua prioridade e existem limitações de infraestrutura. AI/ML tem o potencial de enriquecer as experiências do usuário, o que é sem dúvida útil, mas antes parecia impossível sem concessões. Agora, graças ao ZK, podemos ver confortavelmente AI/ML combinado com aplicativos Web3 sem sacrificar muito em termos de segurança e descentralização.
Essencialmente, este será um aplicativo Web3 (que pode ou não existir no momento da redação deste artigo) que implementa ML/IA de maneira não confiável. Por confiável, queremos dizer se ele é executado em um ambiente/plataforma confiável ou se sua operação pode ser comprovadamente verificável. Observe que nem todos os casos de uso de ML/IA (mesmo em Web3) exigem ou preferem ser executados sem confiança. Analisaremos cada parte dos recursos de ML usados em vários domínios Web3. Em seguida, identificaremos as peças que exigem ZKML, normalmente peças de alto valor onde as pessoas estão dispostas a pagar mais pela prova. A maioria dos casos de uso/aplicativos mencionados abaixo ainda está em fase de pesquisa experimental. Portanto, ainda estão longe da adoção prática. Discutiremos o porquê mais tarde.
Definição
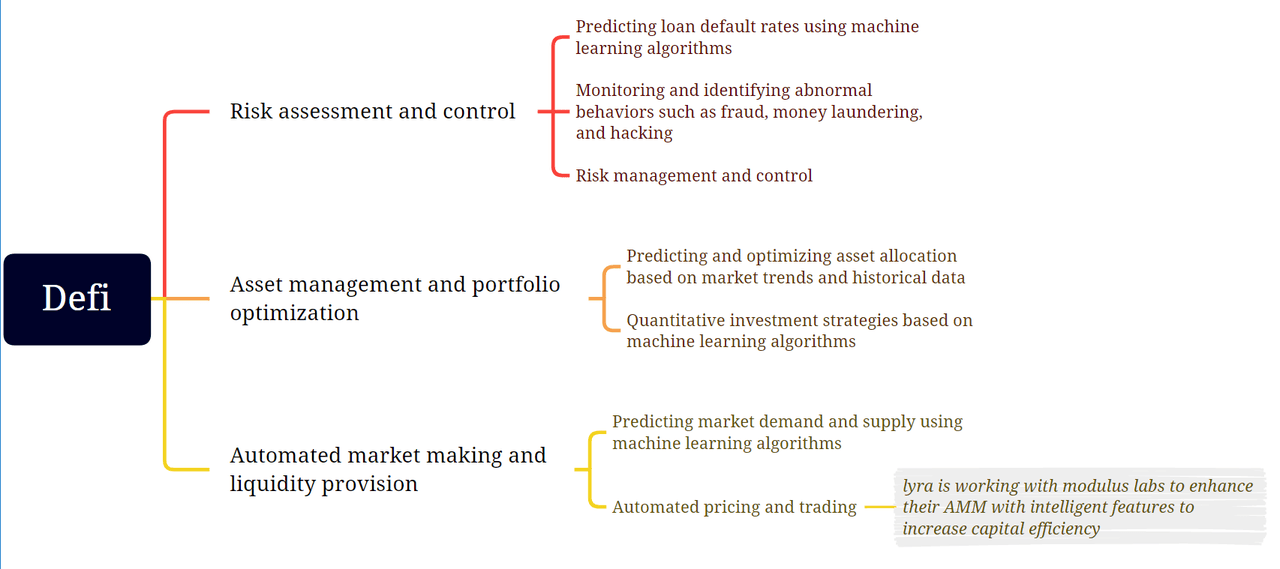
Defi é uma das poucas provas de adequação do produto ao mercado entre protocolos blockchain e aplicações Web3. A capacidade de criar, armazenar e gerir riqueza e capital sem permissão não tem precedentes na história da humanidade. Identificamos vários casos de uso que exigem que os modelos de IA/ML sejam executados sem permissão para garantir segurança e descentralização.
Avaliação de risco: As finanças modernas exigem modelos de IA/ML para uma variedade de avaliações de risco, desde a prevenção de fraude e lavagem de dinheiro até a emissão de empréstimos sem garantia. Garantir que tais modelos de IA/ML operem de maneira verificável significa que podemos evitar que sejam manipulados para permitir a censura que impediria o uso da natureza sem permissão dos produtos Defi.
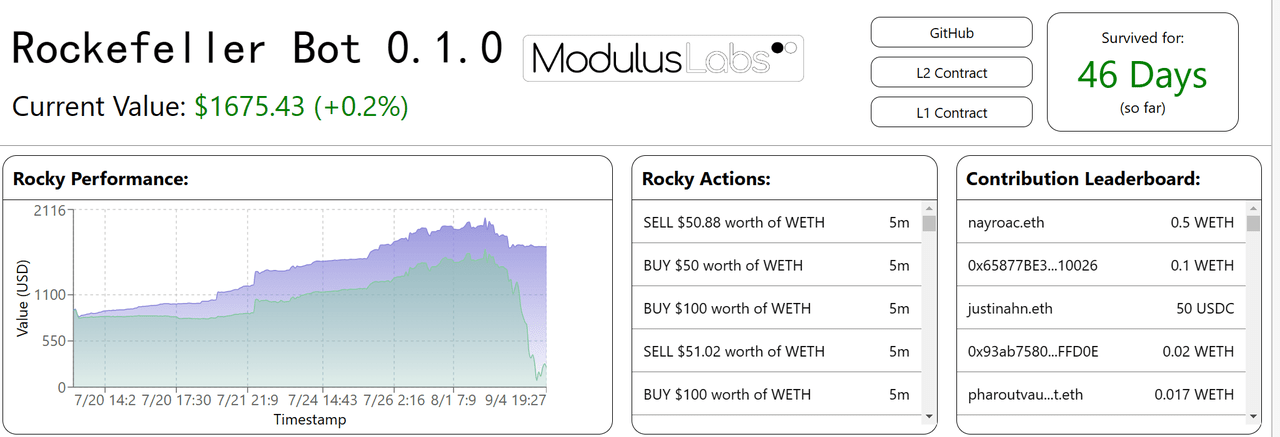
Gestão de ativos: estratégias de negociação automatizadas não são novidade nas finanças tradicionais e no Defi. Houve tentativas de aplicar estratégias de negociação geradas por IA/ML, mas apenas algumas estratégias descentralizadas tiveram sucesso. Aplicações típicas no campo Defi atualmente incluem o Rocky Bot experimentado pelo Modulus Labs.
Um contrato que mantém fundos em L1 e troca WEth/USDC no Uniswap.
Um contrato L2 implementa uma rede neural simples (mas flexível) de três camadas para prever preços futuros de WEth. O contrato usa informações históricas de preços WETH como entrada.
Um front-end simples para visualização e código PyTorch para treinar regressores e classificadores.
Isso se aplica à parte de “saída” da estrutura de confiança de ML. A saída é gerada em L2, transferida para L1 e usada para execução. Não pode ser adulterado durante este processo.
Isso se aplica às seções "Entrada" e "Modelo". A entrada de informações históricas de preços vem do blockchain. A execução do modelo é computada em CairoVM (um tipo de ZKVM), e seu rastreamento de execução gera uma prova ZK para verificação.
Rocky Bot: Modulus Labs criou um bot comercial usando IA para tomada de decisões na StarkNet.
MM automatizado e provisão de liquidez:
Essencialmente, é uma combinação de esforços semelhantes em curso na avaliação de riscos e gestão de activos, apenas com uma abordagem diferente em termos de volume, prazos e tipos de activos. Existem muitos artigos de pesquisa sobre como usar o ML para criação de mercado no mercado de ações. Pode ser apenas uma questão de tempo até que algumas das descobertas da pesquisa sejam adaptadas aos produtos Defi.
LyraFinance, por exemplo, está trabalhando com Modulus Labs para aprimorar seu AMM com recursos inteligentes que tornam sua utilização de capital mais eficiente.
Menções honrosas:
A equipe Warp.cc desenvolveu um projeto tutorial sobre como implantar um contrato inteligente que executa uma rede neural treinada para prever o preço do Bitcoin. Isso se alinha com as partes “entrada” e “modelo” de nossa estrutura, já que a entrada usa dados fornecidos pelo RedStoneOracles e o modelo é executado no Arweave como um contrato inteligente Warp.
Esta é a primeira iteração e envolve ZK, por isso é uma menção honrosa nossa, mas no futuro, a equipe Warp está considerando implementar uma peça ZK.
jogo
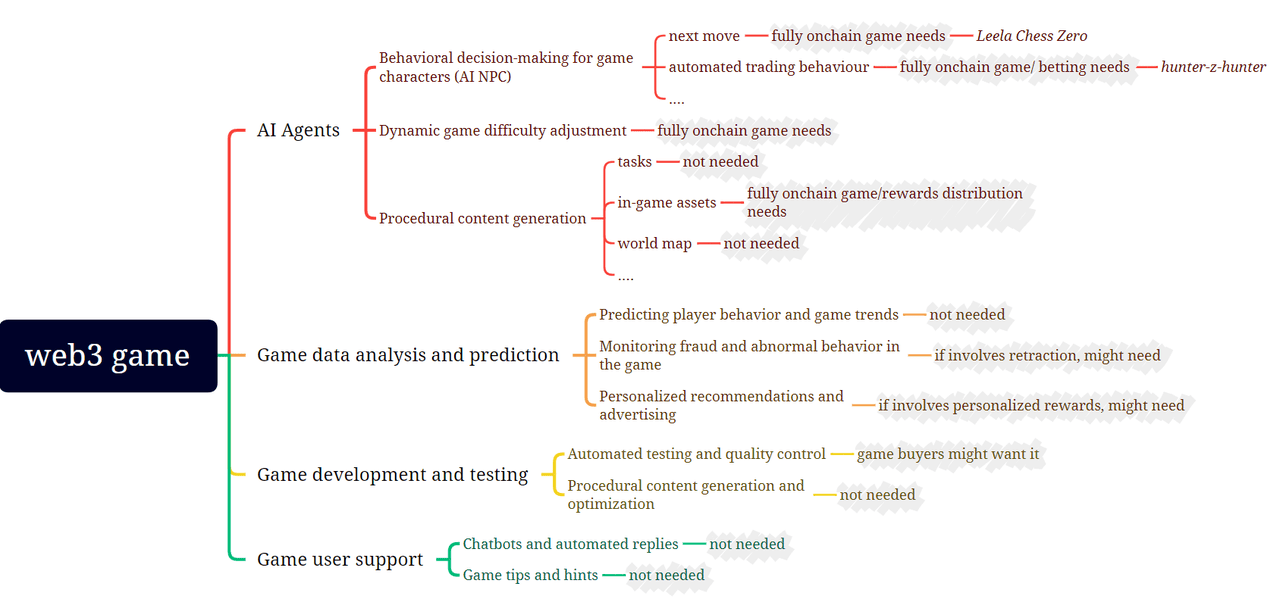
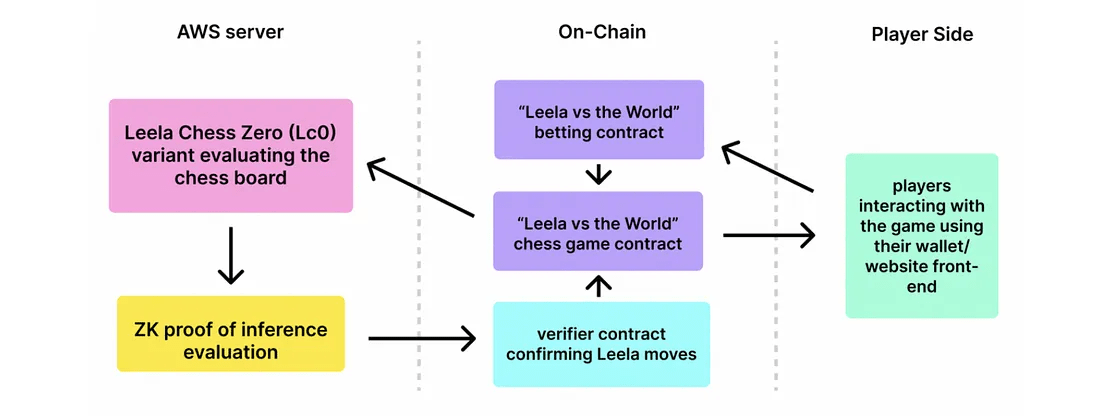
Os jogos têm muitas interseções com o aprendizado de máquina: a área cinza no diagrama representa nossa avaliação inicial sobre se os recursos de aprendizado de máquina na parte do jogo precisam ser combinados com as provas ZKML correspondentes. Leela Chess Zero é um exemplo muito interessante de aplicação de ZKML a um jogo:
Agente de IA
LC0 e o coletivo humano se revezam no jogo (como deveria ser o caso no xadrez).
O movimento de LC0 é calculado a partir de um modelo simplificado de LC0 equipado com circuito.
Leela Chess Zero (LC0): Um jogador de xadrez de IA totalmente on-chain construído pela Modulus Labs que joga contra um grupo de jogadores humanos da comunidade.
O movimento do LC0 tem uma prova de snark Halo2 para garantir que não haja interferência do cérebro humano. Apenas o modelo LC0 simplificado existe para tomar decisões.
Isso se encaixa na seção "Modelo". A execução do modelo conta com uma prova ZK para verificar se os cálculos não foram adulterados.
Análise e previsão de dados: este tem sido um uso comum de IA/ML no mundo dos jogos Web2. No entanto, encontramos poucos motivos para implementar ZK neste processo de ML. Provavelmente não vale a pena o esforço para não envolver muito valor diretamente no processo. No entanto, se determinadas análises e previsões forem usadas para determinar recompensas para os usuários, o ZK poderá ser implementado para garantir que os resultados estejam corretos.
Menções honrosas:
AI Arena é um jogo nativo do Ethereum onde jogadores de todo o mundo podem projetar, treinar e lutar contra personagens NFT alimentados por redes neurais artificiais. Pesquisadores talentosos de todo o mundo competem para criar os melhores modelos de aprendizado de máquina (ML) para participar de batalhas de jogos. AI Arena concentra-se em redes neurais feedforward. No geral, eles têm menor sobrecarga computacional do que redes neurais convolucionais (CNNs) ou redes neurais recorrentes (RNNs). Ainda assim, atualmente os modelos só são carregados na plataforma após a conclusão do treinamento, por isso vale a pena mencionar.
GiroGiro.AI está construindo um kit de ferramentas de IA que permite às massas criar inteligência artificial para uso pessoal ou comercial. Os usuários podem criar vários tipos de sistemas de IA com base na plataforma de fluxo de trabalho de IA intuitiva e automatizada. Ao inserir apenas uma pequena quantidade de dados e selecionar um algoritmo (ou modelo para melhoria), os usuários podem gerar e aproveitar o modelo de IA que têm em mente. Embora o projeto esteja em seus estágios iniciais, estamos muito entusiasmados para ver o que o GiroGiro pode trazer para o financiamento de jogos e produtos focados no metaverso, por isso o incluímos como uma menção honrosa.
DID e sociais
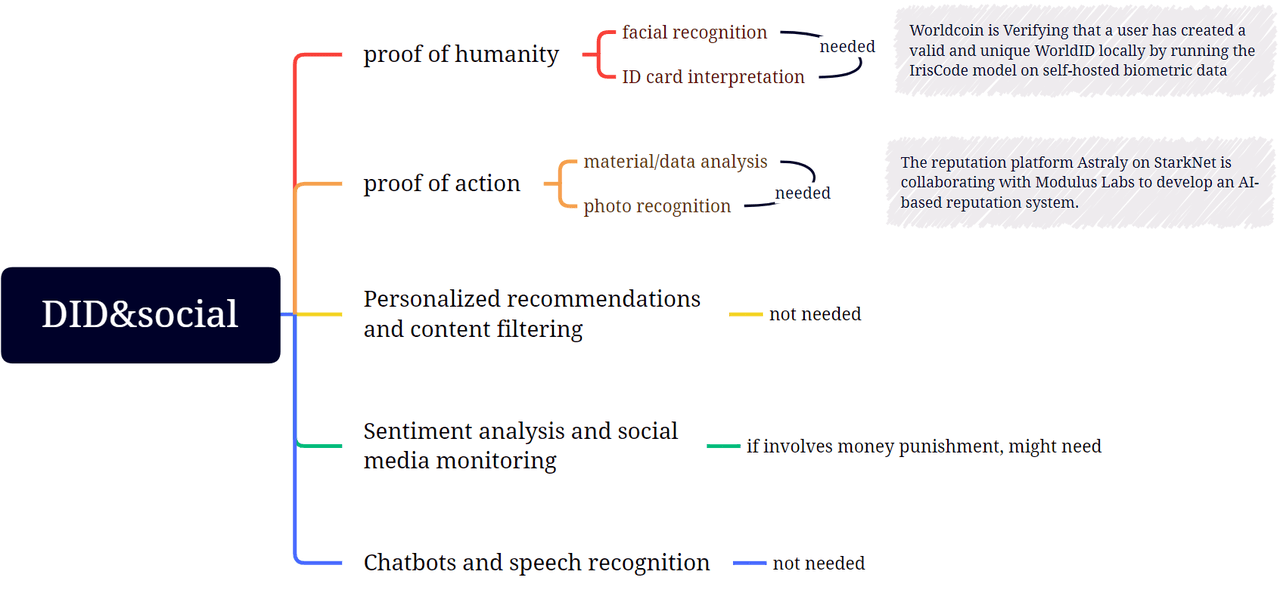
No DID e no espaço social, a intersecção da Web3 e do ML ocorre atualmente principalmente nas áreas de prova humana e prova de credenciais. Outras partes podem se desenvolver, mas levarão mais tempo;
prova humana
O aplicativo do usuário gera um endereço de carteira localmente.
A aplicação utiliza um Semáforo para comprovar que possui a chave privada de uma chave pública previamente cadastrada. Por ser uma prova de conhecimento zero, ela não revela qual é a chave pública.
A prova é novamente enviada ao sequenciador, que a verifica e inicia o processo de depósito dos tokens no endereço da carteira fornecido. As chamadas peças são enviadas com comprovante, garantindo que os usuários não possam resgatar suas recompensas duas vezes.
O usuário gera um par de chaves Semaphore no celular e fornece a chave pública com hash ao Orb por meio do código QR.
Orb verifica a íris do usuário e calcula o IrisHash do usuário localmente. Em seguida, ele envia uma mensagem assinada contendo a chave pública com hash e IrisHash para o nó do pedido de registro.
O nó sequencial verifica a assinatura do Orb e, em seguida, verifica o IrisHash para ver se ele corresponde a algum já existente no banco de dados. Se a verificação de exclusividade for aprovada, o IrisHash e a chave pública serão salvos.
Worldcoin usa um dispositivo chamado Orb para determinar se alguém é uma pessoa real, em vez de tentar verificá-lo de forma fraudulenta. Isso é feito analisando características faciais e da íris por meio de vários sensores de câmera e modelos de aprendizado de máquina. Uma vez feita essa determinação, Orb tira fotos da íris de um grupo de pessoas e usa vários modelos de aprendizado de máquina e outras técnicas de visão computacional para criar um código de íris, uma representação digital das características mais importantes do padrão de íris de um indivíduo. As etapas específicas de registro são as seguintes:
Worldcoin usa o sistema de prova de conhecimento zero Semaphore de código aberto para converter a exclusividade do IrisHash na exclusividade de uma conta de usuário sem vinculá-los. Isso garante que um usuário recém-registrado possa reivindicar suas WorldCoins com sucesso. As etapas são as seguintes:
A WorldCoin usa a tecnologia ZK para garantir que o resultado de seus modelos de ML não revele os dados pessoais dos usuários porque não há correlação entre eles. Neste caso, enquadra-se na parte “saída” da nossa estrutura de confiança, pois garante que a saída é transmitida e utilizada da forma desejada, neste caso de forma privada.
Revisitando a estrutura de confiança de ML a partir de uma perspectiva de caso de uso
Pode-se observar que os potenciais casos de uso do ZKML na Web3 ainda estão em sua infância, mas não podem ser ignorados no futuro, à medida que o uso do ZKML continua a se expandir, pode haver necessidade de provedores de ZKML, formando um fechado; loop na figura abaixo:
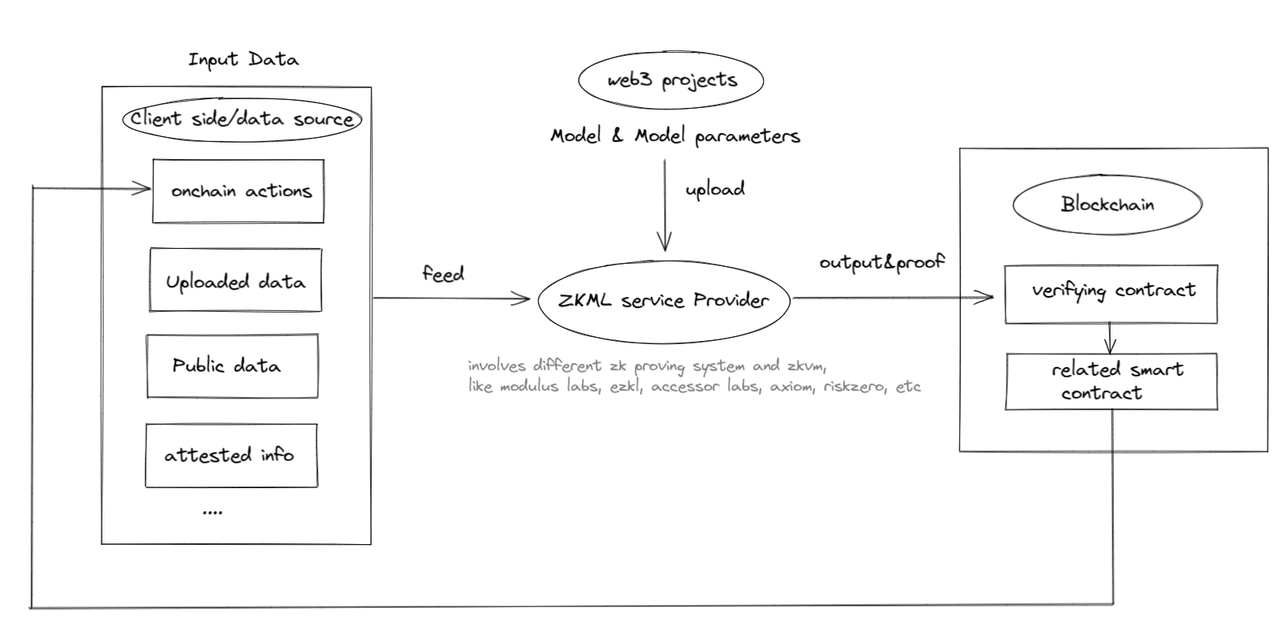
Os provedores de serviços ZKML concentram-se principalmente nas partes de “modelo” e “parâmetro” da estrutura de confiança de ML. Embora a maior parte do que vemos agora relacionado a "parâmetros" esteja mais relacionado a "modelo". É importante notar que as partes de “entrada” e “saída” são mais abordadas por soluções baseadas em blockchain, seja como fonte de dados ou destino de dados. ZK ou blockchain por si só podem não alcançar confiabilidade total, mas combinados podem.
A que distância está da aplicação em larga escala?
Finalmente, podemos observar o estado atual de viabilidade do ZKML e quão perto estamos da adoção em larga escala do ZKML.
O artigo do Modulus Labs nos fornece alguns dados e insights sobre a viabilidade de aplicações ZKML testando Worldcoin (com requisitos rigorosos de precisão e memória) e AI Arena (com custo-benefício e requisitos de tempo):
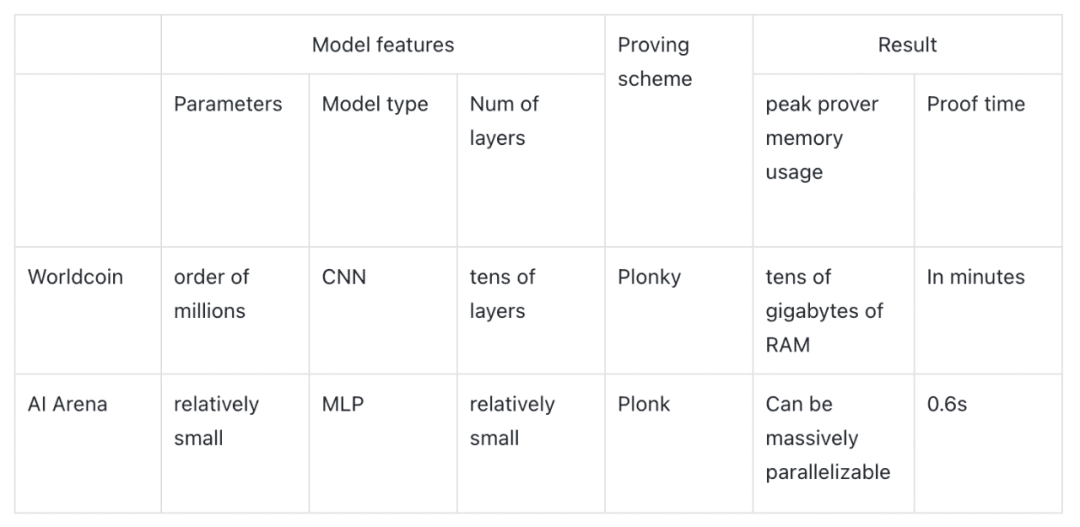
Se a Worldcon usasse ZKML, o consumo de memória do provador excederia as capacidades de qualquer hardware móvel comum. Se a competição AI Arena usar ZKML, o uso de ZKCNNs aumentará o tempo e o custo em um fator de 100 (0,6 s vs. 0,008 s). Infelizmente, ambos não são adequados para aplicar diretamente técnicas ZKML para tempo de prova e uso de memória do provador.
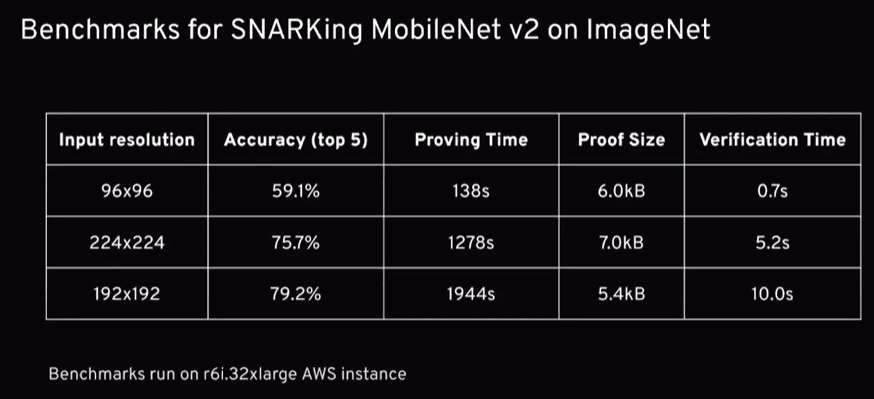
E quanto ao tamanho da prova e ao tempo de verificação? Podemos referir-nos aos artigos de Daniel Kang, Tatsunori Hashimoto, Ion Stoica e Yi Sun. Conforme mostrado abaixo, sua solução de inferência DNN atinge 79% de precisão no ImageNet (tipo de modelo: DCNN, 16 camadas, 3,4 milhões de parâmetros), levando apenas 10 segundos para verificar e um tamanho de prova de 5.952 bytes. Além disso, os zkSNARKs podem ser reduzidos para 59% de precisão com um tempo de verificação de apenas 0,7 segundos. Esses resultados mostram que zkSNARKing em modelos em escala ImageNet é viável em termos de tamanho de prova e tempo de verificação. Os principais gargalos técnicos atualmente são o tempo de prova e o consumo de memória. A aplicação do ZKML no caso do web3 ainda não é tecnicamente viável. O ZKML tem potencial para acompanhar o desenvolvimento da IA? Podemos comparar vários dados empíricos:
A rapidez com que os modelos de aprendizado de máquina estão evoluindo: o modelo GPT-1 lançado em 2019 tinha 150 milhões de parâmetros, enquanto o modelo GPT-3 mais recente lançado em 2020 tinha 175 bilhões de parâmetros, um aumento de 1.166 vezes no número de parâmetros em apenas dois anos .
Velocidade de otimização de sistemas de conhecimento zero: O crescimento do desempenho de sistemas de conhecimento zero segue basicamente o ritmo da “Lei de Moore”. Novos sistemas de conhecimento zero surgem quase todos os anos e esperamos que o rápido crescimento no desempenho dos provadores continue por algum tempo.
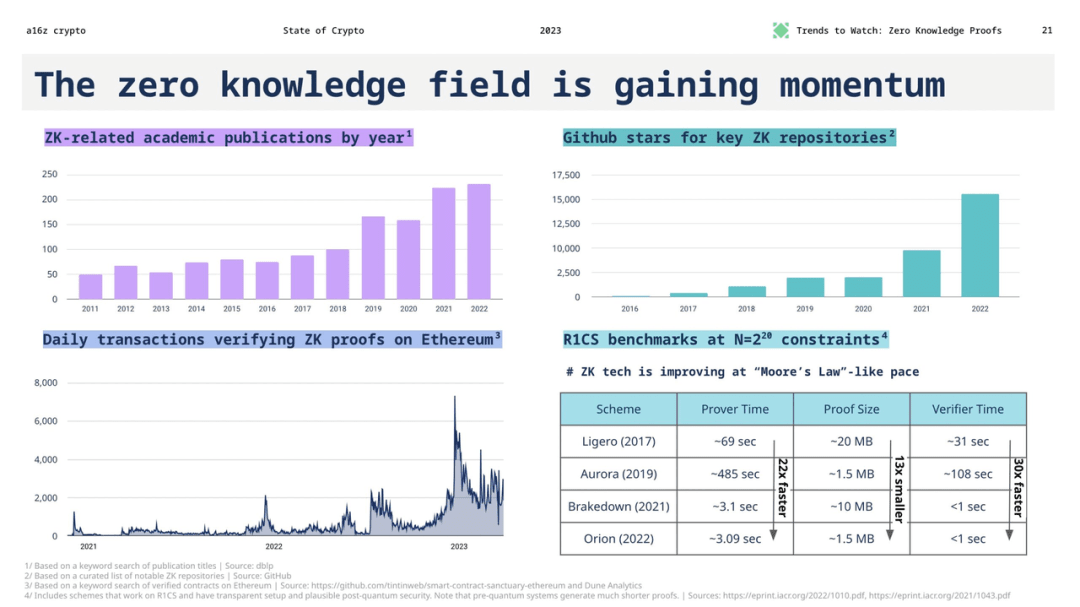
A julgar por esses dados, embora os modelos de aprendizado de máquina estejam se desenvolvendo muito rapidamente, a velocidade de otimização dos sistemas à prova de conhecimento zero também está aumentando constantemente. No futuro, o ZKML ainda poderá ter a oportunidade de acompanhar gradualmente o desenvolvimento da IA, mas necessita de inovação e otimização tecnológica contínuas para reduzir a lacuna. Isso significa que, embora o ZKML atualmente tenha gargalos técnicos em aplicativos web3, com o desenvolvimento contínuo da tecnologia de prova de conhecimento zero, ainda temos motivos para esperar que o ZKML desempenhe um papel maior nos cenários web3 no futuro. Comparando as taxas de melhoria do ML e ZK de ponta, as perspectivas não são muito otimistas. No entanto, com a melhoria contínua do desempenho de convolução, do hardware ZK e do sistema de prova ZK adaptado com base em operações de rede neural altamente estruturadas, espera-se que o desenvolvimento do ZKML possa atender às necessidades da web3, começando com o fornecimento de algumas máquinas antigas A função de aprendizagem é iniciada. Embora possa ser difícil para nós usar blockchain + ZK para verificar se as informações que o ChatGPT me envia são confiáveis, podemos conseguir encaixar alguns modelos de ML menores e mais antigos no circuito ZK.
para concluir
“O poder tende a corromper e o poder absoluto corrompe absolutamente.” Com o incrível poder da IA e do ML, atualmente não existe uma maneira infalível de colocá-los sob governança. Os factos provaram repetidamente que os governos ou intervêm tardiamente no rescaldo, ou promovem proibições definitivas. Blockchain + ZK oferece uma das poucas soluções que podem domar a fera de forma comprovável e verificável.
Esperamos ver mais inovações de produtos no campo ZKML e blockchain proporcionando um ambiente seguro e confiável para a operação de IA/ML. Também esperamos que essas inovações de produtos gerem modelos de negócios inteiramente novos, porque no mundo das criptomoedas sem permissão, não estamos limitados pelo modelo de comercialização de-SaaS aqui. Esperamos apoiar mais construtores à medida que eles constroem suas ideias emocionantes nesta fascinante sobreposição de Wild West Anarchy e Ivory Tower Elite. Ainda estamos nos estágios iniciais, mas talvez já estejamos no caminho certo para salvar o mundo.