


2024.03.14
Introdução ao Projeto
Lançado em junho passado, Grass constrói uma rede descentralizada de web scraping focada em transformar dados públicos da web em conjuntos de dados de IA. A rede pertence e é operada pelos usuários e é a maneira mais fácil para qualquer pessoa interagir com IA. Todos podem criar rapidamente seu próprio nó Grass. Para obter detalhes, você pode conferir o tutorial postado por Goose antes. Você também pode reproduzi-lo no seu celular!
Atualmente, o preço das baleias atingiu 4,6U/1.000 pontos dentro e fora do mercado. Em condições de rede de 75%, um único dispositivo IP pode extrair cerca de 50.000 pontos em um mês, o que equivale a 240U. Há muito tempo, Goose pediu para você minerar, mas muitas pessoas tinham preguiça de minerar. Agora eu digo que você pode minerar 240u com seu computador ou celular ligado por um mês. na casa de parentes e amigos durante o Ano Novo Chinês, haverá vários 240u Você tem algum arrependimento? Se você se arrepende, venha fazer sua lição de casa rapidamente! !
Grass atualmente planeja lançar o primeiro rollup de dados da Camada 2 no SOL. O Goose o dividiu especialmente em uma versão que é muito longa para ler e uma versão oficial do artigo para os amigos lerem e entenderem.
Muito tempo para assistir
Antes de Grass propor este plano, ele só tinha o conceito de DEPIN mais IA, mas agora planeja construir sua própria cadeia pública de IA. Isso significa que a Grass se expandiu para outro modelo de negócios completamente diferente de antes. Ela adicionou funções de registro de dados e funções de processador ZK de seu negócio simples anterior de ajudar empresas de IA a limpar dados. Assim que a Camada 2 for construída, seu conceito se tornará SOL + DEPIN + AI + o primeiro conceito de rollup de dados. Os quatro conceitos são sobrepostos. Não direi o quão valioso é.
Tutorial da versão para PC:
https://weibo.com/ttarticle/p/show?id=2309404997006383775962
Tutorial da versão móvel:
https://weibo.com/ttarticle/p/show?id=2309404998038614573232
positivo
Grass: o primeiro rollup de dados da camada 2 da história
Nas últimas semanas, publicamos algum conteúdo para explicar o papel de Grass na pilha de IA. Agora você aprendeu que este protocolo executa muitas funções para ajudar os construtores a acessar dados de rede para treinar seus modelos. Este é o primeiro estágio crítico do processo de IA e o ponto de partida para todo o desenvolvimento.
No caso do Grass, um conjunto de nós é hospedado em dispositivos residentes, coletando e processando dados brutos da rede. Ele limpa e transforma dados em conjuntos de dados estruturados para treinamento de IA. O melhor de tudo é que ele captura dados de rede de uma forma que envolve e recompensa quase um milhão de pessoas em todo o mundo pela participação. Sozinho, cria uma categoria no fornecimento de dados de IA e é por isso que algumas das maiores empresas de IA do mundo optam por trabalhar connosco. É a camada de dados da IA.
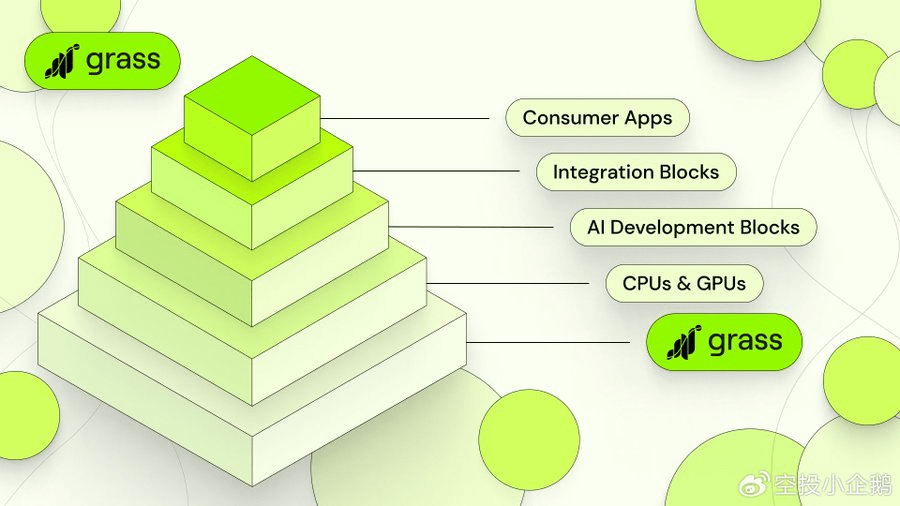
Enquanto isso, passamos as últimas semanas pensando sobre o estado atual da inteligência artificial. Perguntámo-nos quais são os problemas mais urgentes e o que podemos fazer para os resolver como uma parte importante da infraestrutura de IA.
Concluímos que o maior problema que a IA enfrenta hoje é a falta de transparência dos dados. Basta olhar as notícias e você entenderá. Pergunte a si mesmo: por que um modelo de IA compararia Elon Musk a Hitler? Ou apagar grupos étnicos inteiros da história mundial? Os dados errados foram usados durante o treinamento? Ou pior, usando bons dados que fornecem respostas erradas seletivamente?
A resposta é: não sabemos. E não sabemos porque não há como saber. Não sabemos em quais dados esses modelos foram treinados porque não existe nenhum mecanismo para provar isso. Não há como os usuários verificarem a origem dos dados, assim como não há como os próprios construtores verificarem.
Este é o problema que Grass planeja resolver, e agora estamos construindo um rollup de dados da Camada 2 para resolver esse problema. Como, você pode perguntar?
Por favor, permita-nos explicar.
Camada Dois: Como criar fontes de dados
O mundo precisa de uma maneira de provar a origem dos dados de treinamento de IA, e é isso que a Grass está construindo agora. Em breve, toda vez que os dados forem extraídos por um nó Grass, os metadados serão registrados para autenticar o site do qual os dados foram extraídos. Esses metadados são então incorporados permanentemente em cada conjunto de dados, permitindo que os construtores tenham certeza absoluta de sua procedência. Eles podem então compartilhar esse pedigree com os usuários, que podem ter certeza de que o modelo de IA com o qual interagem não foi treinado deliberadamente para dar respostas enganosas.
Este foi um esforço significativo e exigiu grandes extensões do nosso protocolo em preparação para escalar as operações de raspagem para dezenas de milhões de solicitações de rede por minuto. Cada solicitação exigirá validação, que terá um rendimento maior do que qualquer L1 pode fornecer. É por isso que anunciamos planos para construir uma solução de Camada 2 para lidar com uma grande atualização em nossos recursos. O L2 será um rollup soberano, equipado com um processador ZK para que os metadados possam ser agrupados para validação e usados para fornecer uma linhagem persistente para cada conjunto de dados que produzimos. Isto é necessário para permitir que a camada fundamental de todo o desenvolvimento da IA passe para a próxima fase.
Os benefícios disto são muitos: protegerá contra a poluição de dados, capacitará a IA de código aberto e proporcionará transparência aos modelos com os quais interagimos todos os dias.
A seguir, descrevemos o projeto básico do sistema.
Arquitetura da grama
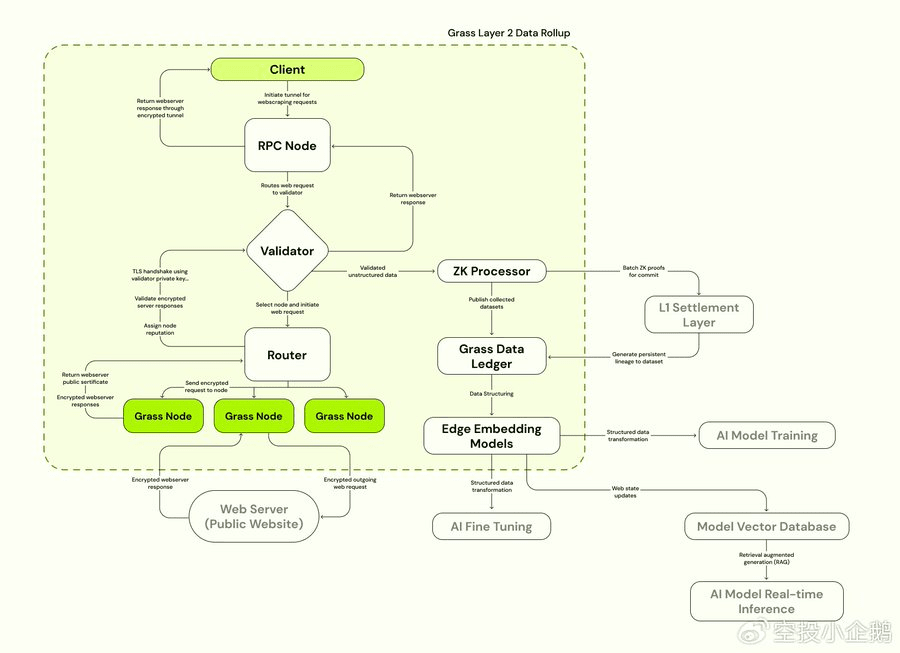
A maneira mais fácil de entender essas atualizações é observar um gráfico do Grass Data Rollup. À esquerda, entre o cliente e o servidor web, você vê a rede Grass, como é tradicionalmente definida. O cliente faz uma solicitação de rede, passa pelo validador e, por fim, é roteado pelo nó Grass. O servidor do site solicitado pelo cliente responderá à solicitação da rede, permitindo que seus dados sejam rastreados e enviados de volta pela linha. Os dados serão então limpos, processados e preparados para treinar a próxima geração de modelos de IA.
No diagrama L2, você verá duas adições principais à direita que serão adicionadas com o lançamento da Camada Soberana 2 da Grass: o Grass Data Ledger e o Processador ZK.
Ambos têm funções próprias, por isso vamos explicá-los um por um.
Livro de dados de grama
O registro de dados é o local de armazenamento final para todos os dados no Grass. É um livro-razão permanente de cada conjunto de dados rastreado no Grass, agora com metadados incorporados para registrar sua linhagem desde o momento de origem. A prova de metadados para cada conjunto de dados será armazenada na camada de liquidação do Solana, e os próprios dados de liquidação estarão acessíveis através do livro-razão. A importância de o Grass ter um local para armazenar os dados que coleta precisa ser observada, embora falaremos disso em breve.
Processador ZK
Conforme descrevemos acima, o objetivo do processador ZK é auxiliar na documentação da origem dos conjuntos de dados extraídos na rede Grass. Imagine esse processo.
Quando um nó da rede – em outras palavras, um usuário que usa a extensão Grass – envia uma solicitação de rede para um determinado site, ele retorna uma resposta criptografada contendo todos os dados solicitados pelo nó. Para todos os efeitos, este é o momento em que nasceu o nosso conjunto de dados e o momento de origem que precisa de ser registado.
E é exatamente esse momento que capturamos quando registramos os metadados. Ele contém muitos campos – a chave da sessão, o URL do site rastreado, o endereço IP do site de destino, o carimbo de data/hora da transação e, claro, os próprios dados. Esta é toda a informação necessária para saber sem dúvida que um determinado conjunto de dados veio do site que pretende ser e, portanto, que um determinado modelo de IA foi treinado correta e fielmente.
A função do processador ZK é porque esses dados precisam ser liquidados na cadeia, mas não queremos que todos esses dados fiquem visíveis para os validadores Solana. Além disso, o grande número de solicitações de rede realizadas no Grass no futuro excederá inevitavelmente as capacidades de transferência de qualquer L1 – mesmo uma L1 tão poderosa quanto Solana. Em breve, a Grass será dimensionada ao ponto de realizar dezenas de milhões de solicitações de rede por minuto, com os metadados de cada solicitação precisando ser liquidados na cadeia. Seria impossível enviarmos essas transações para L1 sem que o processador ZK fizesse as provas e as agrupasse primeiro. Portanto, L2 - é a única forma possível de atingir os objetivos que traçamos.
Agora, por que isso é importante?
Benefícios da Camada 2
livro razão de dados
A importância do livro-razão de dados é que ele eleva a expansão da Grass para outro modelo de negócios – e fundamentalmente diferente. Embora o protocolo continue a examinar minuciosamente os compradores que enviam as suas próprias solicitações de rede e coletam os seus próprios dados na web, uma parte crescente da sua atividade envolverá dados já armazenados no livro-razão. Com esse recurso, a Grass agora pode coletar dados estrategicamente para treinamento LLM e hospedá-los em um repositório de dados em constante expansão.
Este repositório é a camada de dados de uma pilha modular de IA, a partir da qual os construtores podem escolher blocos de construção para treinar modelos infinitamente diferentes. É essencialmente um modelo em miniatura da Internet, fornecendo dados de treinamento já estruturados e prontos para serem ingeridos pela IA.
Processador ZK
Abordamos em detalhes por que os processadores ZK são importantes. Ao permitir-nos criar provas de metadados que documentam a proveniência de um conjunto de dados Grass, fornece um mecanismo para construtores e utilizadores verificarem se um modelo de IA foi, de facto, treinado corretamente. Isso por si só é um grande negócio.
No entanto, há uma coisa que não mencionamos antes.
Além de registrar o site de origem do conjunto de dados, os metadados também indicam os nós pelos quais o conjunto de dados viajou na rede. Notavelmente, isso significa que cada vez que um nó rastreia a rede, ele pode obter crédito por seu trabalho sem revelar qualquer informação de identificação sobre si mesmo.
Agora, por que isso é importante?
Isso é importante porque, depois de provar quais nós funcionaram, você poderá começar a recompensá-los proporcionalmente. Alguns nós são mais valiosos que outros. Alguns nós rastreiam mais dados do que seus pares. E estes são exatamente os nós que precisamos incentivar para continuar a rápida expansão da rede que temos visto nos últimos meses. Acreditamos que este mecanismo aumentará significativamente as recompensas para as áreas mais necessitadas em todo o mundo, incentivando, em última análise, as pessoas nesses locais a inscreverem-se e a aumentar exponencialmente a capacidade da rede.
Escusado será dizer que quanto maior a rede, maiores serão as nossas capacidades de rastreamento e maior será o repositório de dados de rede que armazenamos. Um ciclo de feedback positivo surgirá inevitavelmente, e mais dados significam que teremos mais dados disponíveis para os laboratórios de IA que precisam de dados de treinamento – fornecendo assim incentivos para o crescimento contínuo da rede.
para concluir
No geral, a maioria dos problemas pendentes na IA hoje decorrem da falta de visibilidade sobre como os modelos são treinados, o que acreditamos pode ser resolvido capacitando a IA de código aberto com sistemas que verificam a proveniência dos dados. Nossa solução é construir o primeiro rollup de dados da Camada 2, que tornará possível introduzir mecanismos para registrar metadados de todas as fontes de conjuntos de dados.
As provas ZK desses dados serão armazenadas na camada de liquidação L1, enquanto os próprios metadados serão, em última análise, vinculados aos seus conjuntos de dados subjacentes, uma vez que os próprios conjuntos de dados são armazenados em nosso próprio livro-razão de dados. Grass fornece uma camada de dados para pilhas modulares de IA, e esses desenvolvimentos trarão maior transparência e recompensas aos provedores de nós proporcionais à quantidade de trabalho que realizam.
Esta atualização deve ajudar a comunicar alguns de nossos próximos projetos e esclarecer o pensamento que orienta nossas decisões. Estamos entusiasmados em desempenhar um papel no sentido de tornar a IA mais transparente e entusiasmados com os muitos possíveis casos de uso futuros para nossos produtos. Essas atualizações abrirão vastas oportunidades para desenvolvedores, então se você ou sua equipe estiverem interessados em construir no Grass, entre em contato conosco pelo Discord. Obrigado pelo seu apoio e fique atento.
Participe da revolução da IA.