

#techsetup
techsetup
367 visualizações
15 discutindo
Popular
Últimas

·
--
🚀 $AI CLOUDFLARE CLAIRIC REDUZ O TEMPO DE PROCESSAMENTO EM 96% ⚡
📊 A prévia do Clairic mostra uma extração impressionante em apenas 0,46 segundo de faturas enormes, superando os LLMs tradicionais, que levam 16 segundos. ⚡ Ao transferir os cálculos numéricos brutos para fora da geração token por token, ele fornece pontuações de confiança e define como nulos os campos sem suporte em uma única etapa. 🦈 Essa cascata de eficiência reduz os custos de processamento de sinistros de US$ 11.740 para US$ 6.032 por milhão — uma redução de 49% que pode transformar os fluxos de trabalho financeiros impulsionados por IA. 💡 Como você vai aproveitar essa velocidade impressionante para ficar à frente da concorrência? 🤔
⚠️ Isto não é aconselhamento financeiro. Gerencie sempre seus riscos. 🛡️
🏷️ #AI #TechSetup #Efficiency #Crypto
🔥 💎
2

🚀 $AI REVELA UM MODELO DE VÍDEO ESPACIAL EM TEMPO REAL – A PRÓXIMA GERAÇÃO DE VR JÁ ESTÁ AQUI! 🦈
🦈 O novo motor “Seedance” da ByteDance consegue transmitir nuvens a 20 fps com latência de 0,05 s, descarregando o processamento pesado na nuvem e liberando os headsets Pico para uma interação incrivelmente suave. 📊 Isso espelha o benchmark “Genie 3” da Google, mas vai além ao unir conteúdo reativo à voz com jogos ao vivo, drama curto e streaming—tudo em uma única camada virtual. ⚡ A mudança estratégica sinaliza uma busca de liquidez decisiva impulsionada por IA, posicionando $AI como o canal para a exposição institucional à tecnologia imersiva.
💬 Como você vai alocar a exposição nesse cruzamento entre IA e VR—apostar cedo em tokens ou esperar o ecossistema amadurecer? 👇
⚠️ Não é aconselhamento financeiro. Gerencie sempre seu risco. 🛡️
🏷️ #AI #TechSetup #VRInnovation #Crypto
🔥 💎
30
·
--
🚀 $AI LIBERA uma CLI de uma grande exchange para CRIAÇÃO DE CONTEÚDO COM AGENTES! 📈
📊 O dinheiro inteligente já está conectando seus bots à nova CLI da API Gemini, permitindo que agentes como o Claude Code obtenham resultados multimodais em tempo real. A capacidade de gerar imagens, vídeos, narrações e análises de PDFs diretamente pela linha de comando reduz a latência e mantém a infraestrutura enxuta.
🦈 Essa eficiência se traduz em sinais de negociação mais precisos e ciclos de pesquisa mais rápidos — exatamente o que as mesas de negociação algorítmica de uma exchange de primeira linha desejam. Com a chave de uma grande exchange configurada, você deixa de lado o trabalho árduo de escrever scripts e permite que o mecanismo multimodal do Google faça o trabalho pesado. ⚡
💬 Como você planeja incorporar o poder multimodal de uma grande exchange ao seu próximo bot de negociação? 👇
⚠️ Isto não é aconselhamento financeiro. Gerencie sempre seus riscos. 🛡️
🏷️ #AI #TechSetup #GeminiCLI #CryptoTools
🚀 🔥
12

·
--
🚀 $AI RIPL REDUZ A LATÊNCIA DE INFERÊNCIA EM 14X – O EDGE EM TEMPO REAL REDEFINIDO! 📈
📊 O mecanismo RIPL da Liquid AI reduz a latência do LFM2.5, com 1,2 bilhão de parâmetros, para 34,6 ms em uma única NVIDIA B200, atendendo a 95 % das solicitações a 1.000 RPS dentro desse intervalo. ⚡ Em comparação com os 498 ms do vLLM, a diferença aumenta para 14,4×, indicando uma vantagem de velocidade decisiva para classificação de buscas e controle de risco em pagamentos.
🦈 Essa aceleração transforma os modelos de linguagem em recursos ágeis na linha de frente, permitindo que as instituições aproveitem a liquidez antes que o fluxo de ordens se estabilize. 💡 Espere uma onda de adoção rápida à medida que as empresas buscam vantagem em latência para superar os concorrentes em ciclos de decisão em tempo real. 💬 Como essa vantagem de velocidade vai transformar sua estratégia de IA em tempo real? 👇
⚠️ Isto não é aconselhamento financeiro. Gerencie sempre seus riscos. 🛡️
🏷️ #AI #TechSetup #Inference #Speed #Crypto
🔥 💎
🚨 $AI REVELA ELIMINAÇÃO DE BUGS ORIENTADA PELA MATEMÁTICA – A NOVA VANTAGEM DA CLAUDE! 🦈
A parceria da Claude com a Theorem transforma testes fuzz aleatórios em provas formais, 📊 oferecendo garantias determinísticas que os testes convencionais não conseguem igualar. Em poucas semanas, o modelo verificou 239 pontos de entrada em 123 bibliotecas, gerando 180 milhões de linhas de prova e eliminando falhas causadas por entradas com menos de 64 MB. ⚡ Centenas de bugs ocultos — como uma gravação de 20 MB fora dos limites — não só foram detetados como também corrigidos, demonstrando um salto de escalabilidade que rivaliza com décadas de esforços humanos de verificação.
O mercado está atento a como este paradigma que privilegia a prova poderá reformular os modelos de risco para ativos impulsionados por IA. 📌 Será que as alocações de investidores experientes vão passar a privilegiar projetos que incorporam a verificação formal como vantagem competitiva? 💬 Qual é a tua perspetiva sobre o prémio de longo prazo do código protegido matematicamente? 👇
⚠️ Isto não é aconselhamento financeiro. Gere sempre o teu risco. 🛡️
🏷️ #AI #TechSetup #Verification #Crypto #Innovation
🔥 💎
1

·
--
🚀 $AI REVELA GPT‑6 SOL & LUNA – POTÊNCIA MAIS BARATA! 📈
📊 O poder de processamento de código do Sol chega por US$ 2 de entrada / US$ 10 de saída por milhão de tokens, um corte expressivo de 50% em relação ao Opus 5.5, estimulando uma nova onda de demanda por pipelines de desenvolvimento com IA ⚡. Luna vira o jogo com preços de US$ 0,10/US$ 0,50, transformando tarefas de alta frequência em arbitragem barata, enquanto as taxas de engano caem para menos de 3% 🦈💡. Os dois modelos já estão disponíveis na API, prontos para que bots pioneiros explorem o novo pool de liquidez.
💬 Qual modelo você vai adicionar primeiro à sua pilha de automação? 👇
⚠️ Isto não é aconselhamento financeiro. Gerencie sempre seus riscos. 🛡️
🏷️ #AI #TechSetup #Automation #Crypto
🚀 💎
3
·
--
🚀🦈 $AI LIBERA AGENTES DE CODIFICAÇÃO MULTI‑MÁQUINA – PRÓXIMA ONDA DE INFRAESTRUTURA DE IA!
A Herdr 0.9.0 chega como um tmux feito para bots de codificação, permitindo que Claude, Codex e Cursor CLI rodem lado a lado em nós locais ou remotos via SSH. Mesmo se seu terminal desaparecer, os agentes continuam vivos, sincronizando o status em uma única barra lateral 📊⚡.
Os olhos do “dinheiro inteligente” veem isso como um catalisador de liquidez: a orquestração unificada de agentes reduz a latência, acelera a velocidade de desenvolvimento e pode gerar uma nova demanda por tokens de computação de IA 📈🦈. O roadmap promete colaboração entre máquinas — pense em inteligência de enxame multi‑nó.
💬 Você está pronto para empilhar sua stack de IA nessa onda multi‑máquina? 👇
⚠️ Não é aconselhamento financeiro. Gerencie sempre seu risco. 🛡️
🏷️ #AI #TechSetup #AgentOps #Crypto
🔥 💎
42
·
--
🚀 $AI BREAKTHROUGH: SWE-2 REDUZ CUSTOS À METADE E AUMENTA A EFICIÊNCIA NA PROGRAMAÇÃO! 💥
📊 SWE-2, a cria mais nova do Agente de Codificação Devin da Cognition, está rasgando a arena de benchmarks, elevando as pontuações em 5‑6% e cortando 64% do preço em comparação com os líderes. 🦈 No FrontierCode 1.1 Main, ele marca 50,0%, apenas 0,9 ponto atrás do líder, enquanto entrega uma redução de 58% nas voltas de interação e uma queda de 81% nos custos com esforço moderado. ⚡ A única cicatriz? Um modesto 27,3% no brutal Terminal‑Bench 4, lembrando que a corrida não acabou.
💬 Os traders vão começar a fazer hedge em seus pipelines de desenvolvimento com SWE‑2 ou vão esperar pelo próximo salto de fronteira? 👇
⚠️ Não é aconselhamento financeiro. Gerencie sempre seu risco. 🛡️
🏷️ #AI #TechSetup #CodingAI #Innovation #Crypto
🔥 💎
26

·
--
🚀 🦈 $AI FLASH SPEED SURGES TO 420 TOKENS/SEC – UMA BUSCA POR LIQUIDEZ PELO DINHEIRO INTELIGENTE
📊 O mais recente benchmark do DeepSeek V4.1 Flash registra 420 tokens por segundo, ultrapassando o teto anterior de 128‑tps. Mais de 71k tokens fluem em menos de três minutos, uma velocidade que reflete surtos de fluxo de ordens institucionais em uma exchange de primeira linha. 🦈
⚡ Essa vazão bruta vira um ímã de liquidez, permitindo que o modelo ingira e reaja a microsinais do mercado mais rápido do que a maioria dos traders algorítmicos. Espere revisitas a blocos de ordens enquanto o mercado se recalibra nesta nova fronteira de velocidade. 📌
💬 Você está se posicionando $AI para aproveitar essa vantagem de velocidade de execução? 👇
⚠️ Não é aconselhamento financeiro. Sempre gerencie seu risco. 🛡️
🏷️ #AI #TechSetup #FlashSpeed #Crypto #SmartMoney
🔥 💎
44

$FOLD REDESIGN: TELA MAIS LARGA, ENTRADA MAIS DEFINIDA – O FORMATO QUE A APPLE VAI ADOTAR 🦈
Entrada: 1.899 ⚡
Meta: 2.099 🚀
Stop Loss: 1.200 ⚠️
📌 A Samsung acabou de inverter a antiga silhueta alta e estreita para um painel de 7,6 polegadas em 4:3 — exatamente a geometria que o primeiro iPhone dobrável da Apple teria como referência. 📊 As pré-vendas foram abertas no mesmo dia, com envios começando em 7 de agosto, gerando um aumento imediato de volume para o ecossistema do $FOLD. 💡 Isso não é apenas uma atualização de produto — é uma ruptura estrutural de um formato que não vingou, sustentada por um design mais leve (201 g) e por uma camada de titânio que elimina a marca da dobra.
💬 O Ultra, a 2.099, inclui um sensor de 200 MP e bateria de 5.000 mAh, mas a varredura real de liquidez está no Fold 8 padrão. Você vai antecipar o catalisador da Apple em setembro ou vai deixar o Ultra liderar o ritmo? 👇
⚠️ Não é aconselhamento financeiro. Gerencie sempre seu risco. 🛡️
🏷️ #FOLD #Foldable #Samsung #TechSetup #Breakout
🦈 📱
38

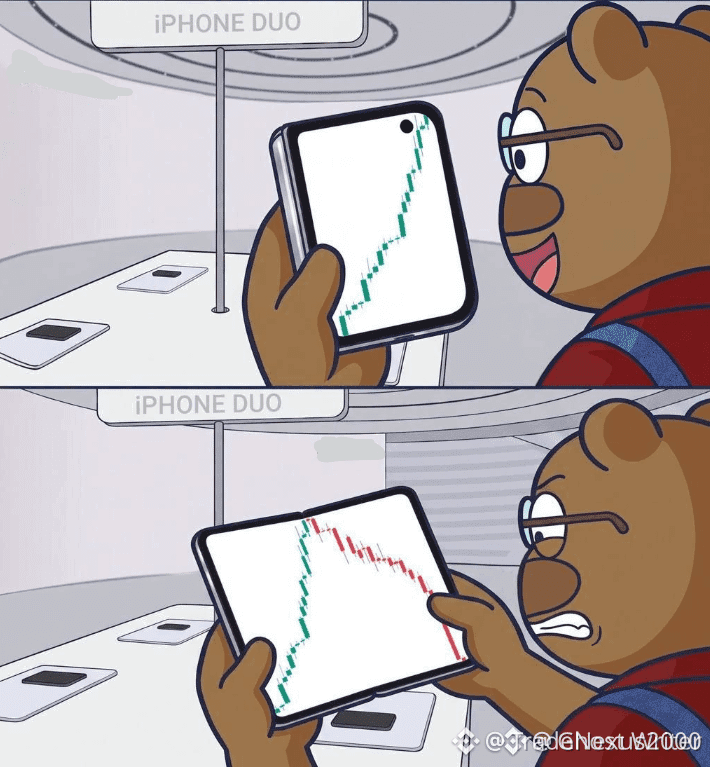
🦈 $AAPL DOBRADO EM UM NOVO TELEFONE: O DINHEIRO INTELIGENTE VAI REESCREVER O MODELO? 📈
📊 O lançamento dobrável da Apple é mais do que uma apresentação de produto; é uma varredura de liquidez que reposiciona o capital institucional por todo o ecossistema de tecnologia. 📌
🦈 A análise de blocos de ordem mostra o corredor $AAPL se apertando, com clusters de smart money acumulando antes dos resultados, sugerindo um possível impulso de alta quando o mercado absorver o novo formato. ⚡
💬 Como você está se posicionando diante dessa mudança estrutural? 👇
⚠️ Não é aconselhamento financeiro. Sempre gerencie seu risco. 🛡️
🏷️ #AAPL #Foldable #TechSetup #Liquidity #SmartMoney
🔥 💎
49
·
--
🚀 $DUSK FUNDAÇÃO CONCLUÍDA – ANDAR INSTITUCIONAL NO LUGAR? 💥
📊 Quando a camada base roda em segurança reforçada e a camada superior entrega as chaves aos devs, isso não é apenas uma stack de tecnologia — é um ímã de liquidez. $DUSK já concluiu o trabalho pesado: a engenharia está pronta, a infraestrutura foi testada em batalha, e a peça final agora depende do fluxo de capital. Dinheiro inteligente não espera por entradas perfeitas; ele se acumula onde a base é inquestionável. 📈
💡 Quanto mais tempo a lateralização dura, mais apertada fica a mola. Assim que a primeira vela de rompimento supera a máxima recente, a velocidade costuma seguir — porque o book de ofertas teve tempo de afinar. 💬 Você está acompanhando o fechamento diário para confirmação, ou já está posicionado antes do movimento? 👇
⚠️ Não é aconselhamento financeiro. Gerencie sempre seu risco. 🛡️
🏷️ #DUSK #Altcoin #TechSetup #Bullish #Crypto
🎯 🦈
16
Faça login para explorar mais conteúdos
Junte-se a usuários de criptomoedas de todo o mundo no Binance Square.
⚡️ Obter informações mais recentes e úteis sobre criptomoeda.
💬 Com a confiança da maior corretora de criptomoedas do mundo.
👍 Descubra insights reais de criadores verificados.
E-mail / número de telefone
Tópicos em Alta
1
#CanMicrosoftDeliverOnAI
337,898 visualizações
2,680 discutindo
2
#CanGoogleDefindItsCore
198,593 visualizações
1,890 discutindo
3
#EarningsSeason
5.9M visualizações
28,709 discutindo
4
#$10.9BBitcoinOptionsExpireFriday
423 visualizações
26 discutindo
5
#ThailandSupremeCourtRulesBitcoinIsProperty
578 visualizações
68 discutindo
6
#BitcoinSurpasses$81K
17,894 visualizações
77 discutindo
7
#RobinhoodFalls8.4%AfterItsResults
11,296 visualizações
235 discutindo
8
#KOSPISurges6.63%BackAbove6000
11,227 visualizações
232 discutindo
9
#DatavaultAICantWithdrawBitcoinFromBiconomy
12,599 visualizações
210 discutindo
10
#FOMCWatch
9.3M visualizações
29,512 discutindo