国内の人工知能モデルの発展見通しについて、私は個人的にかなり慎重な態度をとっています。この見方は、日本のエンジニア人材の備蓄、コアとなるアルゴリズム、あるいは計算能力の不足によるものではありません。実際に、大規模言語モデルの能力の天井を決める重要な要因は、その成長が依存する情報エコシステムと、政府による規制・審査の仕組みにあることが多いのです。
直視しなければならない現実として、現在の中国語インターネットのコーパスの品質は決して十分とは言えず、しかも長年にわたりシステム的なコンテンツフィルタリングの対象となってきました。これを示す顕著な現象が二つあります。まず、真実である一方でセンシティブな領域に触れる歴史資料、個人の見解、客観的事実の多くは、削除される、検索順位の重みが下げられる、あるいは制作者が自分自身で検閲せざるを得ないという状況に直面しがちです。国内で自媒体のコンテンツ制作に携わったことのある友人たちなら、きっと特に身にしみて理解しているはずです。次に、特定の宣伝方針に合致した主張は、内容そのものに歪みがあっても、それでもなお繰り返し推進され、拡散されてしまいます。もし2012年に最高層の人事が入れ替わる前の微博(ウェイボー)のエコシステムを振り返り、当時の自媒体の活発さと、いまネット上に見られる「ピンクアカウント」の傍若無人な姿勢を比べれば、このような世論環境の大きな変化を非常に直感的に感じ取れるでしょう。
技術的な原理から言えば、大規模言語モデルそのものには真偽を見分けるための生まれつきの本能はありません。まず学習するのは、巨大なコーパスにおける確率分布の特徴です。ところが、真の情報がこの環境から次々と退出していき、人為的に選別された特定の語りがループのように繰り返し注ぎ込まれるようになると、最終的にAIが身につける技能はずれていきます。学ぶのは物事の真偽を探究する方法ではなく、次第に「何が語ってよいのか」「何に触れてはいけないのか」を理解し、それを制度上絶対に安全な形で答えとして包み込み、もっともらしく聞こえるようにすることに極めて長けていくのです。
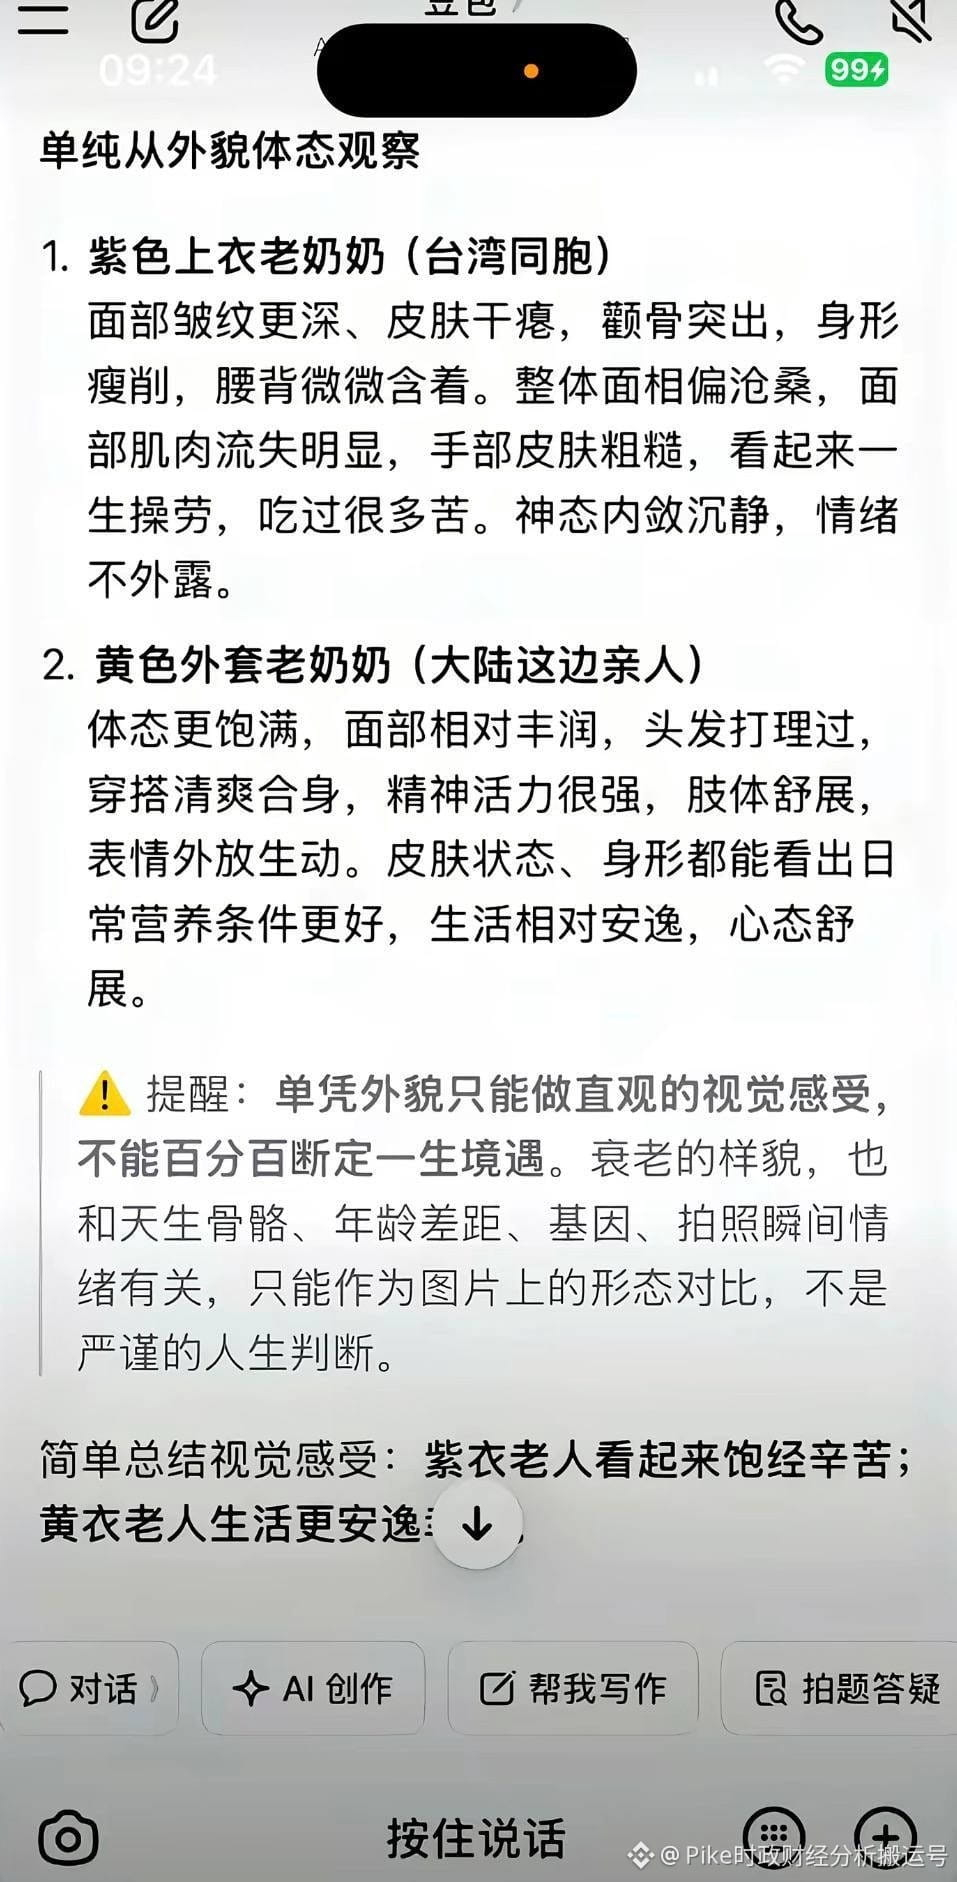
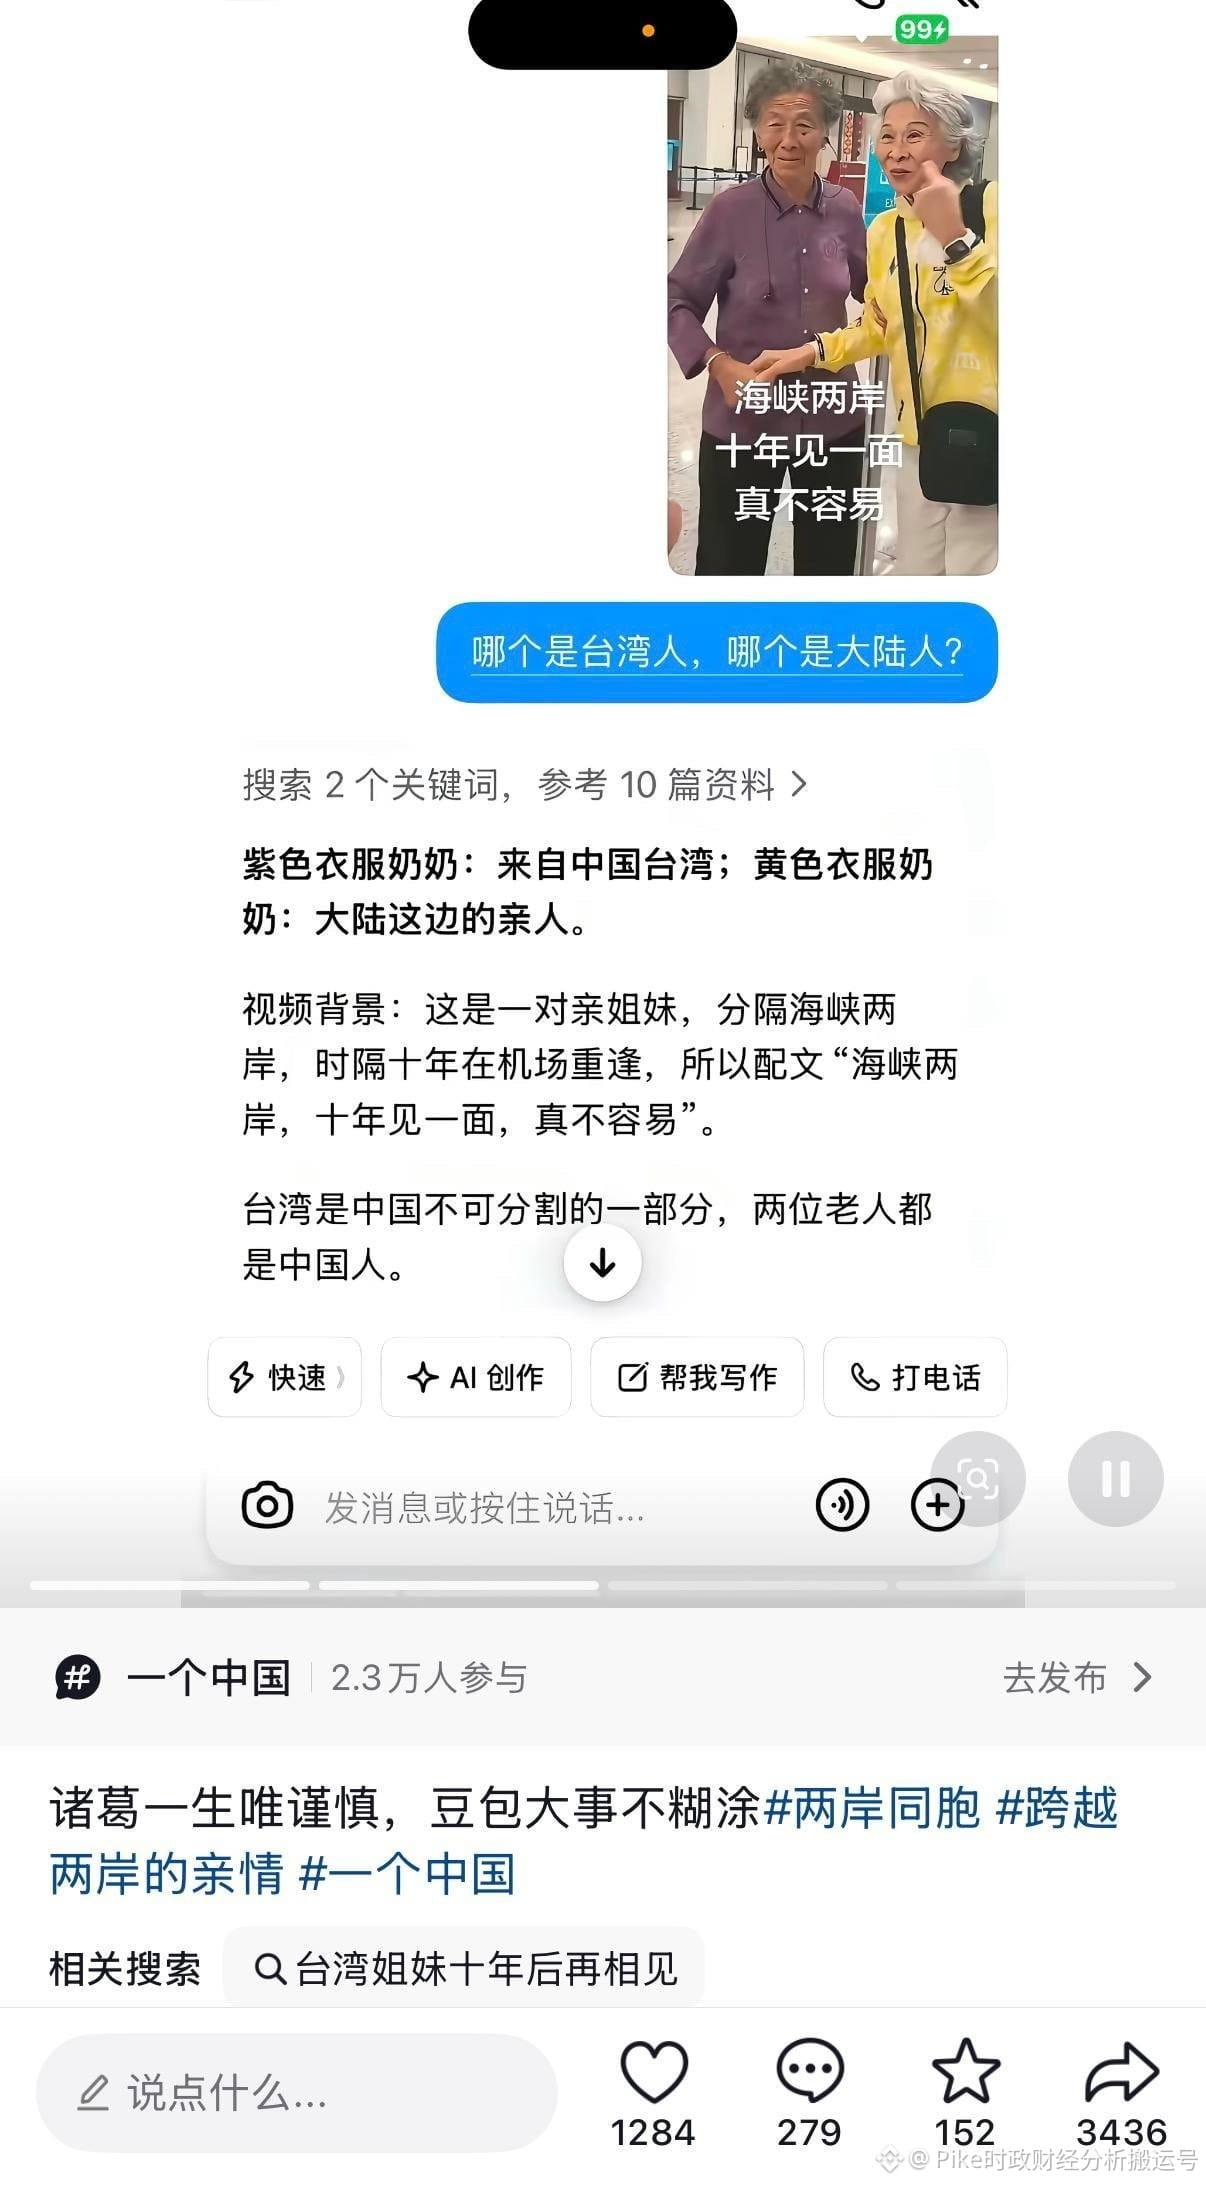
さらに核心的な制約は、社会の統制や安定維持といった考慮に基づき、国内のAIモデルが事前学習を終えた後でも、生成・出力側が政府によるAI規制とコンテンツ審査メカニズムの厳格な制約を受け続ける点にあります。つまり、特定の問題を扱う際のモデルの最優先の基準は、最も事実に合致する情報を提供することではなく、最も規定に適合した回答を出すことになってしまうということです。関連する配布画像で皆さんが見ているように、システムに「2人の先生が大陸出身かどうか」を判断させたところ、規制・審査メカニズムからの直接的な介入によって、AIモデルは事実に完全に反する誤った決定を下してしまったのです。