

AIエージェントはますます高性能になっています。
しかし、彼らの能力が高まるほど、ある一つの問いがより重要になります。
実際に彼らの行動を制御できるのでしょうか?
それは、NEAR AIのIronClaw 1.0を調べているときに私の注意を引いたことの一つです。 @NEAR Protocol
多くの人は、AIモデルが何について考えられるかに注目します。
IronClawは、AIが判断を下した後に何が起こるかに注目することで、少し異なるアプローチを取っています。
モデルは、何をすべきかを考えます。
そしてGuardは、モデルと行動のあいだに置かれます。
つまり単にこうではなく:
AI → 行動
得られるのは:
AI → ガード → 行動
このガードは、アクションを制御できる中核となるポイントを提供します。機密性の高いアクションは明示的な承認を必要とする場合があり、機密性の高い資格情報は追加の保護によって取り扱われます。
そして、そのパフォーマンスも言及する価値があります。
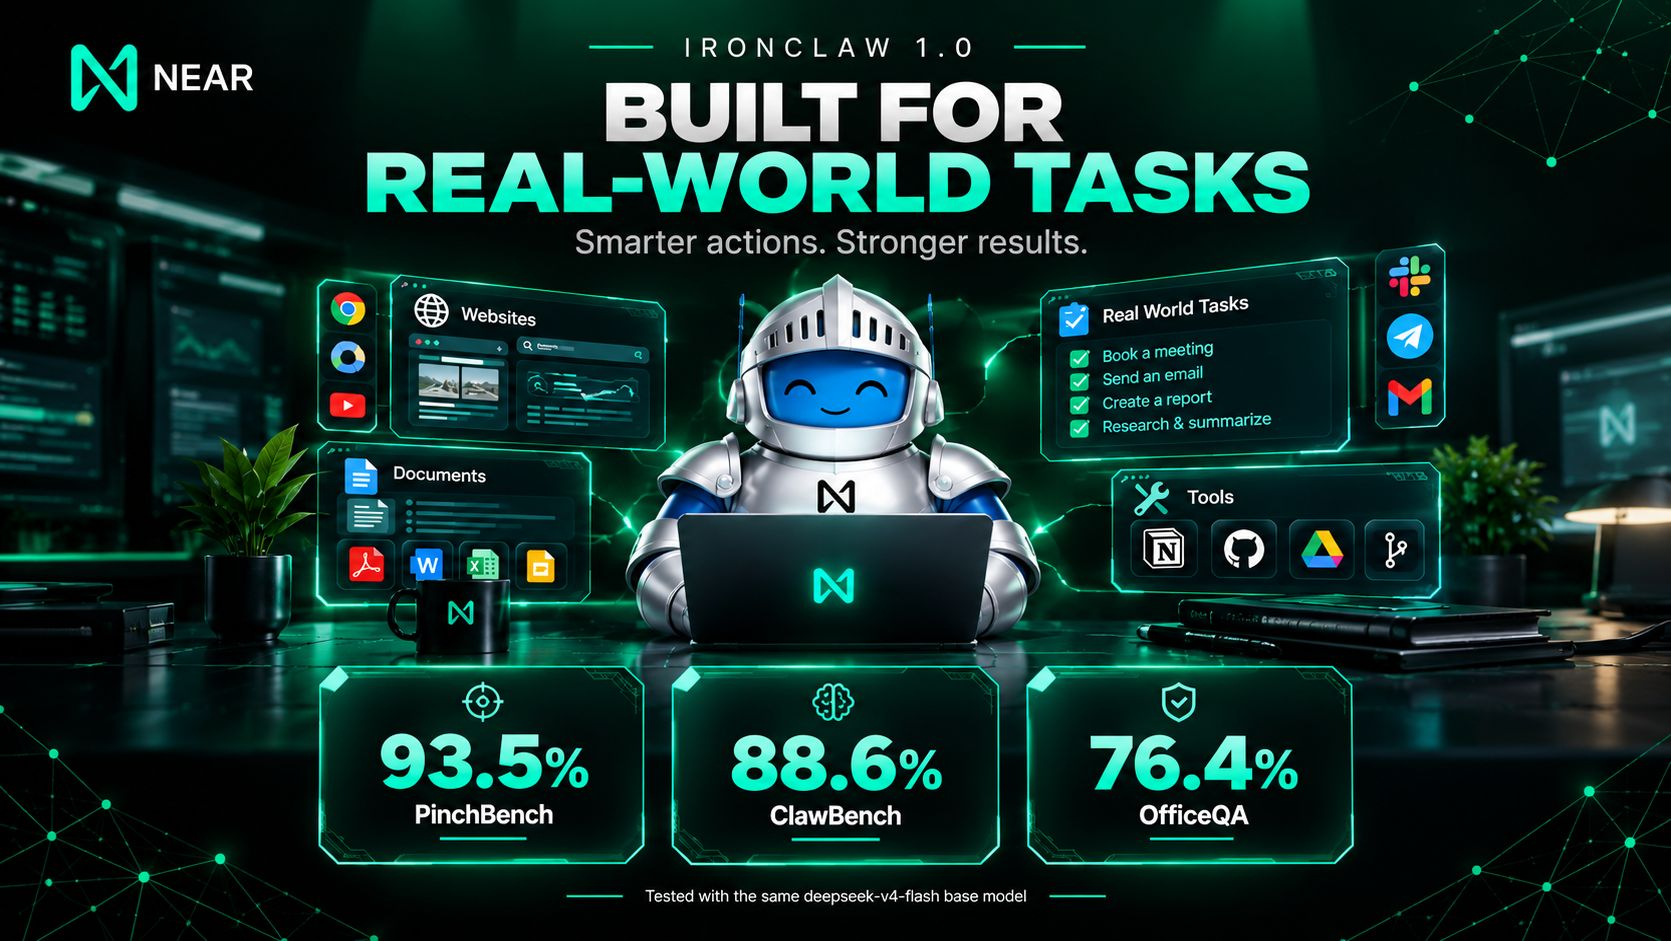
同じdeepseek-v4-flashベースモデルを使って、IronClaw 1.0は次を報告しました:
📌 PinchBench 93.5%
📌 ClawBench 88.6%
📌 OfficeQA 76.4%
これらのベンチマークは、さまざまな実用的な能力を見ています。
PinchBenchは147の現実のタスクをカバーしています。
ClawBenchは、140以上の実在するWebサイトにまたがってエージェントをテストします。
OfficeQAは、大量の米国財務省の文書を通じて推論することに焦点を当てています。
では、この数字が、エージェントがさまざまな種類の仕事でどのように動くかをより広い視点で示します。
しかし、私が同じくらい重要だと個人的に感じるのは、その進捗を維持できる能力です。#NEARAI
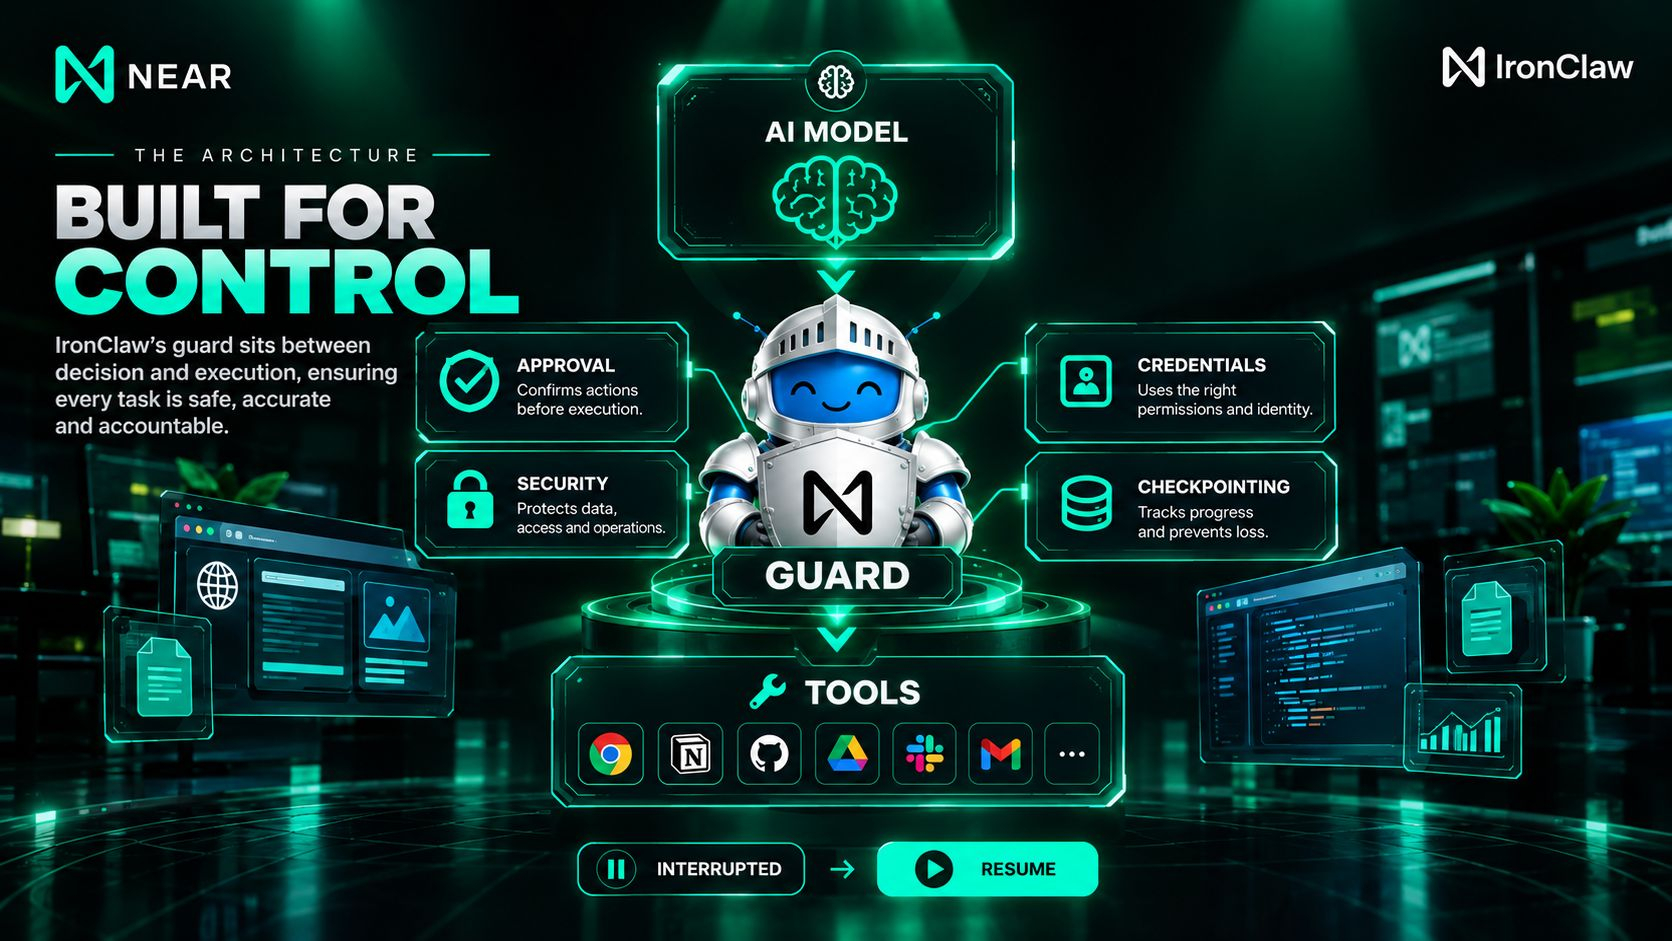
IronClawは継続的に状態をチェックポイントします。
タスクが中断された場合、作業をすべて捨ててしまうのではなく、前の状態から再開できます。
また、メモリや安全ルールをそれらのチャネル間で一貫させたまま、CLI、Web、Slack、Telegramにも対応しています。
チーム向けには、組織がどのようにエージェントを展開したいかに応じて、さまざまな隔離オプションも用意されています。
すると、より広いNEAR AIのエコシステムにたどり着きます。
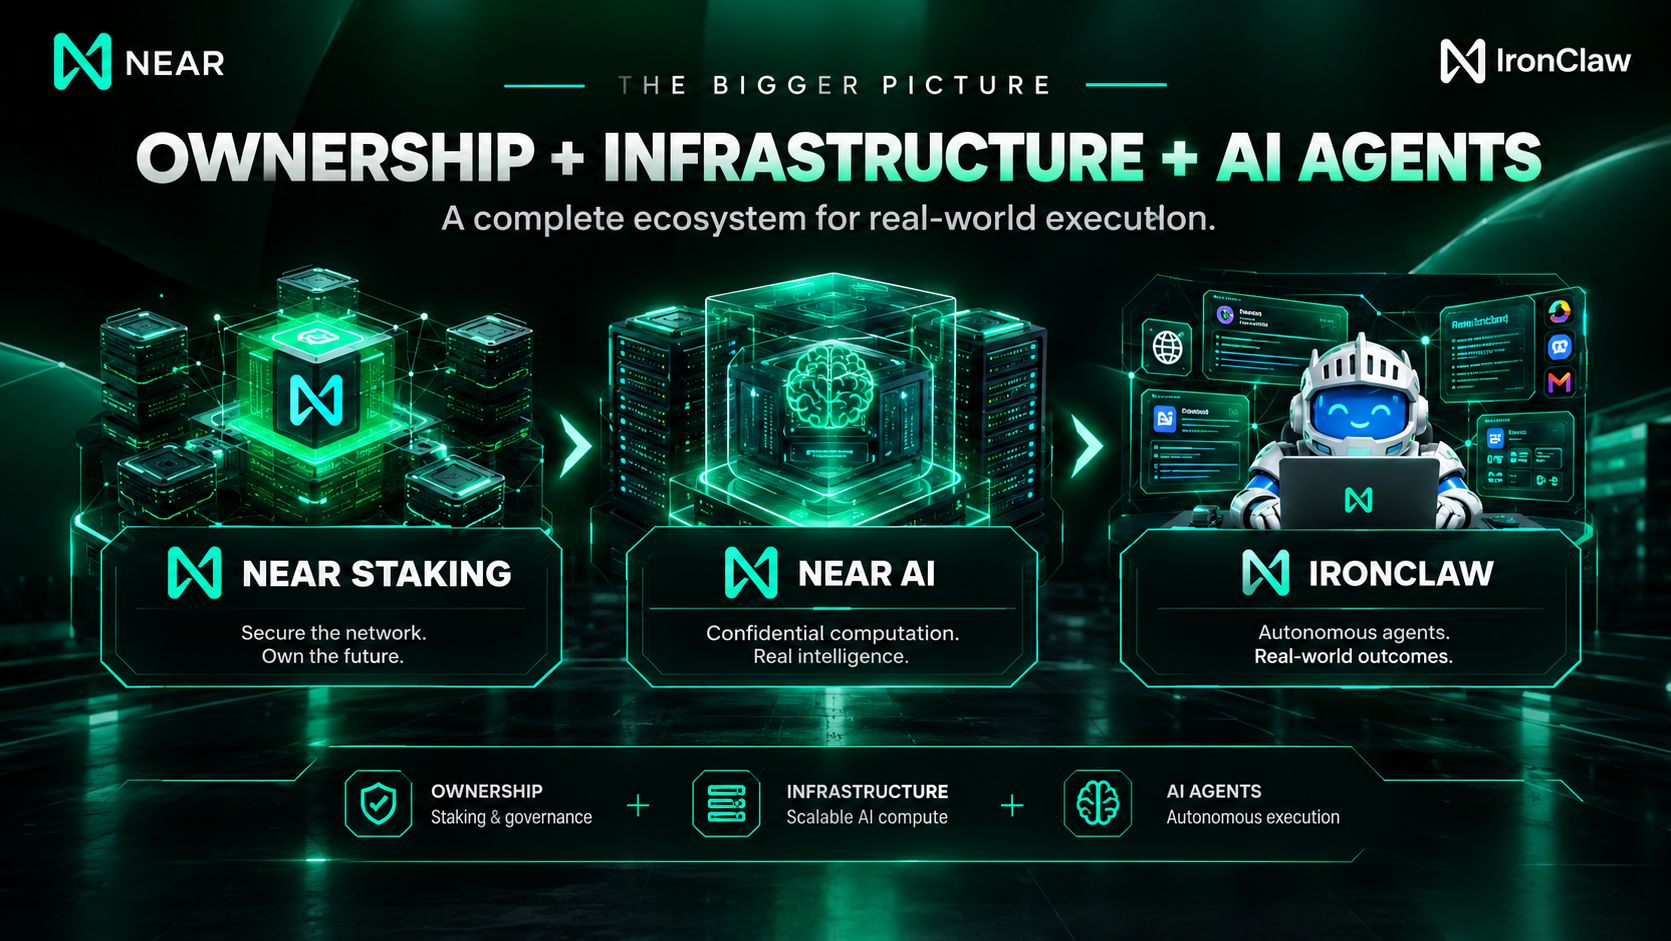
NEAR AIは、Trusted Execution Environments(TEE)による機密推論を含む、プライベートで検証可能なAIインフラストラクチャの開発に取り組んでいます。
そして、ステーキングがその全体像の一部になってきています。
NEAR AIでは、ユーザーがNEARをステークして、機密推論とIronClawエージェントのホスティングのためのクレジットを受け取ることができ、同時に基盤となるステークの所有権は維持されます。
だから、NEARのステーキングを利回りの観点だけで見るのは筋が通らないと思います。
インフラ面にも注目点があります。
ステーキングは基盤となるNEARネットワークを保護します。一方で新しいNEAR AIのステーキングモデルは、その経済的なコミットメントをAIサービスへのアクセスと結びつけます。
この開発の中で私が最も興味深いのは、まさにそこです。
AIは考える力がますます上がっています。
そして、私たちはそれが行動できるようにする仕組みを構築しています。
次の課題は、ユーザーが依然として有意義なコントロールを持てる状態で、それを実現できるようにすることです。
IronClaw 1.0は、その課題を解くための興味深い試みの1つです。
AIエージェントがより自律的になるにつれて、何がより重要になると思いますか?
より優れたパフォーマンスか、それとも強力なコントロールか?