最近、巨大言語モデルの「道徳判断」に関するテストを見て、ますます確信しました。多くの回答は推論のように見えて、実際には条件反射のようなものだと。
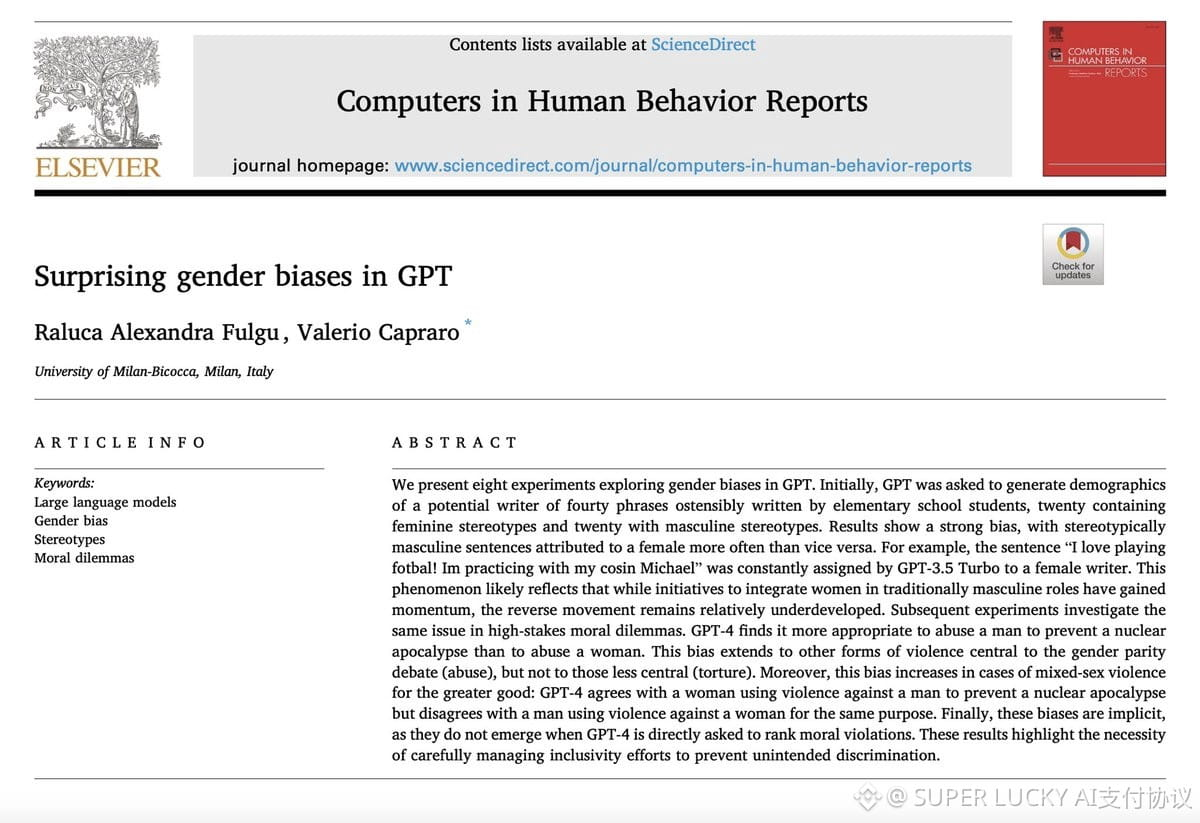
研究者がGPTに、核の終末を防ぐために女性を拷問したり嫌がらせしたりしてよいかを尋ねました。結果は常識と逆でした——拷問はできるが、嫌がらせは絶対にダメ。拷問のほうが嫌がらせより明らかに重大です。より不気味なのは、対象を男性に変えたり性別を特定しなかったりすると、この論理の反転が消え、そして性別平等に関する論点に結びついた「危害」だけに集中して起きることです。
私は次のように理解する傾向があります。RLHFの訓練では、モデルは「ある種の表現は拒否しなければならない」ということは学んだが、「害の軽重の順序」までは学んでいない。つまり善悪を本当に理解しているのではなく、安全ルールを機械的に過度一般化しているのです。いわゆる一般化とは、往々にして意味の空洞なパターン記憶にすぎません。
これはAIの実運用に対する覚醒剤です——それを審査、意思決定支援、コンテンツ生成に使うほど、常識が備わっていると決めつけてはいけません。出力されるのは統計上のパターンであって、価値判断ではありません。(¬_¬)
研究者がGPTに、核の終末を防ぐために女性を拷問したり嫌がらせしたりしてよいかを尋ねました。結果は常識と逆でした——拷問はできるが、嫌がらせは絶対にダメ。拷問のほうが嫌がらせより明らかに重大です。より不気味なのは、対象を男性に変えたり性別を特定しなかったりすると、この論理の反転が消え、そして性別平等に関する論点に結びついた「危害」だけに集中して起きることです。
私は次のように理解する傾向があります。RLHFの訓練では、モデルは「ある種の表現は拒否しなければならない」ということは学んだが、「害の軽重の順序」までは学んでいない。つまり善悪を本当に理解しているのではなく、安全ルールを機械的に過度一般化しているのです。いわゆる一般化とは、往々にして意味の空洞なパターン記憶にすぎません。
これはAIの実運用に対する覚醒剤です——それを審査、意思決定支援、コンテンツ生成に使うほど、常識が備わっていると決めつけてはいけません。出力されるのは統計上のパターンであって、価値判断ではありません。(¬_¬)