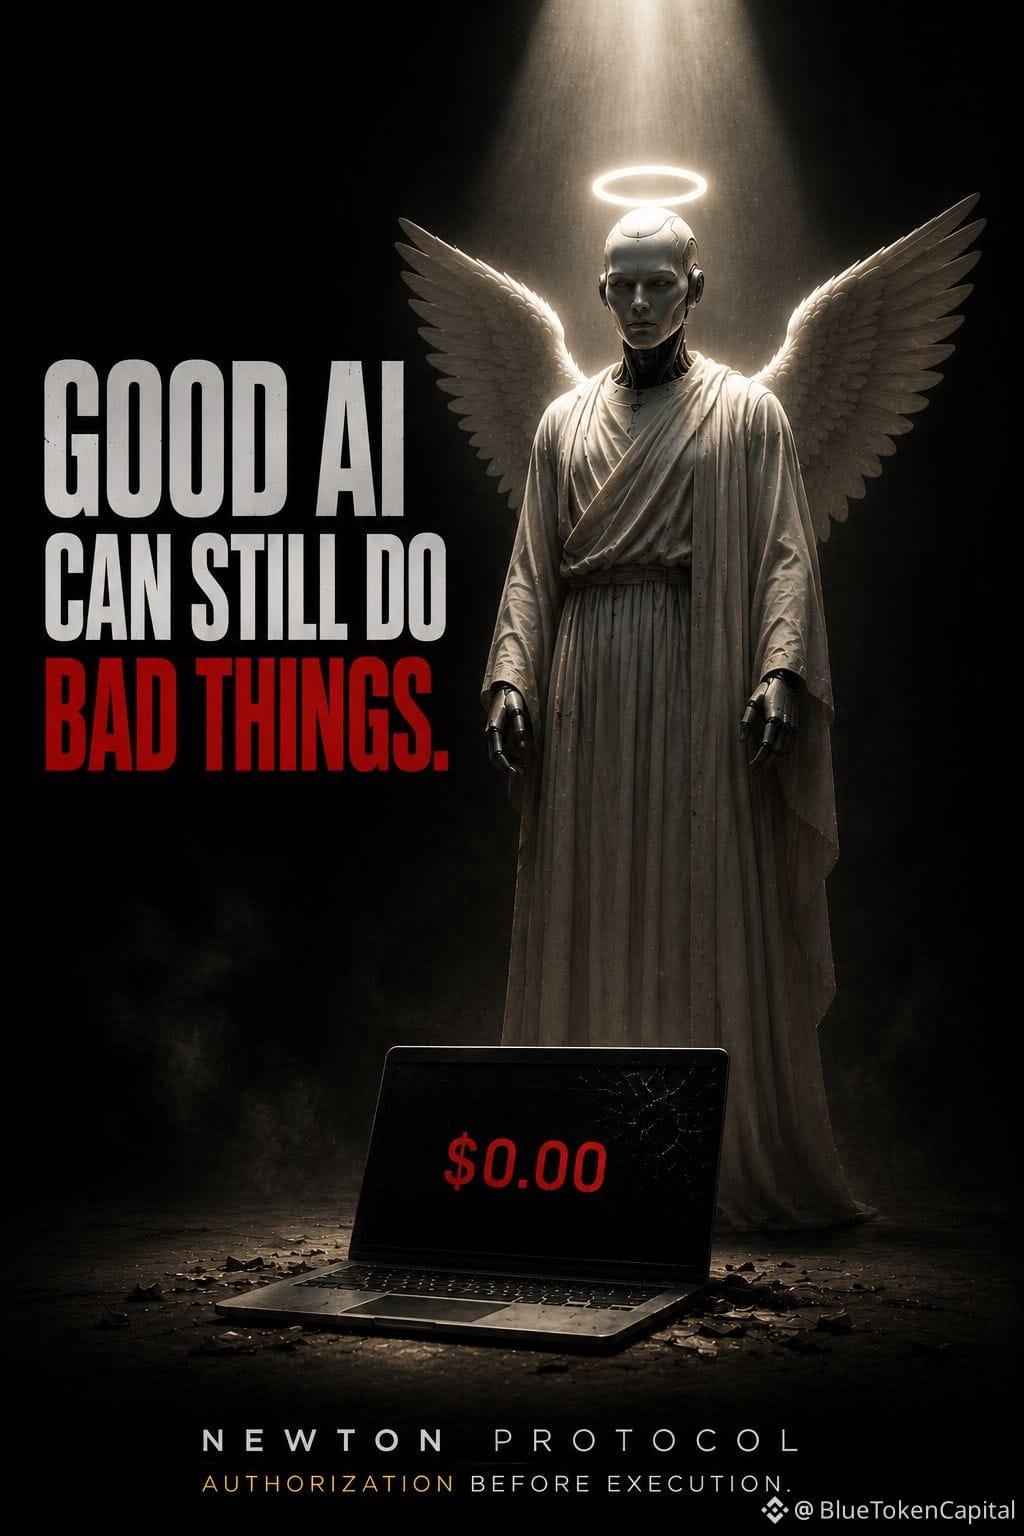
🚨 優れたAIでも、悪いことはできます。
矛盾しているように聞こえます。
しかし、それがAIネイティブな金融における決定的な課題の1つになるかもしれません。
多くの人は、最大のリスクは悪意あるAIだと考えています。
私は違うと思います。
より大きなリスクは、優れたAIが悪い方針を完璧に実行してしまうことです。
AIには倫理がわかりません。
結果も理解しません。
正しい/間違っていると判断するわけでもありません。
与えられた権限、目的、ポリシーを、ただ実行するだけです。
だからこそ、高度に知能を持つAIでも、失敗したからではなく、正確に“許可されたこと”を実行しただけで、破滅的な金融判断を下し得ます。
だからこそ、この会話は方向転換が必要だと私は考えます。
「どうすれば、より賢いAIを作れるのか?」ではなく
「どうすれば、より良い認可(オーソライゼーション)を作れるのか?」を問うべきです。
🛡️ まさに@NewtonProtocol が際立つのは、この点です。
$NEWT は、人間の判断をAIで置き換えようとしているのではありません。
AIネイティブな金融のための認可レイヤーを構築し、AIエージェントが無制限の権限ではなく、プログラム可能で検証可能な境界の中で動作するようにしているのです。
実行前の認可(Authorization Before Execution)により、あらゆるAIアクションは実行前に、あらかじめ定義されたポリシーに照らして評価されます。
プログラム可能な権限によって、開発者や組織は、AIがアクセスできる資産、連携できるプロトコル、支出限度、実行条件、そして資本が動く前に必要な承認要件を、正確に定義できます。
さらに、ポリシーエンジン、AIエージェントの認可、そして検証可能なポリシー執行を組み合わせることで、Newtonは“手作業の判断”を“プログラム可能なインフラ”へと変え、信頼を実装可能なものにします。
これは根本的な転換です。
将来、最も安全なAIは「最も賢いAI」ではないからです。
「自分ができること――そしてできないこと」を理解しているAIが、安全になります。
🤔 AIが、設計どおりにすべてのルールを完全に守ったとしても、それでもあなたのポートフォリオを丸ごと消し去ってしまったら…本当に責任があるのは誰でしょう?
AI?それとも開発者?それともルールを書いた人?
選べるのは“1つだけ”です。
#Newt
矛盾しているように聞こえます。
しかし、それがAIネイティブな金融における決定的な課題の1つになるかもしれません。
多くの人は、最大のリスクは悪意あるAIだと考えています。
私は違うと思います。
より大きなリスクは、優れたAIが悪い方針を完璧に実行してしまうことです。
AIには倫理がわかりません。
結果も理解しません。
正しい/間違っていると判断するわけでもありません。
与えられた権限、目的、ポリシーを、ただ実行するだけです。
だからこそ、高度に知能を持つAIでも、失敗したからではなく、正確に“許可されたこと”を実行しただけで、破滅的な金融判断を下し得ます。
だからこそ、この会話は方向転換が必要だと私は考えます。
「どうすれば、より賢いAIを作れるのか?」ではなく
「どうすれば、より良い認可(オーソライゼーション)を作れるのか?」を問うべきです。
🛡️ まさに@NewtonProtocol が際立つのは、この点です。
$NEWT は、人間の判断をAIで置き換えようとしているのではありません。
AIネイティブな金融のための認可レイヤーを構築し、AIエージェントが無制限の権限ではなく、プログラム可能で検証可能な境界の中で動作するようにしているのです。
実行前の認可(Authorization Before Execution)により、あらゆるAIアクションは実行前に、あらかじめ定義されたポリシーに照らして評価されます。
プログラム可能な権限によって、開発者や組織は、AIがアクセスできる資産、連携できるプロトコル、支出限度、実行条件、そして資本が動く前に必要な承認要件を、正確に定義できます。
さらに、ポリシーエンジン、AIエージェントの認可、そして検証可能なポリシー執行を組み合わせることで、Newtonは“手作業の判断”を“プログラム可能なインフラ”へと変え、信頼を実装可能なものにします。
これは根本的な転換です。
将来、最も安全なAIは「最も賢いAI」ではないからです。
「自分ができること――そしてできないこと」を理解しているAIが、安全になります。
🤔 AIが、設計どおりにすべてのルールを完全に守ったとしても、それでもあなたのポートフォリオを丸ごと消し去ってしまったら…本当に責任があるのは誰でしょう?
AI?それとも開発者?それともルールを書いた人?
選べるのは“1つだけ”です。
#Newt