#opg $OPG 私は「DeAI」分野が、コストのかかるマーケティング施策へと堕落していくのを見てきました。チームは分散型推論を約束しますが、実際には単にリクエストをWeb2のAPIへ流し、さらにERC-20トークンを雑に後付けして話題づくりをしているだけです。空虚なループです。
@OpenGradient は違って感じます。彼らは計算のボトルネックに取り組んでいるからです。従来のチェーンでは、すべてのノードがトランザクションを再実行することを強いられます。これを70BパラメータのLLMでやったら、ネットワークは死にます。
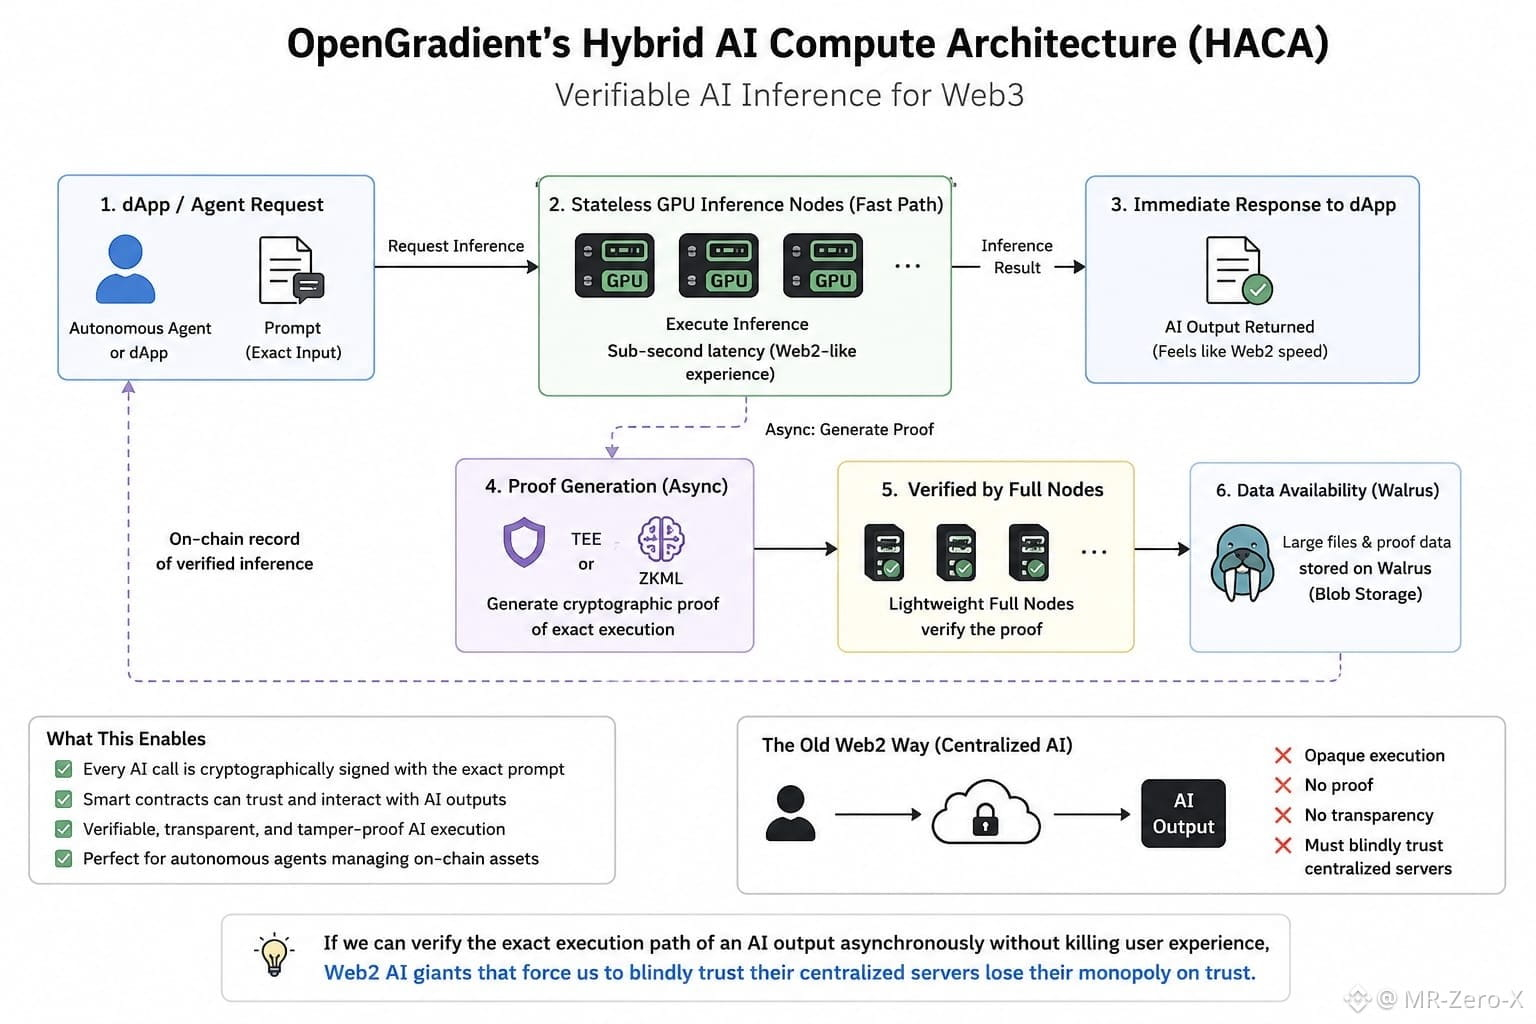
彼らのHybrid AI Compute Architecture(HACA)は負荷を分割します。dAppが推論を要求すると、サブ秒のWeb2のような低遅延で、ステートレスGPU推論ノードへ直接送られます。非同期に、そのノードが暗号学的な証明(TEEまたはZKML)を生成し、それを軽量なフルノードが検証します。重いファイルはWalrusのブロブストレージへオフロードされます。
これにより、自律エージェントのための世界が変わります。透明性のないオラクルをただ盲目的に信じて資金運用の指示を出すのではなく、モデル呼び出しのたびに、実際に使われた正確なプロンプトが暗号学的に署名されます。機械学習を、スマートコントラクトがネイティブに扱える検証可能なプリミティブへと変えるのです。
私は、重い同時負荷のもとでピーク時の交通量にどう対処するかを見ていますが、構造的な土台は実は「ノイズよりユーティリティ」を優先するために作られています。
AI出力の実行経路を、ユーザー体験を壊さずに非同期で正確に検証できるなら、私たちに中央集権的なサーバーを盲目的に信じさせるWeb2のAI巨人たちはどうなるのでしょう?
@OpenGradient #opg
@OpenGradient は違って感じます。彼らは計算のボトルネックに取り組んでいるからです。従来のチェーンでは、すべてのノードがトランザクションを再実行することを強いられます。これを70BパラメータのLLMでやったら、ネットワークは死にます。
彼らのHybrid AI Compute Architecture(HACA)は負荷を分割します。dAppが推論を要求すると、サブ秒のWeb2のような低遅延で、ステートレスGPU推論ノードへ直接送られます。非同期に、そのノードが暗号学的な証明(TEEまたはZKML)を生成し、それを軽量なフルノードが検証します。重いファイルはWalrusのブロブストレージへオフロードされます。
これにより、自律エージェントのための世界が変わります。透明性のないオラクルをただ盲目的に信じて資金運用の指示を出すのではなく、モデル呼び出しのたびに、実際に使われた正確なプロンプトが暗号学的に署名されます。機械学習を、スマートコントラクトがネイティブに扱える検証可能なプリミティブへと変えるのです。
私は、重い同時負荷のもとでピーク時の交通量にどう対処するかを見ていますが、構造的な土台は実は「ノイズよりユーティリティ」を優先するために作られています。
AI出力の実行経路を、ユーザー体験を壊さずに非同期で正確に検証できるなら、私たちに中央集権的なサーバーを盲目的に信じさせるWeb2のAI巨人たちはどうなるのでしょう?
@OpenGradient #opg