OpenLedgerを始めた時のことを話そう。最初の読みを完全に見直さなければならなかった理由だ。
最初に見たとき、直感はシンプルだった。AI企業はデータを無断で使っていた。OpenLedgerは貢献者に報酬を支払うためのインフラを構築している。公正な報酬、オンチェーンでの帰属、自動的な支払いフロー。クリーンなストーリーだ。理解しやすい。
それが全てのテーマだと思って2週間考えた。
それから、全てを変える糸を引き始めた。
支払いのナラティブはリアルだ。しかし、OpenLedgerが解決している最も重要なことではない。
これが私が言いたいことだ。
私は、機関の採用が実際にどのように機能するかを知っているほど、企業技術のサイクルを経験してきた。誰かが公正さについてのホワイトペーパーを発表したからといって実現するわけではない。報酬モデルが洗練されているからといって実現するわけでもない。企業は、法務部門が動かないコストが変更するコストを上回ると伝えたときに動く。
そこで、別の質問を始めた。
「公正なデータ報酬から誰が利益を得るのか?」ではなく、
「発見の過程でトレーニングデータに関する基本的な質問に答えられない場合、誰が訴えられそうなのか?」
その質問の答えは、非常に大きな企業の非常に長いリストだ。
今、AI訴訟で実際に何が起こっているのか考えてみてほしい。
ニューヨーク・タイムズのOpenAIに対する訴訟は、実際にはお金の問題ではない。発見の問題だ。裁判に進むと、弁護士たちは非常に具体的な質問をする。どの記事が使用されたのか?何回使用されたのか?トレーニングにおいてどのくらいの重みを持っていたのか?ライセンス条件が違反されたのか?
これらの質問には答えが必要だ。そして、クリーンに答えられない企業、つまり自分たちのモデルをトレーニングしたデータやその出所を本当に知らない企業は、検証可能な帰属の連鎖を提供できる企業とは異なる種類のリスクに直面する。
ここでOpenLedgerは「クリエイターに公正に支払う」という話から、より構造的に重要なものに変わる。
帰属証明は、根拠のあるインフラだ。どのデータが使用され、どのようにモデルの出力に影響を与え、誰がそれに貢献したのかを記録する暗号化された記録を作成する。その記録は、貢献者に支払うためだけに役立つものではない。
それは法的防御だ。
私がしばらくの間向き合うのに時間がかかったことについて正直に言いたい。
この技術を最も必要としている企業は、最もそれを採用することに抵抗を示している企業だ。
OpenAI、Google、Anthropic、Meta—これらの企業は、現在のデータプラクティスが防御可能であることを主張するために特別に設計された法務チームを持っている。彼らは、コスト構造を増加させ、トレーニングデータに関する明示的な記録を作成する帰属インフラを自発的に採用することはない。
彼らは、裁判所がそうするように指示したときにそれを採用するだろう。または、規制当局が開示を義務付けたときに。あるいは、透明性の欠如による訴訟コストが透明性の運営コストを上回ったときに。
その瞬間はまだ訪れていない。
しかし、私は十分な規制サイクルを見てきたので、それがどう終わるかを知っている。ゆっくり、そして一気に。タバコ産業は何十年も戦ってきた。そしてその後、戦わなくなった。
「のための質問は、$OPEN その瞬間が来るかどうかではない。
むしろ、OpenLedgerが運用可能で、証明され、十分なワークフローに組み込まれる前に、企業が移動を余儀なくされたときに、移動できる信頼できる場所があるのかどうかだ。
今、私はトークンの価格の代わりに何を見ているか。
企業のパイロット。発表ではなく、実際の組織がリアルなワークフローで帰属インフラをテストしている実際のパイロットだ。
法務チームの問い合わせ。AI企業の調達プロセスが「データの出所確認」を要件として含み始めたとき、それが信号だ。
規制の言葉。EU AI法や米国の立法が「検証可能な出所」や「監査可能なトレーニングデータ」といった言葉を使用するたびに、それは暗号市場のサイクルを気にしない追い風だ。
これらの信号はまだ叫び声を上げていない。
しかし、彼らはささやいている。そしてインフラにおいて、ささやきは誰も期待しないうちに轟音に変わる傾向がある。
私は見守る体制を整えている。$OPENのトークン経済が必要とするタイムラインで実現するかどうかは完全には確信していない。しかし、私は注意を払うのをやめられないほど確信している。
企業のAIが帰属インフラを実際に採用していることに自信を持たせるのは何だと思う?ただの議論ではなく、実際のことが起こっていると。
@OpenLedger $OPEN #OpenLedger

記事
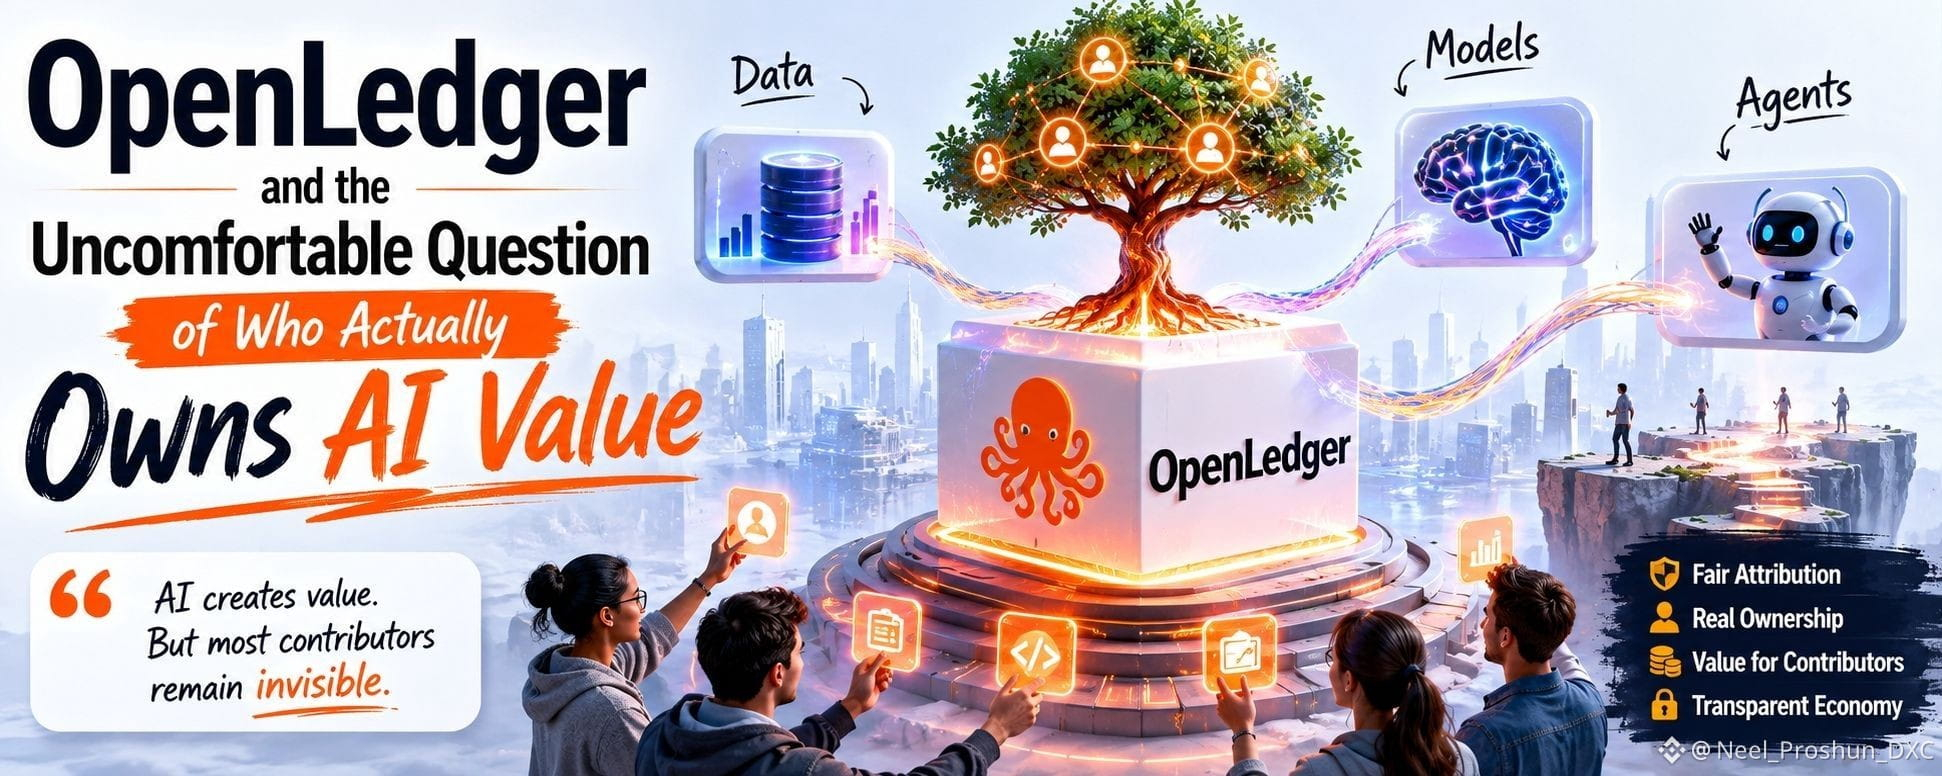
私はOpenLedgerがクリエイターに報酬を支払うことについてだと思っていた。実際に何を解決しているのかについては間違っていた。