
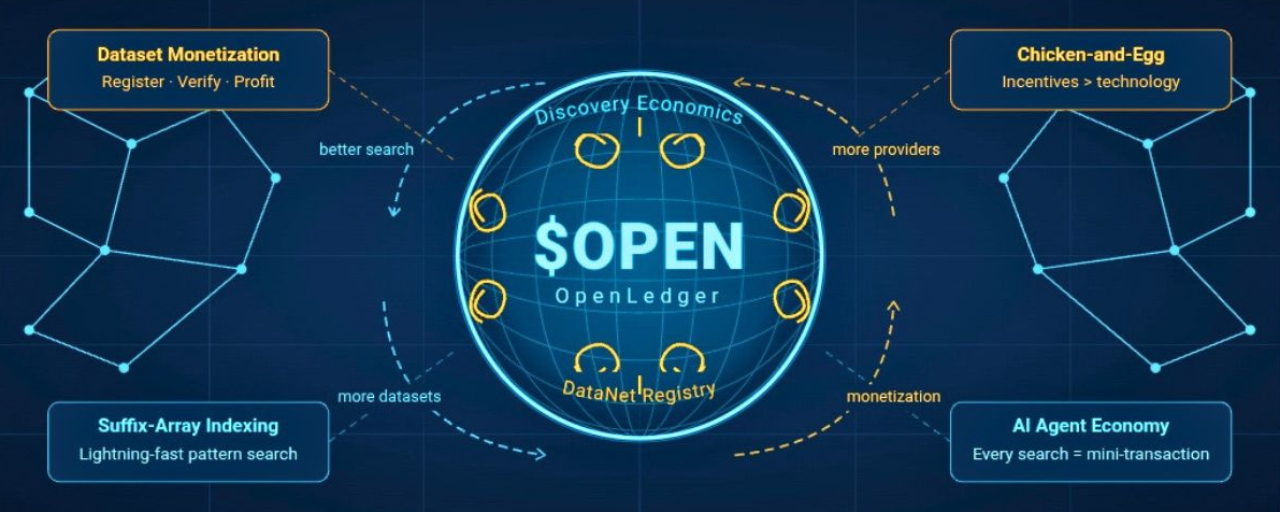


私が初めてOpenLedgerのDataNet Registryを開いたとき、また別のAIインフラストーリーだと思っていました。しかし、実際にはデータベースについて考えさせられました。
通常、人々がAIインフラについて話すとき、モデルのことを耳にします。大きなモデル。迅速な推論。派手な結果。しかし、AIシステムを静かに作り上げたり壊したりするのはモデルではなく、裏でデータをどのように整理するかです。
私が見る限りの違いは、OpenLedgerが重視しているのは発見であり、単なるストレージではないということです。
実際のデータではなく、ただ…それを見つける方法だ。
その違いは、多くの人が理解している以上に響く。
見れば見るほど、発見経済学のように感じる。データを見つけることが保存するよりも価値を持つようになるという考え。
私が本当に引き寄せられたのは、サフィックスアレイスタイルのインデックスが彼らのアーキテクチャに組み込まれているのを見たときだ。もしサフィックスアレイについて詳しくないなら、私は数年前に検索最適化をいじっていて偶然それを見つけた。前提はシンプルだが、ちょっとクレイジーで、情報を整理してパターンを見つけるのがスムーズにできるようにする。
技術的には聞こえるが、実際の影響は経済的だ。
AIエージェントが独自に動き回るようになると、全ての検索がミニトランザクションになる。検索にかかる余分な秒数は摩擦だ。行き止まりの検索?無駄な計算、無駄なエネルギー。エージェントが大規模に意思決定を始めると、その小さな非効率が狂ったように積み重なり始める。
その時にDataNetレジストリが私にとって興味深くなった。
単にデータセットを静的ファイルとしてインターネットに放り投げるのではなく、それらを発見し、さらにはマネタイズできる資産のように扱う。システムはそれらを引き出しにしまうのではなく、登録、検証、発見、そして場合によってはデータセットから利益を得るための構造化されたレールを提供する。すべてを一カ所にまとめて。
検索効率の向上はエージェントの生産性を高める。生産性の高いエージェントは、より多くのデータセットを消費する。データセットの使用が増えることでマネタイズの機会が生まれ、追加の供給者を引き付けてネットワークを強化する。これが、私が発見経済学と呼び始めた基本的な論理だ。
正直なところ、振り返ってみると、発見のレイヤーは実際のコンテンツを覆い隠す傾向がある。検索エンジンはウェブサイトよりも大きくなった。アプリストアはほとんどの個別アプリを超えた。マーケットプレイスは、人々が必要とするものと提供するものをマッチさせる手間を削減するために勝つ。
AIのデータセットでもそれが起こるかどうか、ずっと考えている。特に今の状況が変わっていることを考えると。
市場がインフラの話に戻っているのを感じる。AIが注目を集めているのは間違いないが、投資家はただの派手なモデルではなく、それを支えるパイプや配管にもっとこだわっているようだ。クリプトも同じようなローテーションを経験してきた:最初はアプリに対する狂った興奮…その後、皆がその下にあるレールを追いかける。
時々?その第二段階は第一段階よりも遥かに多くの価値を掘り起こす。
データネットワークはこの厄介なブートストラップの問題に直面している。レジストリは、十分な魅力的なデータセットが内部に存在する場合にのみ機能する。そして魅力的なデータセットは、発見とそれからの利益獲得が既に機能している場合にのみ現れる。
完全に鶏と卵の関係だ。
クリプトはこれにいつもつまずいている。流動性プール、オラクルネットワーク、分散ストレージなど、すべて同じ頭痛の変種にぶつかる。
技術よりもインセンティブが重要だ。
美しいレジストリ?それが人々を引き寄せるとは限らない。人々はデータを共有する実際の理由、クリーンに保つ理由、システムを信頼する理由を求めている。そうでなければ、無駄な情報のための派手な棚を持っているだけで、デジタルのゴーストタウンだ。
正直なところ、それが私がまだ格闘している部分だ。
アーキテクチャはクールで、古典的なコンピュータサイエンスと新しいブロックチェーンインセンティブのレシピが組み合わさっている。しかし、歴史は私に思い出させる:技術的な輝きと現実世界での持続可能性は常に一緒に現れるわけではない。
実際の火花はインデックスの魔法ではなく、発見可能性自体がAIのためのネイティブな経済的推進力になることなのかもしれない。
あるいは、実際には、単なる煙と鏡かもしれない。
正直なところ、私たちはまだ初期段階にいるように感じる。本物のインフラとただのインフラの衣を着た物語を見分けるのは難しい。
経済はデータセットの質がデータセットの量と共にスケールする場合にのみ機能する。成長だけでは不十分だ。
おそらく、発見経済学が本当にテストしているのは、データに価値があるかどうかではなく、発見可能性が独自の市場になるかどうかだ。
発見可能性が独自の経済レイヤーになると、DataNetレジストリがデータセット自体よりも重要になる可能性がある。そうでなければ、誰も使わない別のレジストリだ。
