

人工知能(AI)が大爆発を迎えた今日、あなたは一つの疑問を考えたことはありますか。私たちが与えているのは、万人に恩恵のあるテクノロジーの未来なのか、それとも少数のテック・ジャイアントによる超独占なのか?
現在、AIの発展は大きく3つの中核要素に高度に依存しています。計算能力、アルゴリズム、そしてデータです。しかし、高品質なデータは次第に、中央集権的な巨大企業によって高い壁が築かれ、囲い込まれていっています。開発者にとっては、クリーンで高品質、かつコンプライアンスを満たすAI学習データを入手することが、ますます難しくなっています。
まさにこの「データの孤立」と独占の行き詰まりを打ち破るために、OpenLedger(オープン・レジャー)が誕生しました。これは単なる技術アーキテクチャではなく、AI時代のデータ主権と分散協調に関する、破壊的な革命です。$OPEN
OpenLedgerとは何ですか?
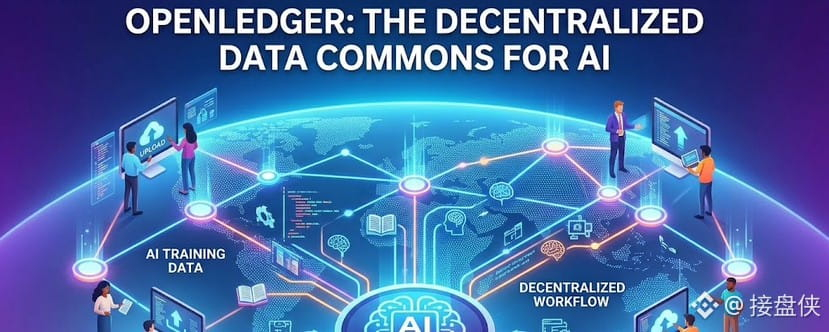
簡単に言えば、OpenLedger は人工知能のために設計された、分散型の「データコモンズ(Data Commons)」ネットワークです。#openledger
それは、ブロックチェーン技術の改ざん不可能性、トークンによるインセンティブ・メカニズム、そしてプライバシー保護型コンピューティングを活用することで、安全で透明、かつスケーラブルな分散型データ基盤(DePIN)を構築しています。OpenLedger のエコシステムでは、データはもはや巨大企業のサーバーにロックされた“私有財産”ではなく、世界中の貢献者が共同で構築し、収益を分かち合うデジタル資産になります。#OpenLedger
コアとなる使命は非常に明確です。高品質なAIデータの流れを動かすと同時に、データ提供者の権利を絶対的に尊重することです。
核心的な強み:OpenLedger は何で AI エコシステムを変えるのか?
OpenLedger がテクノロジー業界やWeb3領域で注目されているのは、従来のAIデータ供給チェーンにおける中核的な課題を解決するからです:
高品質な分散型データパイプライン(Data Pipeline):従来のデータ収集はノイズだらけで効率も低いものです。OpenLedger は分散型のワークフローによって、データの収集・クリーニング・ラベリング・検証と配布を、世界中のユーザーと自動化ノードに分担します。この「クラウドソーシング+AI」のモデルにより、非常に低コストかつ高いスピードで、大規模言語モデル(LLM)学習に適した高品質データセットを生み出せます。
絶対的なデータの権利確定とトレーサビリティ:OpenLedger では、データへのあらゆる貢献、更新、利用が、ブロックチェーン台帳に永続的に記録されます。つまり、あなたが提供した各データにデジタルの「身分証」が付くということです。AIモデルが学習時に誰のデータを使ったのかが一目瞭然になり、根本から知的財産権とコンプライアンス上の紛争を解決します。
データ貢献者の「主権の復権」とインセンティブ:過去には、私たちがSNSやインターネット上で生成した行動データが、巨大企業に“無料で”AI学習に使われていた一方で、私たちは一銭も得られませんでした。しかし OpenLedger では、「データは資産」です。ユーザーがデータを提供したり、データのラベリングに参加したり、検証ノードを運用したりすることで、エコシステムのトークン報酬が得られます。あなたは、自分のデータの真の所有者になります。
プライバシーとセキュリティの完璧なバランス:ゼロ知識証明(ZKP)などの最先端暗号技術を導入することで、OpenLedger は、ユーザーの元のプライバシーデータに直接触れることなくAIモデルを学習可能にします。これにより、医療や金融などプライバシーに極めて敏感な業界にもAI導入の扉が開かれます。
それはどのように機能するのでしょうか?
OpenLedger 的生态运行逻辑は、以下の3つのステップに簡略化できます:
供給とクリーニング(Supply):データ提供者(個人または組織)が元データをアップロードし、分散型ノードがデータをクリーニングしてノイズを除去します。
検証と保管(Validate & Store):検証者ノードがデータの品質を審査し、その真正性と適法性を確認したのち、安全に配布し、分散型ストレージネットワークに保管します。
消費と学習(Consume):AI開発者や研究機関がトークンを支払うことで、これらの高品質なデータセットにアクセスし、モデルの学習や微調整に活用します。
これは完璧なクローズドループのエコシステムです。データが豊富になるほど、より多くのAI開発者を惹きつけます。開発者が増えればエコシステムが生み出す価値も大きくなり、それがより多くの人々の高品質データ提供を促します。
なぜ今が OpenLedger に注目すべき最良のタイミングだと言えるのですか?
2026年、AIは「汎用の大規模モデル」から「垂直領域アプリケーション」の深い水域へと進んでいきます。汎用のインターネットデータはすでに大規模モデルに“食べ尽くされ”つつあります。今後のAI競争で勝負になるのは、独自で、高品質で、コンプライアンスを満たす専門データです。
OpenLedger はまさにこの時代の追い風ど真ん中に位置しています。Web3 に実際に使える導入シーンを提供するだけでなく、AI業界全体に対して、中央集権的な巨大企業に依存しない、完全にオープンソースで分散型の発展ルートを示してくれます。@OpenLedger
未来のAIは、少数の人たちによって定義されるべきではなく、世界中のデータ貢献者によって共に形作られるべきです。OpenLedger が構築しているのは、まさに透明で、公正で、オープンなAI新主権時代です。