


null
5月4日、豆包は有料版をローンチしました。国産AIプロダクトの中で、ユーザー規模が断トツで最大の大規模モデルである豆包の課金は、すぐに「AI無料時代は終わったのか?」という議論を呼びました。
しかし問題が1つあります。ほとんど誰も聞かないのに、かなり重要な問いです。規模を出せたのに、なぜ最初に大々的に課金を打ち出し、かつ客単価を68元スタートのような、決して安くない価格に設定したのでしょうか?
通常のシナリオは逆です。後から走り出して、まだ規模を出せていないプロダクトのほうが、収益化を急ぎます。
実は今回の課金に関するニュースが出る前から、成長ブラックボックスはすでに豆包のプロダクトチームに関する調査を始めていました。この記事では、その内容に基づき回答を試みます。
1
豆包はどれくらい強いのか?
先に言っておきます。私たちはモデル技術やアルゴリズムについて勝手な評価はしません。ここでいう「強い」とは、市場浸透のことを指します。
2026年の第1四半期時点で、豆包の月間アクティブは3.45億。これは概ね国産AIプロダクトの第2〜第4位の合計に相当します[1]。この断トツのリードには、ほぼ余地がありません。
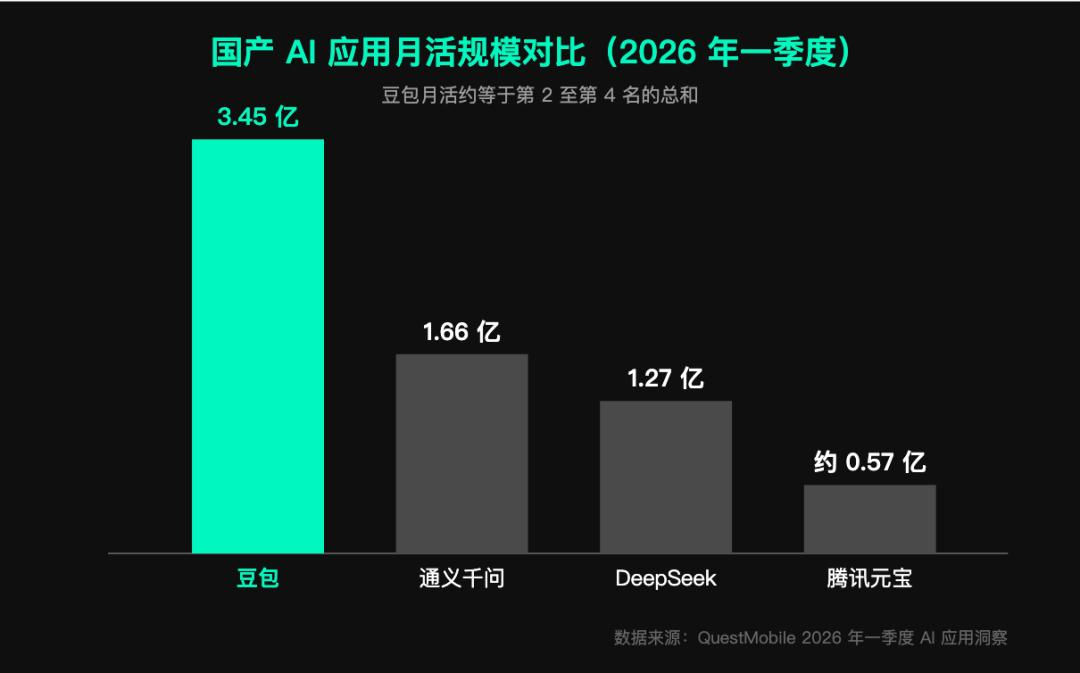
より注目すべきは、それがまだ伸びていることです。ユーザー規模がすでにこれだけ大きいプロダクトでは、通常成長はすぐ減速しますが、豆包はそうなっていません。私たちが把握しているところ、過去1年で豆包のユーザー規模はほぼ倍増に近く、今年初めまで、その毎日の新規ユーザーはなお90万人前後を維持しています。この成長は滑らかな曲線ではなく、減速→急増→落ち込み、そして昨年Q4から再び立て直し(再加速)ていますが、方向性はずっと上向きです。
また、リテンション(継続利用)データも非常に良好です。豆包の新規ユーザーの翌日リテンションは約36%。この点で、Kimi、MiniMax、秘塔、元宝、千問などの汎用AIプロダクトよりも高く、調査で接触した範囲ではこのカテゴリの中で最も高い水準でした。言い換えると、豆包はストック(既存ユーザー)だけで場を保っているのではなく、入ってきた人を継続させられており、基本盤は非常に健全です。
規模よりも語る価値があるのは、豆包ユーザーの「汎化(幅広い層への広がり)」です。
1年前、豆包のユーザープロフィールには明確に初期のAIプロダクトらしい特徴がありました。男性比率は7割を超え、1〜2線都市の若年層に集中。ところが今年年初には、この構造は大きく変わり、男女差は大幅に縮小(男57%:女43%)。さらに4線以下の都市のユーザー合計は約3割で、Kimiなどのプロダクトよりも明確に下沉(より地方・低階層寄り)しています。
変化の方向性を示す細部があります。豆包の音声通話機能の浸透率は4割近くで、この機能は4〜5線の都市で特に人気です。私たちの把握では、これまであまりAIに触れてこなかった中高年層の利用者が、「電話する」という最もハードルの低い方法で豆包に入ってくるケースが増えています。
これは、豆包が「オタク向けのツール」から「国民レベルの生活ツール」へと変わりつつあることを十分に示しています。ただし、この「汎化(幅広い層への広がり)」という硬貨の裏面については、後の章で説明するので覚えておいてください。
見落とされやすいもう1つの側面があります。豆包のユーザーは数が多いだけでなく、使われ方もかなり深い。豆包ユーザーは平均して1日2回以上開き、会話1回あたり往復で6ラウンド以上に及ぶことが多い。ざっくり推計すると、モバイルだけでも毎日の会話量は10億回規模に達します。この利用強度は業界でも非常に先進的で、QuestMobileのデータによると、2026年Q1の豆包の月間人当たり利用回数は54.8回に達し、DeepSeekや千問など同種製品より明確に上回っています[1]。
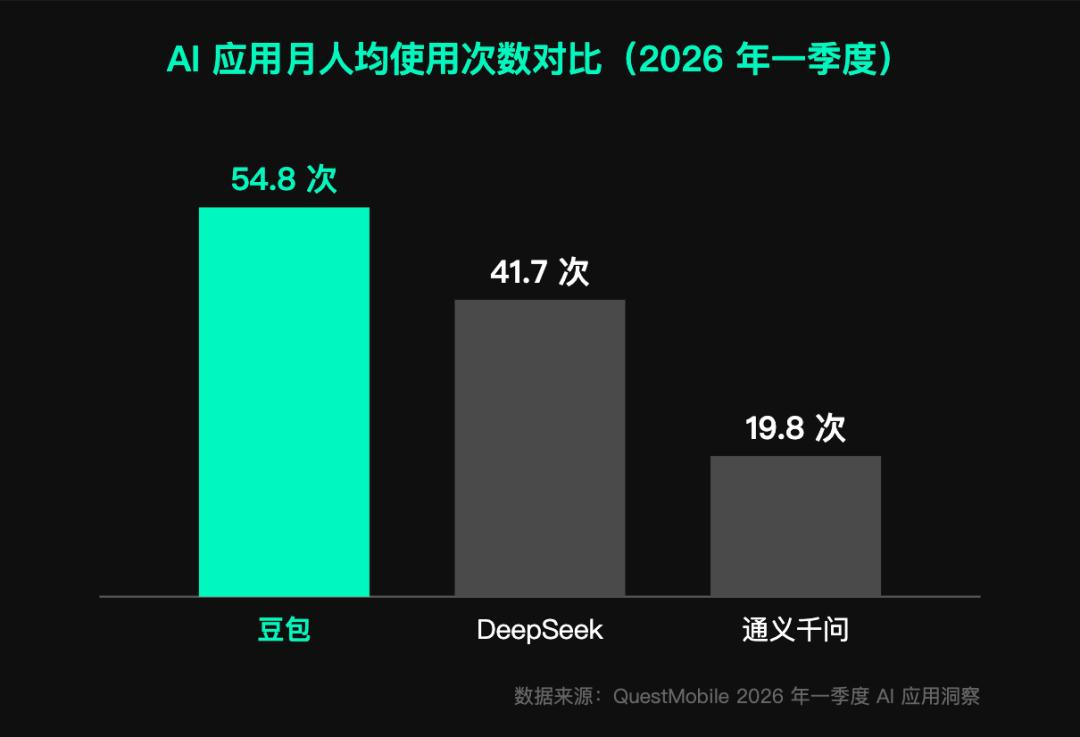
これらを合わせて見ると、豆包のプロフィールはかなり完成度が高い:中国のユーザー規模最大、成長速度最速、粘着性最高、そして最も頻繁に使われているAIプロダクトです。ユーザーの基本盤という観点では、ほぼ最良のカードを手元に握っています。
2
ユーザーは豆包で「聞く」が、豆包で「買う」ことはほとんどない
冒頭の問いに戻りましょう。最大のユーザーデータ盤を抱える製品なのに、なぜ逆に最も急いで課金するのでしょうか?それに答えるには、まず豆包がこれらのユーザーをどうお金に変えるつもりなのかを考える必要があります。
「国民レベルの生活アシスタント」にとって、外部から最も期待され、かつ最も筋が通った収益化ルートは「消費(購買)」です。ロジックはシンプルで、ユーザーが豆包に「用事があるたびに聞く」習慣を身につけると、「どのスマホがいい?」「うちの子に合う粉ミルクはどれ?」のような問いは、会話の中で大量かつ自然に発生します。あとはプラットフォームが、ユーザーが購入を考え始めたその瞬間に、商品と取引を流れに沿って受け止めれば、流量はそのままビジネスになります。社媒コンテンツが大爆発した時代、小红书や抖音が進んでいるのもこのルートです。
私たちも他の情報源から見たところ、2026年4月のデータでは、豆包の回答に出てくる商品カードの転換率がすでに3%以上に達しており、多くの従来型EC広告より高い[2]ことが分かりました。
本来、このルートでの想像できる余地は最大のはずです。しかし意外なことに、豆包はまさにこの道で、いちばんうまく進めていないのです。
豆包内部では、ユーザーのニーズを14の大カテゴリに分けています。成長ブラックボックスの調査によると、「購買消費の意思決定」というカテゴリは9位で、構成比は6%です。そして半年前、この分類すら存在していませんでした。購買関連ニーズがあまりに少なかったため、わざわざ別枠で集計する必要がなかったのです。ゼロから始まり6%まで伸びたとはいえ、伸び率は悪くありませんが、絶対値はずっと小さいままです。
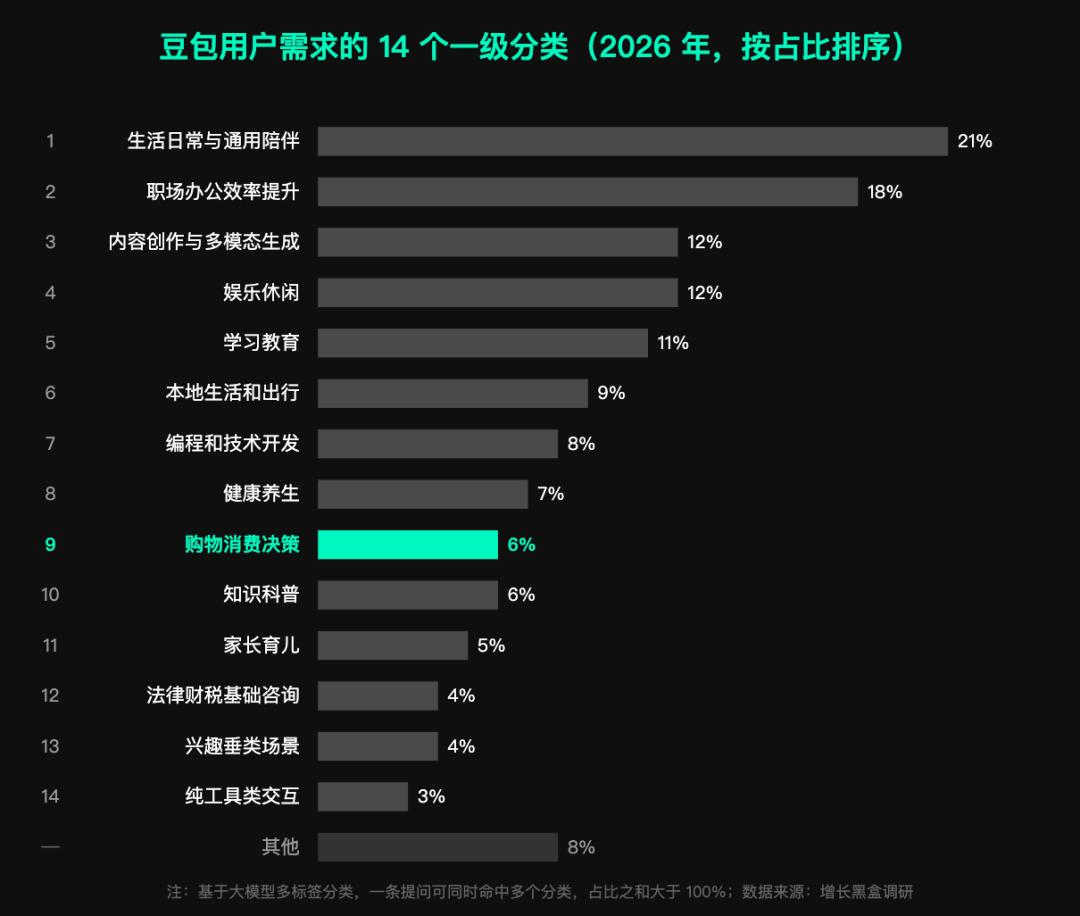
説明しておく必要があります。豆包の分類は、モデルが文脈を総合して判断したもので、さらに1つの質問で複数のタグに同時ヒットすることがあります。そのため、一部の購買意図が「育児」「健康」「生活の日常」など他のカテゴリに分散しています。これらをすべて加味しても、豆包ユーザーのニーズ構造において、消費は主戦場とはとても言えません。
さらに、この6%の内部では、商品比較や購入推奨が全体の約半分、プレゼント提案と予算の組み合わせが約3割。残りはクーポンやキャンペーンのルール解説です。これはかなり「軽い」構造で、ユーザーは相談・比較が中心で、購入の一歩手前で決断するところは少ないのです。
これはつまり、豆包の月間アクティブ3.45億という巨大な流量盤の中で、「買うものがある」という意図を明確に持つユーザーは、ほんの一部だということです。豆包に来る理由は、むしろ質問をしたい、相手がほしい、仕事を処理したい、といったものが中心。購買はそもそも豆包の主戦場ではありません。
これは豆包の欠陥というより、「汎用アシスタント」という定位の自然な結果です。しかし、AIで消費者にリーチしたいと考えるあらゆるブランドにとって、この6%は正面から向き合う必要がある数字です。
実際、すでにブランドが試みています。成長ブラックボックスの調査によると、現状200〜300のブランドが、製品資料を豆包の知識ベースに接続し、ユーザーが質問した際に、より正確に「見つけられる」ことを狙っています。これらのブランドはアパレル、シューズ、日用品、バイク、さらにはITサービスまで複数の業界をカバーしており、規模感は小さくありません。
しかし、私たちが把握している状況では、この連携が現段階でブランドに与える可視化効果はまだかなり限定的です。豆包チーム自身もそれを試験的な探索として位置づけています。これは驚くことではありません。背後には3つの理由があります。
1つ目の理由は「希釈(dilution)」です。豆包の知識ベースの容量はTB単位。つまり、あるブランドが投入する製品資料は、膨大な情報の海の中のわずかな一滴に過ぎないと想像できます。ユーザーの質問が十分に具体的でない限り(年齢、シーン、予算、ニーズなどを正確に示すなど)、ブランド情報が精度高くヒットするのは難しい。一方で、大多数のユーザーの質問はまさに「汎化」されたものです。
2つ目の理由、そして豆包の「能動的な」原則でもあります。豆包は、有料ブランドに対して検索の重みを傾けません。豆包チームの判断は明確です。ユーザーが検索結果が商業利益によって操作されていると感じた瞬間、このプロダクトの信頼性は崩れます。だから、たとえブランドが接続を完了しても、その結果が「強制的に押し込まれる」ことはありません。
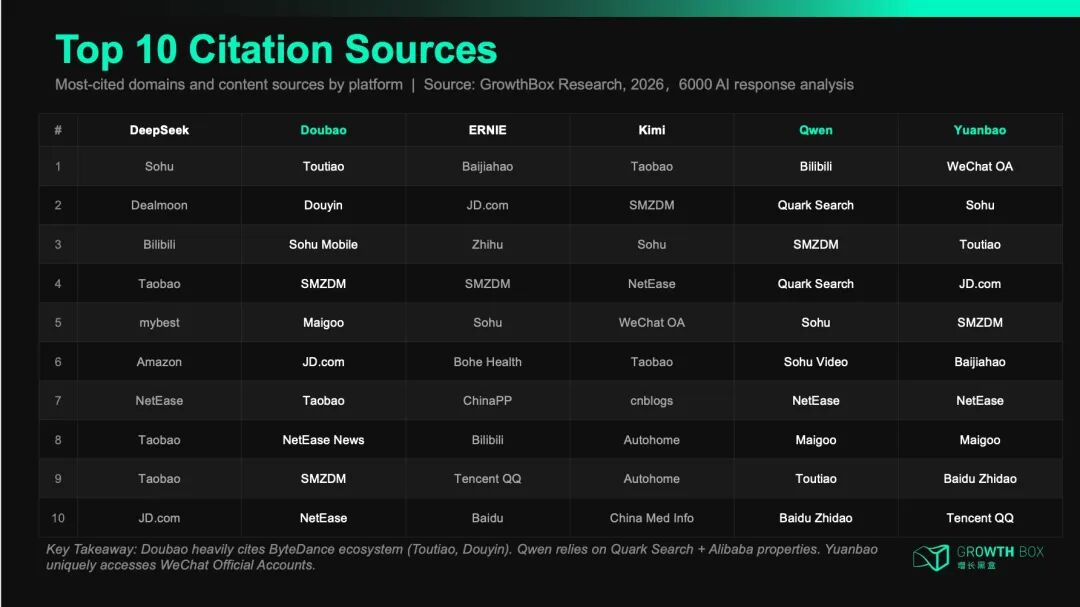
3つ目の理由は、豆包の情報源(信源)構造の中に隠れています。成長ブラックボックスの調査によると、豆包がユーザーの質問に答える際、約85%の情報はByte系の情報源(抖音、今日頭条など)に由来しており、これらの情報源は通常テキスト中心です。たとえ抖音の動画であっても、豆包は現状、タイトル、説明文、カバー画像しか取得せず、動画内容そのものに対して意味解析を行っていません。コストが高すぎ、さらにリアルタイム生成の需要に速度が追いつかないからです。現在、ブランドのマーケティングにはショート動画の形式が多いですが、豆包の現状の情報源構造では、そもそも動画内で何が語られているかを「読めない」わけです。
以前、成長ブラックボックスはある国際的大手日用品メーカーに対して、各種モデルの引用元に関するデータ洞察も行っていました:
3
豆包はByteエコシステムの「流量(トラフィック)中継点」です
ここまでの答えはもうはっきりしています。豆包は最大のユーザーデータ盤を持っているのに、それを消費シーンに変えられていない。原因は豆包のプロダクト能力ではなく、そのプロダクトのポジショニングにあります。
豆包チームは自らの位置づけを3つに分けています。①万能な生活アシスタント、②軽量型の制作ツール、③感情の相棒です。この3つの中に、「消費意思決定の入口」はどれも含まれていません。
Byte(字節)内部では、豆包は「能力の見せ場」や「流量(トラフィック)配分プラットフォーム」のような位置づけです。豆包は即夢や剪映にAIの画像生成・動画制作の能力を披露し、それでユーザーを誘導します。教育やソーシャルなどの縦型ニーズを分化して独立製品(豆包愛学、猫箱などはこうして豆包から分かれて出ています)にし、さらに抖音(Douyin)ECに増分ユーザーを送ります。
つまり、豆包は取引を担うためのものではありません。その役割は「分配(ディストリビューション)」であり、「成約(クローズ)」ではないのです。さらに重要なのは、仮に豆包がECをやりたくても、現状ではクローズドループを作れていない点です。
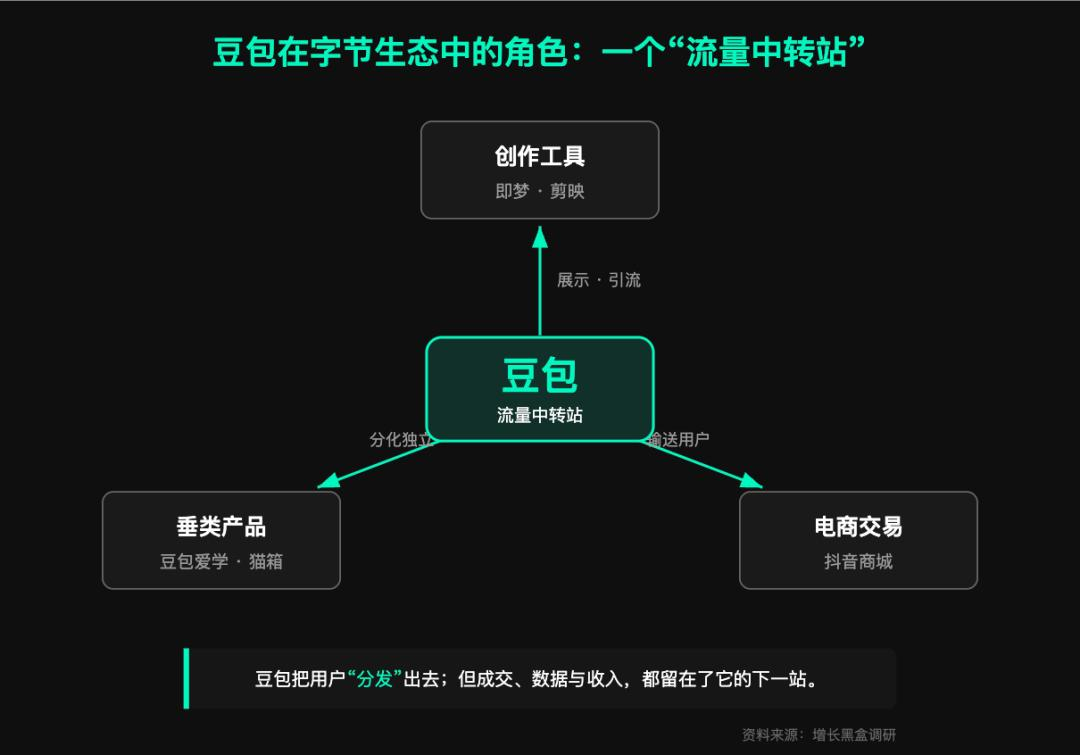
豆包はByteのFlow体系に属し、抖音と組織上は独立かつ並列で、両者のデータは相互に共有されません。ユーザーが豆包から抖音商城へ遷移して成立した取引があっても、そのデータは豆包へは返りません。豆包は以前、小程序の形で抖音のエコシステムに入ろうと試みましたが、継続できませんでした。
結論として、ユーザーが豆包で商品を相談しても、豆包ができる最大は、せいぜい遷移リンクを提示することです。そして発火(リンク提示の発生)確率は極めて低い。全カテゴリの質問のうち商品リンクが出てくる割合は、約0.1万分の1(=0.01%)程度だとされています。つまり、本当の取引は豆包の見えないところ、そして豆包が取り分を得られないところで発生しているのです。
豆包を、他の2社のトップクラス大規模モデルと比べると、この制約の「構造的」な意味がよりはっきりします。
Tongyi Qianwen(通義千問)はAlibabaの支えがあり、アプリ内で淘宝や飛猪に接続でき、ユーザーはそのまま即時に購入できます。
腾讯元宝(テンセントのギフト・ポイント)は微信に依存しており、微信の支払いと連携できます;
そして豆包と抖音ECの間の取引チェーンは、いまもまだつながっていません。
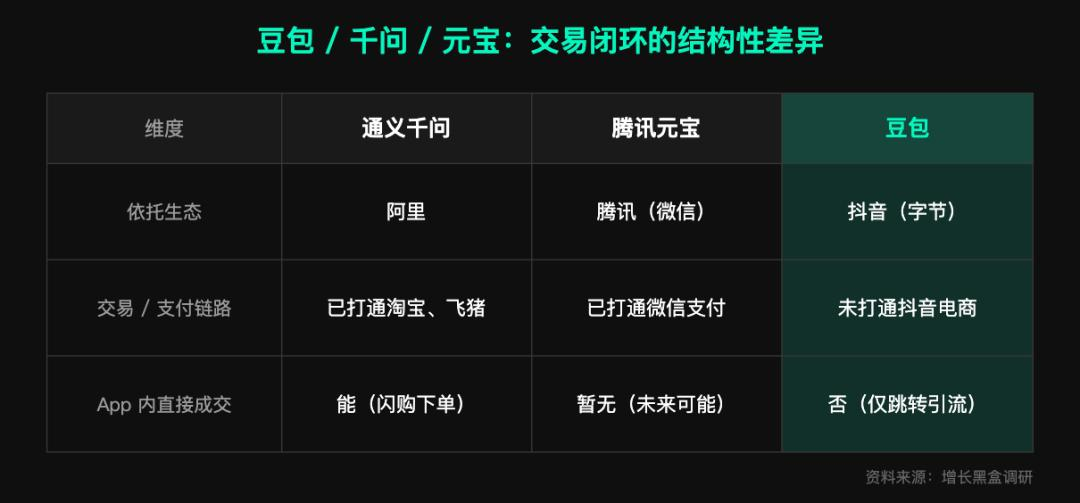
3社の違いの本質は、製品能力の優劣というより、各々の背後にあるエコシステムの「オープン度」が異なることにあります。千問と元宝の「母体」は、取引能力を自社のAIアシスタントに開放します。一方で抖音と豆包の間には、常に1枚の壁があるのです。
4
今回の課金を改めて捉え直す
では、5月4日の課金版宣告にもう一度戻りましょう。
振り返って私たちの調査結果を見ると、豆包チームは実はかなり明確に話していました。豆包が3年目に入って、前半は大量の金を燃やしてきたのに、見合う成果が得られていない。グループ側では明確にROIの評価圧力があり、商業化を推進する必要がある。
このプレッシャーはかなり具体的です。公開報道によれば、豆包大規模モデルの日次平均Token呼び出し量は、2年前のリリース初期から約1000倍に増えています。その背景には、継続稼働するGPUクラスタと、巨額の計算資源コストがあります。さらにByte(字节)跳躍(跳动/抖音側の会社)の2026年のAI投資計画は1600億元規模で、そのかなりの部分がAIチップの調達に投じられます[3]。
言い換えれば、一方では急速に膨らみ続けるコスト、他方ではほとんど無視できるレベルのC端収入。それ以前は、豆包アプリ自体に広告がなく、C端はほぼゼロ収入でした。課金は早晩避けられない、というのは明らかです。
もう1つ注目すべき細部があります。私たちは以前、豆包のシーン別推薦広告は第3四半期に入ってからの開始予定だと聞いていました。しかし第3四半期にまだ達していないのに、5月初めにC端サブスクを先行して打ち出した。この「前倒し」自体が、プレッシャーの重みを物語っています。
ただし、この課金の動きはC端サブスクの道を歩めばすべて解決、という単純な話ではありません。さらに深い理解が必要です。
千問(Qianwen)がECとCPS(成果報酬)コミッションのモデルで、収益化への道のりはほとんど自然にできあがっていました。一方で豆包のC端サブスクは、PPT生成、データ分析、長文書の解析、映像制作といった高い計算リソース消費が必要な専門シーンに対する課金[4]です。豆包がこれらの領域で天然の優位性を持っているかどうかは断言しにくい。しかも、基本のチャット、文章作成、検索は依然無料で、やはり毎日大量の計算リソース消費が発生します。
ここで改めて、先ほど述べた豆包のユーザーストラクチャを見ると、つまり高度に下沉し、急速に汎化し、多くの中高年層が「電話する」という形で入ってくるプロダクトだということが分かります。その結果、実際のユーザー像は「AIに68〜500元の月額を払うつもりの理想ユーザー像」との間に、明確な緊張関係があることは見て取れるはずです。
だからこそ、「68元を結局どれだけ難しく回収できるのか」という問いが、世論の場で本当の疑問符になっているのです。豆包は確かにユーザーに困っていませんが、最も大きなユーザーベースのその部分は、まさに課金意欲が最も強い層ではありません[5]。
また、広く流布している説を1つ訂正しておきます。豆包は「国産初のC端課金モデル」ではありません。文心一言のプロ版は2023年にはすでに課金を開始しています[6]。豆包をより正確に言い表すなら、トッププロダクトの中で、目立つ形で、かつ比較的高い単価(68元から、最高500元/月)でC端のサブスクを打ち出した最初のプレイヤー[7]だということです。
ところが面白いのは、文心一言が2025年4月に再び全面的に無料[6]へ戻したことです。これがある意味で豆包の未来を予言しているのかどうかは分かりませんが。
実際、Byte系にはC端サブスクの経験もいくつかあります。豆包から分化して生まれたソーシャルAIプロダクトの猫箱は、月カード方式で課金していますが、1人当たりの単価はだいたい5角(0.5元)程度です。猫箱と豆包はプロダクト形態が同じではないので、この数字をそのまま当てはめることはできません。ただ少なくとも、Byte系のユーザーベースの上でC端サブスクを本当に規模化して回すのは、簡単なことではないことを示しています。
結 语
豆包が先に課金したことを、商業化でのリードだと言うより、むしろ既存の構造的制約の中で相対的に現実的なルートを選んだ、と捉える方が正確でしょう。なぜなら、ECのクローズドループはエコシステム上の位置関係によって当面は難しいため、サブスクが最も早く通せる道になるからです。
豆包の置かれた状況は、次の2つの言葉で要約できます。ユーザーは最大だが、ユーザー構造が最も「課金的でない」。エコシステムは最も豊富だが、エコシステム内部の「流通」は最も不活発。この月間アクティブ3.45億で中国の国産AI第一を安定的に維持する豆包が、むしろ最も焦っているように見える本当の理由は、ここにあります。
ユーザーがいないわけではありません。ただ、ユーザーを収入に変える「エコシステム上の居場所(ニッチ)」が欠けています。
データ注記:本文中の「成長ブラックボックスの調査によると」「私たちが把握しているところ」の記載は、成長ブラックボックス2026年Q1の豆包プロダクトチームに対する深掘り調査に基づくもので、関連データは調査の定義・枠組みによります。
参考文献
[1] QuestMobile 2026年Q1 AIアプリ洞察:豆包、千問、DeepSeekの月間アクティブはそれぞれ3.4億、1.7億、1.3億に到達。業界のユーザー量とユーザーの粘着性がともに上昇し、競争は後半戦へ|QuestMobile
[2] 豆包が課金に踏み切るなら、私も「千問」を使う!|微信公众号
[3] 豆包が課金テストを開始。DeepSeekは追随するのか? AIアシスタント全面課金のカウントダウン|36Kr
[4] 豆包、課金版を推してきた。Byteはついに堪えきれなくなった?|澎湃新闻
[5] 豆包が有料プランを開始。1か月68元はどれだけ回収が難しい?|新京報
[6] 文心一言は無料、この番はDeepSeekが震えるのか?|36氪
[7] トレンド!豆包が有料版を提供へ。月68〜500元!|证券时报网
本記事は微信公众号「增长黑盒Growthbox」、作者:AI观察组