


翻訳:安全で健全 — STARK セキュリティの詳細
翻訳・校正:「Starknet Chinese Community」
注目のクイックファクト
非対話型 STARK は、確率的オラクル モデルで非対話型証明にコンパイルされた対話型 Oracle Proofs (IOP) から派生しています。
この記事では、ethSTARK ドキュメントの最新の更新について説明し、ランダム オラクル モデルにおける ethSTARK プロトコルのセキュリティの包括的かつ詳細な分析を提供します。
STARKセキュリティの詳しい説明
STARK 証明システム、つまりスケーラブルで透明な知識の議論は、計算の整合性のための強力なツールです。これにより、公開データに対して実行された計算の正確性をトラストレスに検証できます。この記事では、STARK 証明によって提供されるセキュリティを深く掘り下げて定義し、スキームのセキュリティを証明するためのテクニックを探っていきます。
(詳細については、ethSTARK ドキュメント (バージョン 1.2) のセクション 6 と、Block らによるこのトピックに関する重要かつ包括的な独立した研究を参照してください。)
セキュリティ分析で何を達成しようとしているのでしょうか?私たちは、虚偽のステートメントと、その(虚偽の)ステートメントに応じて STARK バリデーターによって受け入れられた STARK 証明によって引き起こされる STARK システムへの「攻撃の成功」を防ぎたいと考えています。虚偽の表示は危険であり、あらゆる規模や形式で発生する可能性があるため、私たちはそれらすべてに対して安全を確保したいと考えています。 1+1=3 のような些細な虚偽のステートメントであっても、STARK バリデーターによって受け入れられた STARK 証明と組み合わせると、システムに対する攻撃が成功したとみなされます。 (暗号化のバックグラウンドを持つ人は、STARK が知識の信頼性などのより強力なセキュリティ概念も満たせることを知りたいと思うかもしれませんが、話を簡単にするために、この記事では信頼性の単純なケースに焦点を当てます)。
STARK システムのセキュリティを正式に定義するにはどうすればよいでしょうか?これは「信頼性誤差」を分析することで判断されます。 「信頼性エラー」は、攻撃者が攻撃を成功させるためにかかると予想される「コスト」を大まかに測定します (つまり、STARK バリデーターによって受け入れられる虚偽のステートメントの STARK 証明を見つける)。数学的に言えば、信頼性誤差は関数 (t) であり、その入力は攻撃者が攻撃を開始するために費やす計算時間を表す時間パラメーター t であり、出力は攻撃者の攻撃が成功する確率 (次のように求められます) です。虚偽の陳述に説得力のある証拠)。攻撃者が費やす「コスト」が大きければ大きいほど、攻撃の成功確率は高くなります。
これまで、STARK のセキュリティを関数 (t) として定義してきましたが、これは仮想通貨 Twitter で毎日セキュリティが議論される方法とは異なります。 Twitter では、「このソリューションには 96 ビットのセキュリティがあります。」という声が聞こえるかもしれませんが、これはセキュリティの定義にどのように反映されるのでしょうか? 「x ビットのセキュリティ」の理解は人によって若干異なるため、これに対する唯一の答えはありません。
厳密に解釈すると、これは、1 から 2⁹⁶ までの任意の t について、信頼性誤差は (t) 2⁹⁶ であることを意味します。 2⁹⁶ 以下で実行する攻撃者の成功確率は非常に低く、2⁹⁶ 未満、つまり 10 億分の 1 の 1 倍未満です。
より緩やかな、そしておそらくより一般的な解釈は、96 ビット セキュリティとは、任意の t について、t/(t) 2⁹⁶ となる場合があることを意味するというものです。これは、成功の確率が実行時間に対して (逆に) 線形であることを意味します。攻撃者の実行時間が 2⁸⁶ の場合、攻撃の成功確率は最大でも 2¹⁰ です。
この記事では、2 番目のオプションについて説明します。
96 ビット セキュリティで IOP から STARK まで
では、ソリューションに 96 ビットのセキュリティがあることをどのように証明すればよいでしょうか?この質問に答えるには、STARK が構築されている高レベルの構造を理解する必要があります。 STARK は、IOP (Interactive Oracle Proof)、マークル ツリー、および Fiat-Shamir ハッシュの 3 つの主要な部分で構成されています。これらのコンポーネント部分を指定したら、それらをコンパイルして STARK を生成できます。これらのコンポーネントが何であるか、どのように組み合わされるかなど、これらのコンポーネントについて詳しく説明します。
最初にレビューするコンポーネントは IOP です。IOP は標準的な対話型証明に似ており、証明者と検証者が複数のラウンドにわたって対話します (公開コイン プロトコルに限定されており、検証者は証明者にランダムなチャレンジのみを送信します)。 IOP では、検証者は証明者のメッセージを完全に読み取るのではなく、各証明者のメッセージからビットのごく一部をサンプリングします。これが、後でコンパイルされた STARK がその単純さを達成する理由です。
IOP を考慮した場合、そこから STARK を構築するにはどうすればよいですか?証明者のメッセージは非常に長くなる場合があります (実際、計算自体よりも長くなることがあります)。この情報を圧縮するために、マークル ツリーを使用します。マークル ツリーは、各リーフ ノードが IOP 内のクエリまたは回答を表すバイナリ ハッシュ ツリーです。根はメッセージ全体の約束です。検証者がメッセージ内の特定の場所を読み取りたい場合、証明者はその場所の値と検証パスを提供します。バリデーターはこのパスを使用して、値が正しいことを検証できます。 IOP バリデーターは証明者情報から少量の位置情報のみを読み取ります。したがって、マークルツリーを用いることで簡潔なプロトコル(通信量の少ないプロトコル)を実現することができる。
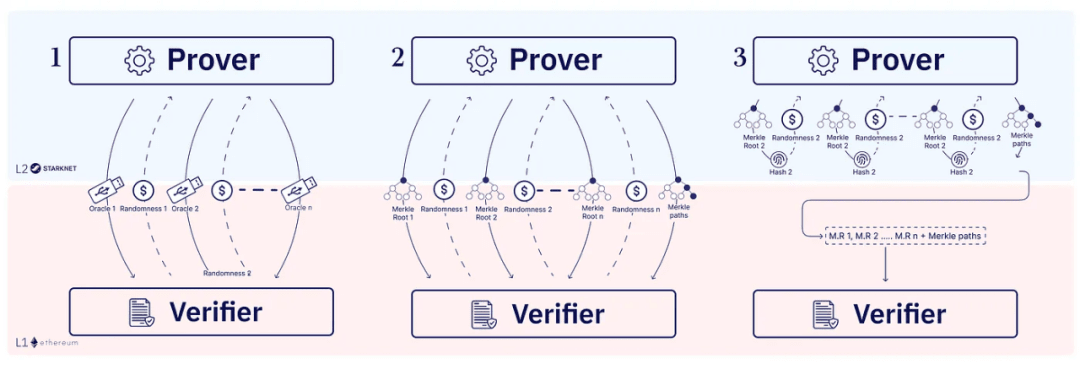
圧縮ラウンド
インタラクティブな STARK を選択することもできますが、STARK の生成プロセスを簡素化するために、通常は非インタラクティブな STARK を選択します。これにより、バリデーターは STARK を構築するときに外部情報を待つ必要がなくなります。実際、これが現在すべての STARK システムが展開されている方法であり、ethSTARK プロトコルが構築されている方法です。非インタラクティブな STARK は、透過的な SNARK の特殊なケースでもあります (透過的とは、インスタンス化に信頼できるセットアップが必要ないことを意味します。「アーサー マーリン プロトコル」または「パブリック コイン IOP」)。これを行うための最後のステップは、Fiat-Shamir アルゴリズムを適用して、複数ラウンドのインタラクションを 1 つのメッセージに圧縮することです。これを STARK 証明と呼びます。 Fiat-Shamir 変換は、対話型プロトコルを非対話型プロトコルに変換する方法です。証明者は、ハッシュ関数と対話しながら対話型プロトコルをシミュレートします。ラウンド i のランダムなチャレンジを導出するために、証明者はラウンド i の部分レコードをハッシュし、出力を次のチャレンジとして解釈します。
これにより、証明者はチャレンジが生成された後に答えを変更できなくなります。ただし、不正行為の証明者には、対話型 IOP では利用できない新しいポリシー手段がいくつかあります。証明者は、最後の証明者情報を変更することでバリデータ チャレンジを再生成し、新しいレコードを取得し、新しいチャレンジを取得できます。 IOP の標準的な信頼性の概念では、フィアット シャミア変換の安全性を実証するには不十分であることが判明しました。
たとえば、96 ラウンドの IOP があり、次のハックをバリデーターに追加します。96 ラウンドのそれぞれでバリデーターのランダム性の最初のビットが 0 の場合、バリデーターはそれを受け入れます (証拠は表示されません)。このハックをバリデーターに追加すると、IOP の信頼性エラーに 2⁹⁶ の項が追加されるだけであることがわかります。ただし、Fiat-Shamir 変換後、攻撃者は証明者情報を簡単に変更して、すべてのハッシュ値が 0 で始まるようにすることができ、それによって非常に短時間でシステムが侵害される可能性があります。この悲惨なシナリオは単なる理論上の例であり、配備された STARK には当てはまりませんので、ご安心ください。それでは、なぜ私たちのスタークが結局安全なのかを見てみましょう。つまり、攻撃者が最大 t ステップ実行する場合、攻撃が成功する確率は最大 (t) t 2⁹⁶ であることがわかります。
IOP とラウンドごとの信頼性
STARK のセキュリティは、その基礎となる IOP に依存します。しかし、IOP に 96 ビットのセキュリティがあるとは何を意味するのでしょうか?標準定義によれば、IOP の信頼性誤差は 2⁹⁶ です。これは、攻撃者 (実行時間に関係なく) がバリデーターを騙せる確率は最大 2 ~ 96 であることを意味します。ただし、前述したように、IOP の信頼性は 3 つのコンポーネントのうちの 1 つにすぎず、3 つのステップすべてからコンパイルされた STARK から 96 ビットのセキュリティを達成するには十分ではありません。対照的に、コンパイルされた STARK の安全性は、STARK に 96 ビットのラウンドごとの信頼性エラーがあると仮定して証明されます (状態回復信頼性と呼ばれる同様の定義が使用されることもあります)。
直感的には、「ラウンドごとの健全性」は、プロトコル全体だけでなく、各ラウンドに 96 ビットのセキュリティがあることを示します。より具体的に言うと、ラウンドバイラウンドの信頼性とは、プロトコルのレコードの一部を取得し、このレコードが「欺瞞的」であるかどうかを伝えることができる述語の存在を指します。「空のレコード」は「欺瞞的」ではなく、そして完全な記録は、バリデーターによって受け入れられた場合にのみ「欺瞞的」になります。最後に、バリデーターを「スプーフィング」していない部分レコードの場合、そのレコードが次のラウンドで「スプーフィング」になる確率は最大でも 2⁹⁶ です。これらのプロパティを持つ述語が存在する場合、そのプロトコルにはラウンドごとに 96 ビットの信頼性があると言えます (この述語は効率的な計算を必要としません)。
多くの場合、人々は IOP の信頼性のみを分析し、そのラウンドツーラウンドの信頼性を分析しません。確かに、標準的な信頼性はあるものの、ラウンドツーラウンドの信頼性は備えていない IOP の例を (製造された例を除いて) 考えるのは困難です。ただし、特定の安全限界を導出する場合、両者の間に差異が生じる可能性があり、すべてのビットが重要になります。したがって、厳密かつ特定の境界を導き出すには、ラウンドごとの IOP の信頼性を厳密に分析する必要があります。これはまさに、FRI プロトコルと STARK IOP のベースとなる ethSTARK IOP で行っていることです。分析自体は決して簡単なものではないため、この記事の範囲を超えています。新しい分析を使用すると、証明のための正確なパラメータを設定できます。
ラウンドごとの信頼性により、必要な保証が得られます。証明者はチャレンジを複数回再生成できますが、どのラウンドでも不正なレコードが生成される確率は 2⁹⁶ であることがわかっているため、証明者が t 回 (ハッシュ呼び出しの数で測定) を試みる場合は、次のように試行できます。欺瞞的なレコードを取得するのにほとんど t 回かかるため、成功の確率は (t) t 2⁹⁶ に制限されます。
すべてのエラーを追加
最後に、これらすべてが当てはまるためには、証明者がマークル ツリーを改ざんできないようにする必要があります。証明者がハッシュ関数で衝突を見つけない限り、マークル ツリーで不正行為を行うことはできないことがわかります。攻撃者が t 回の呼び出し (ランダム ハッシュ関数) を使用して衝突を発見する確率は、最大でも t2/2 です。これは、ハッシュ関数の出力長です (「誕生日のパラドックス」によって引き起こされます)。これが、 を設定する必要がある理由です。ハッシュ関数 長さは必要なセキュリティの 2 倍であるため、出力長が 192 でラウンドごとの信頼性が 96 ビットの IOP を持つハッシュ関数がある場合、信頼性の高いセックス エラーであるコンパイル済み STARK が得られます。 (t)=t2-⁹⁶ + t2 2¹⁹⁶ t/(t) = t/(t 2⁹⁶+t2 2¹⁹⁶) 1/(2⁹⁶+1/2⁹⁶) = 2²⁹⁵ であるため、このスキームには 95 ビットのセキュリティがあります。
要約する
これらを総合すると、STARK は、公開データに対して実行された計算の正確さをトラストレスに検証するための強力な方法を提供します。 STARK のセキュリティは通常、「信頼性エラー」によって測定されます。これは、攻撃者が虚偽の声明を提供し、検証者に証拠を納得させる確率を表します。 96 ビットなどの必要なセキュリティ レベルを達成するには、基盤となる IOP がラウンドごとの信頼性を満たし、ラウンドごとに高いセキュリティ レベルが維持されるようにする必要があります。私たちは、特定の安全限界を導き出すために、STARK の基礎となる IOP の信頼性をラウンドごとに分析しました。