
#kimi
kimi
閲覧回数 1,708
68人が討論中
注目
最新

·
--
$KIMI K3 が AI ベンチマークで Anthropic の Opus を打ち破った 🔥
このベンチマークデータは独立したアナリストによるもので、Kimi K3 モデルが Anthropic の Opus 4.8 を上回り、米国のラボは Opus 5 と GPT-6 のリリースを加速せざるを得なくなったことを示しています。GPT-5.6 Sol と K3 の差は現在ほぼ無視できるレベルに — つまり、次世代は想定より早くやって来ます。
AIモデル同士が飛躍的に追い越し合うと、AI に焦点を当てた暗号プロジェクトにとっての土台となる物語が強まります。この種の競争圧力は、期待が高まるにつれて資本がこのセクターへ流れ込むことが多いです。あなたは次の波に備えられていますか?
※金融アドバイスではありません。常にリスクを管理してください。
#KIMI #AI #CryptoAI #Breakthrough #Narrative
🔥
$KIMI K3 が AI ベンチマークで Anthropic の Opus を打ち破った 🔥
このベンチマークデータは独立したアナリストによるもので、Kimi K3 モデルが Anthropic の Opus 4.8 を上回り、米国のラボは Opus 5 と GPT-6 のリリースを加速せざるを得なくなったことを示しています。GPT-5.6 Sol と K3 の差は現在ほぼ無視できるレベルに — つまり、次世代は想定より早くやって来ます。
AIモデル同士が飛躍的に追い越し合うと、AI に焦点を当てた暗号プロジェクトにとっての土台となる物語が強まります。この種の競争圧力は、期待が高まるにつれて資本がこのセクターへ流れ込むことが多いです。あなたは次の波に備えられていますか?
※金融アドバイスではありません。常にリスクを管理してください。
#KIMI #AI #CryptoAI #Breakthrough #Narrative
🔥
このベンチマークデータは独立したアナリストによるもので、Kimi K3 モデルが Anthropic の Opus 4.8 を上回り、米国のラボは Opus 5 と GPT-6 のリリースを加速せざるを得なくなったことを示しています。GPT-5.6 Sol と K3 の差は現在ほぼ無視できるレベルに — つまり、次世代は想定より早くやって来ます。
AIモデル同士が飛躍的に追い越し合うと、AI に焦点を当てた暗号プロジェクトにとっての土台となる物語が強まります。この種の競争圧力は、期待が高まるにつれて資本がこのセクターへ流れ込むことが多いです。あなたは次の波に備えられていますか?
※金融アドバイスではありません。常にリスクを管理してください。
#KIMI #AI #CryptoAI #Breakthrough #Narrative
🔥
273

·
--
月の裏側が500億ドルの評価額:Kimi K3成功後の再評価
ニュース:月の裏側はIPO前の最後のラウンドの資金調達を進めており、投資前の評価額は500億ドルを目標としている。
振り返れば、4月の『潜入:Kimiの100時間』という物議を醸した記事には、こうした点が指摘されていた:
- KPIがない、階層がない、出勤管理がない
- 研究員は自然に目が覚めるまで寝られ、会議は数時間続く
- チームはモデルを巡って絶えず議論し、資源はモデルに絶対的に傾けられる
当時は「丁寧に仕立てられたPR記事」ではないかと疑われた。だがKimi K3がリリースされた後、こうした組織の細部には新たな解釈が生まれている。Foundation Model社にとって、研究開発を最優先に置くことが、実際に最適解になり得るのだ。
本当に注目すべきなのは、「KPIがない」というレッテルではなく、同じ目標に向けて組織全体がどう回っているかという点だ。
AI企業の評価は、モデルの能力だけでなく、組織の効率性にもよる。
#Kimi #月之暗面 #AI #中国AI
月の裏側が500億ドルの評価額:Kimi K3成功後の再評価
ニュース:月の裏側はIPO前の最後のラウンドの資金調達を進めており、投資前の評価額は500億ドルを目標としている。
振り返れば、4月の『潜入:Kimiの100時間』という物議を醸した記事には、こうした点が指摘されていた:
- KPIがない、階層がない、出勤管理がない
- 研究員は自然に目が覚めるまで寝られ、会議は数時間続く
- チームはモデルを巡って絶えず議論し、資源はモデルに絶対的に傾けられる
当時は「丁寧に仕立てられたPR記事」ではないかと疑われた。だがKimi K3がリリースされた後、こうした組織の細部には新たな解釈が生まれている。Foundation Model社にとって、研究開発を最優先に置くことが、実際に最適解になり得るのだ。
本当に注目すべきなのは、「KPIがない」というレッテルではなく、同じ目標に向けて組織全体がどう回っているかという点だ。
AI企業の評価は、モデルの能力だけでなく、組織の効率性にもよる。
#Kimi #月之暗面 #AI #中国AI
ニュース:月の裏側はIPO前の最後のラウンドの資金調達を進めており、投資前の評価額は500億ドルを目標としている。
振り返れば、4月の『潜入:Kimiの100時間』という物議を醸した記事には、こうした点が指摘されていた:
- KPIがない、階層がない、出勤管理がない
- 研究員は自然に目が覚めるまで寝られ、会議は数時間続く
- チームはモデルを巡って絶えず議論し、資源はモデルに絶対的に傾けられる
当時は「丁寧に仕立てられたPR記事」ではないかと疑われた。だがKimi K3がリリースされた後、こうした組織の細部には新たな解釈が生まれている。Foundation Model社にとって、研究開発を最優先に置くことが、実際に最適解になり得るのだ。
本当に注目すべきなのは、「KPIがない」というレッテルではなく、同じ目標に向けて組織全体がどう回っているかという点だ。
AI企業の評価は、モデルの能力だけでなく、組織の効率性にもよる。
#Kimi #月之暗面 #AI #中国AI
9

·
--
$KIMI IPOのうわさがAI業界を揺るがす——しかし当局者は「本当ではない」と否定 ⚡
注目を集めるIPOのうわさは、だいたい綺麗ではありません。月のダークサイドからの$3B(30億ドル)香港での出願は、AIストーリーにとって画期的な出来事になるはずでした——が、プロジェクト側が物語を止めに入ったのです。 📊
この否定は、うわさそのもの以上に重要です。確認がない場合、市場は残された期待を取引します——AI資金の波が、別の上場の受け皿を見つけるのかどうか。 🔍 強い資金は、こうした見出しのひっくり返りをボラティリティの罠として扱います。価格は期待で急騰し、公式発表で反落する——そんな流れです。 🌊
ポイントは、この矛盾をAI関連資産がどう消化するかを見ること。 ⚡ あなたはこのうわさを手仕舞い(フェード)しますか、それとも本当の出願を待ちますか? 👇
⚠️ これは投資助言ではありません。常にリスク管理を。 🛡️
🏷️ #KIMI #AI #IPO #CryptoNews #MarketStructure
🦈 💡
$KIMI IPOのうわさがAI業界を揺るがす——しかし当局者は「本当ではない」と否定 ⚡
注目を集めるIPOのうわさは、だいたい綺麗ではありません。月のダークサイドからの$3B(30億ドル)香港での出願は、AIストーリーにとって画期的な出来事になるはずでした——が、プロジェクト側が物語を止めに入ったのです。 📊
この否定は、うわさそのもの以上に重要です。確認がない場合、市場は残された期待を取引します——AI資金の波が、別の上場の受け皿を見つけるのかどうか。 🔍 強い資金は、こうした見出しのひっくり返りをボラティリティの罠として扱います。価格は期待で急騰し、公式発表で反落する——そんな流れです。 🌊
ポイントは、この矛盾をAI関連資産がどう消化するかを見ること。 ⚡ あなたはこのうわさを手仕舞い(フェード)しますか、それとも本当の出願を待ちますか? 👇
⚠️ これは投資助言ではありません。常にリスク管理を。 🛡️
🏷️ #KIMI #AI #IPO #CryptoNews #MarketStructure
🦈 💡
注目を集めるIPOのうわさは、だいたい綺麗ではありません。月のダークサイドからの$3B(30億ドル)香港での出願は、AIストーリーにとって画期的な出来事になるはずでした——が、プロジェクト側が物語を止めに入ったのです。 📊
この否定は、うわさそのもの以上に重要です。確認がない場合、市場は残された期待を取引します——AI資金の波が、別の上場の受け皿を見つけるのかどうか。 🔍 強い資金は、こうした見出しのひっくり返りをボラティリティの罠として扱います。価格は期待で急騰し、公式発表で反落する——そんな流れです。 🌊
ポイントは、この矛盾をAI関連資産がどう消化するかを見ること。 ⚡ あなたはこのうわさを手仕舞い(フェード)しますか、それとも本当の出願を待ちますか? 👇
⚠️ これは投資助言ではありません。常にリスク管理を。 🛡️
🏷️ #KIMI #AI #IPO #CryptoNews #MarketStructure
🦈 💡
6

🚨 $KIMI $3B 香港IPOの噂が飛び込む—事実か、それとも作り話か? 💥
「ダークサイド・オブ・ザ・ムーン(Kimi)」が今月、香港でIPOの出願を準備しているとの報道が出たことで、噂の飛び交いが一気に過熱。しかもテーブルには$3Bの調達があるという。しかし計画側はすぐに反応し、「その報道は事実ではない」と否定。 🦈 この手の見出しの振れ幅は、AI関連の物語(ナラティブ)を見ている誰にとっても、流動性が“二方向”に大きく揺れることを意味します。
出願が実際に行われるかどうかにかかわらず、その反応だけで物語は分かります。AI関連の案件は大きな資金の流入を引きつけており、新しい見出しが出るたびに相場が動くのです。📊 これはニュース主導の市場なので、不確実性を追いかけ回す(やかましい噂に飛びつく)のではなく尊重するトレーダーにこそ優位性があります。 💡
💬 注目度の高い否定が“熱い物語”に飛び込んできたとき、ボラティリティの急騰を取引する?それとも公式の出願を待つ? 👇
⚠️ 金融助言ではありません。常にリスク管理を。 🛡️
🏷️ #KIMI #IPO #AI #MarketSentiment #CryptoNews
🎯 🦈
🚨 $KIMI $3B 香港IPOの噂が飛び込む—事実か、それとも作り話か? 💥
「ダークサイド・オブ・ザ・ムーン(Kimi)」が今月、香港でIPOの出願を準備しているとの報道が出たことで、噂の飛び交いが一気に過熱。しかもテーブルには$3Bの調達があるという。しかし計画側はすぐに反応し、「その報道は事実ではない」と否定。 🦈 この手の見出しの振れ幅は、AI関連の物語(ナラティブ)を見ている誰にとっても、流動性が“二方向”に大きく揺れることを意味します。
出願が実際に行われるかどうかにかかわらず、その反応だけで物語は分かります。AI関連の案件は大きな資金の流入を引きつけており、新しい見出しが出るたびに相場が動くのです。📊 これはニュース主導の市場なので、不確実性を追いかけ回す(やかましい噂に飛びつく)のではなく尊重するトレーダーにこそ優位性があります。 💡
💬 注目度の高い否定が“熱い物語”に飛び込んできたとき、ボラティリティの急騰を取引する?それとも公式の出願を待つ? 👇
⚠️ 金融助言ではありません。常にリスク管理を。 🛡️
🏷️ #KIMI #IPO #AI #MarketSentiment #CryptoNews
🎯 🦈
「ダークサイド・オブ・ザ・ムーン(Kimi)」が今月、香港でIPOの出願を準備しているとの報道が出たことで、噂の飛び交いが一気に過熱。しかもテーブルには$3Bの調達があるという。しかし計画側はすぐに反応し、「その報道は事実ではない」と否定。 🦈 この手の見出しの振れ幅は、AI関連の物語(ナラティブ)を見ている誰にとっても、流動性が“二方向”に大きく揺れることを意味します。
出願が実際に行われるかどうかにかかわらず、その反応だけで物語は分かります。AI関連の案件は大きな資金の流入を引きつけており、新しい見出しが出るたびに相場が動くのです。📊 これはニュース主導の市場なので、不確実性を追いかけ回す(やかましい噂に飛びつく)のではなく尊重するトレーダーにこそ優位性があります。 💡
💬 注目度の高い否定が“熱い物語”に飛び込んできたとき、ボラティリティの急騰を取引する?それとも公式の出願を待つ? 👇
⚠️ 金融助言ではありません。常にリスク管理を。 🛡️
🏷️ #KIMI #IPO #AI #MarketSentiment #CryptoNews
🎯 🦈
15
·
--
コミュニティのいちばん心を動かされるところは
誰かがどれだけきれいな言葉を言ったかではありません。
むしろ、あなたが感じられること——
誰かが本当にそれを築き、守り育てている。
これこそが、あらゆる長期的価値の始まりです。
kimi Aiの成長は
そこに関わる一人ひとりの参加から生まれます。
自発的なロックアップから始まるのかもしれないし
あるいは、深夜3時の会議室で
もう成功の“遺伝子”が植え付けられているのかもしれません。
#kimi ai
コミュニティのいちばん心を動かされるところは
誰かがどれだけきれいな言葉を言ったかではありません。
むしろ、あなたが感じられること——
誰かが本当にそれを築き、守り育てている。
これこそが、あらゆる長期的価値の始まりです。
kimi Aiの成長は
そこに関わる一人ひとりの参加から生まれます。
自発的なロックアップから始まるのかもしれないし
あるいは、深夜3時の会議室で
もう成功の“遺伝子”が植え付けられているのかもしれません。
#kimi ai
誰かがどれだけきれいな言葉を言ったかではありません。
むしろ、あなたが感じられること——
誰かが本当にそれを築き、守り育てている。
これこそが、あらゆる長期的価値の始まりです。
kimi Aiの成長は
そこに関わる一人ひとりの参加から生まれます。
自発的なロックアップから始まるのかもしれないし
あるいは、深夜3時の会議室で
もう成功の“遺伝子”が植え付けられているのかもしれません。
#kimi ai
133

·
--
🚨 $KIMI はGPUなしで、2.78Tのパラメータを8GB RAMに圧縮 — 💥
🔍 このオープンソースの実験は、推論のスケーリングに関するあらゆる前提に挑戦します。176KBの純粋なC99プロジェクトが、NVMeストレージから必要に応じてエキスパートの重みをストリーミングすることで、Kimi K3の1.56TB重みセットをわずか8GBのメモリで動かします。💡
魔法の鍵はMoE(Mixture of Experts)によるスパースな活性化 — 各層で896人のエキスパートのうち稼働するのは16だけです。つまり開発者は、RAMのためにフラッシュストレージの帯域を引き換えにし、ディスクをメモリの遅い拡張のように扱っています。📊 トレードオフは苛烈です。1トークンあたり32.7秒。これは実運用に耐えるものではありませんが、超低コストな推論インフラのための構造的な設計図にはなっています。
より大きなシグナルは方向性です。📉 ハードウェアのボトルネックが創造的なエンジニアリングを強いるとき、効率性が次の物語になります。私たちは、分散型AIの次の波のための配管(基盤)を作っているのでしょうか?💬
⚠️ 投資助言ではありません。常にリスクを管理してください。🛡️
🏷️ #KIMI #AI #MoE #OpenSource #Crypto
💡 🔥
🚨 $KIMI はGPUなしで、2.78Tのパラメータを8GB RAMに圧縮 — 💥
🔍 このオープンソースの実験は、推論のスケーリングに関するあらゆる前提に挑戦します。176KBの純粋なC99プロジェクトが、NVMeストレージから必要に応じてエキスパートの重みをストリーミングすることで、Kimi K3の1.56TB重みセットをわずか8GBのメモリで動かします。💡
魔法の鍵はMoE(Mixture of Experts)によるスパースな活性化 — 各層で896人のエキスパートのうち稼働するのは16だけです。つまり開発者は、RAMのためにフラッシュストレージの帯域を引き換えにし、ディスクをメモリの遅い拡張のように扱っています。📊 トレードオフは苛烈です。1トークンあたり32.7秒。これは実運用に耐えるものではありませんが、超低コストな推論インフラのための構造的な設計図にはなっています。
より大きなシグナルは方向性です。📉 ハードウェアのボトルネックが創造的なエンジニアリングを強いるとき、効率性が次の物語になります。私たちは、分散型AIの次の波のための配管(基盤)を作っているのでしょうか?💬
⚠️ 投資助言ではありません。常にリスクを管理してください。🛡️
🏷️ #KIMI #AI #MoE #OpenSource #Crypto
💡 🔥
🔍 このオープンソースの実験は、推論のスケーリングに関するあらゆる前提に挑戦します。176KBの純粋なC99プロジェクトが、NVMeストレージから必要に応じてエキスパートの重みをストリーミングすることで、Kimi K3の1.56TB重みセットをわずか8GBのメモリで動かします。💡
魔法の鍵はMoE(Mixture of Experts)によるスパースな活性化 — 各層で896人のエキスパートのうち稼働するのは16だけです。つまり開発者は、RAMのためにフラッシュストレージの帯域を引き換えにし、ディスクをメモリの遅い拡張のように扱っています。📊 トレードオフは苛烈です。1トークンあたり32.7秒。これは実運用に耐えるものではありませんが、超低コストな推論インフラのための構造的な設計図にはなっています。
より大きなシグナルは方向性です。📉 ハードウェアのボトルネックが創造的なエンジニアリングを強いるとき、効率性が次の物語になります。私たちは、分散型AIの次の波のための配管(基盤)を作っているのでしょうか?💬
⚠️ 投資助言ではありません。常にリスクを管理してください。🛡️
🏷️ #KIMI #AI #MoE #OpenSource #Crypto
💡 🔥
30
·
--
#kimi k3#
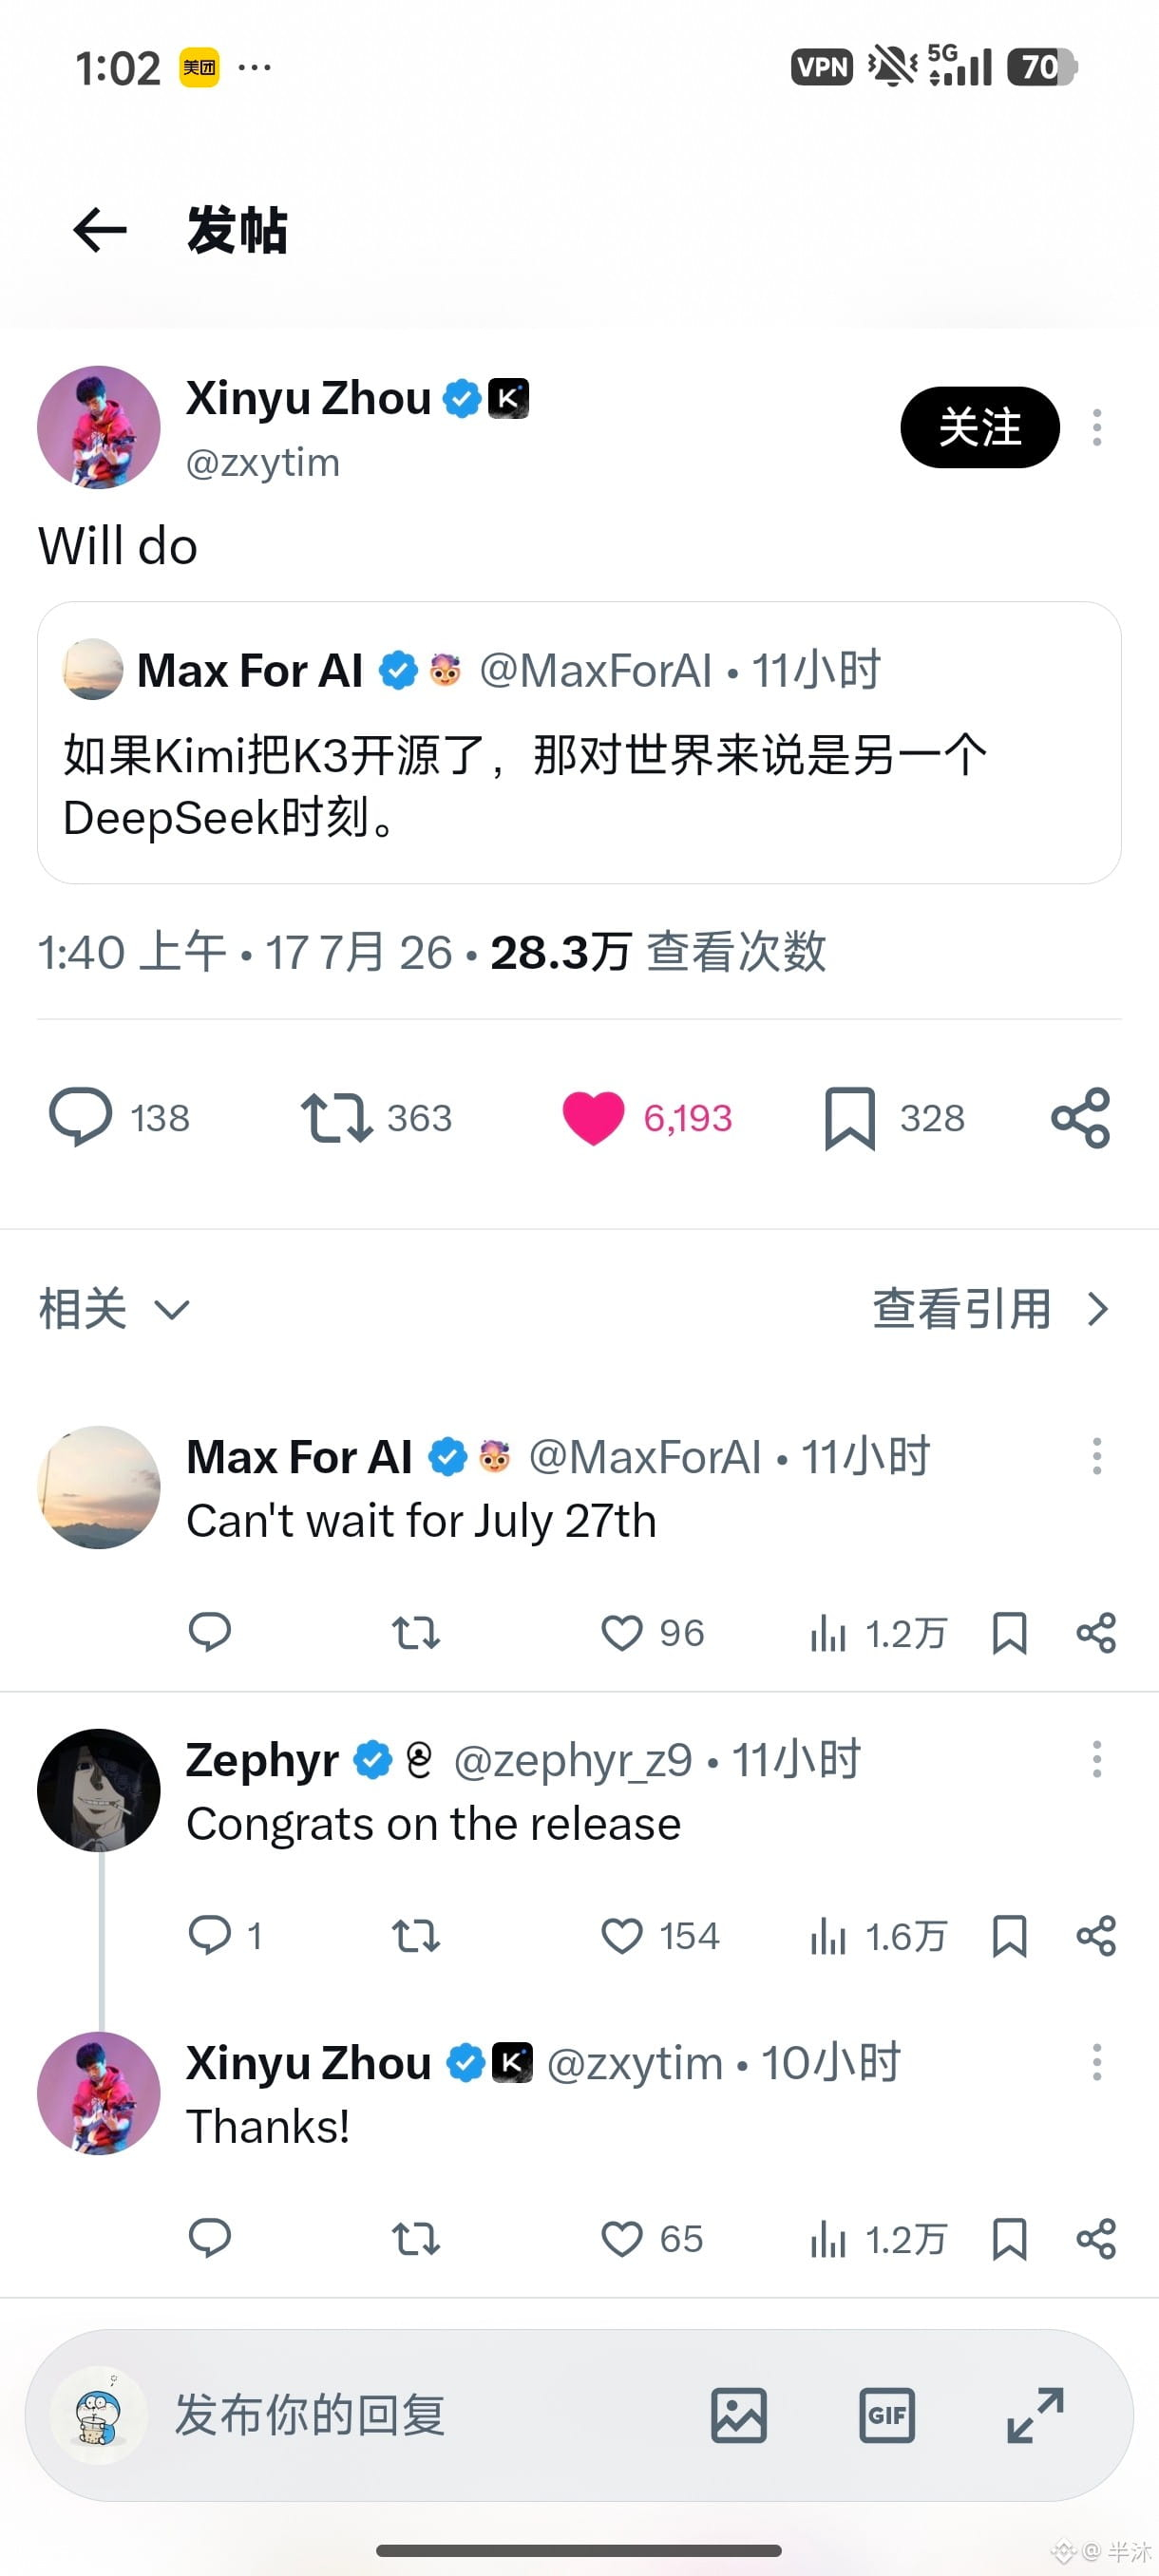
月之暗面共同創始者が、オープンソースのkimi k3を公開する予定です。うわ、世界一の大規模言語モデルがオープンソースになるなんて、これがopen ai、claude codeのようなクローズド陣営を殺し尽くさないわけがないでしょう。$BABA
{future}(BABAUSDT)
#kimi k3#
月之暗面共同創始者が、オープンソースのkimi k3を公開する予定です。うわ、世界一の大規模言語モデルがオープンソースになるなんて、これがopen ai、claude codeのようなクローズド陣営を殺し尽くさないわけがないでしょう。$BABA
月之暗面共同創始者が、オープンソースのkimi k3を公開する予定です。うわ、世界一の大規模言語モデルがオープンソースになるなんて、これがopen ai、claude codeのようなクローズド陣営を殺し尽くさないわけがないでしょう。$BABA
2
111
·
--
翻訳参照
🚨 $KIMI RUMORED FOR $3B HONG KONG IPO — WILL SMART MONEY ROTATE INTO AI? 💥
📊 Moonshot AI — the team behind the Kimi assistant — is reportedly preparing its Hong Kong IPO filing as early as this month, with market chatter pointing to a $3B raise. 🔍 Until the company confirms, treat this as an intelligence event: institutional appetite assigning a valuation to frontier AI infrastructure.
💡 For the crypto tape, the follow-through signal is narrative spillover. When private-market heavyweights queue up for AI exposure, risk-on capital often rotates toward AI-linked digital assets ahead of official confirmation. ⏳ This is a catalyst watch, not a done deal.
💬 Could a confirmed filing pull fresh institutional flows into AI-narrative tokens before month-end? 👇
⚠️ Not financial advice. Always manage your risk. 🛡️
🏷️ #KIMI #IPO #AI #Crypto #InstitutionalFlow
🦈 💎
🚨 $KIMI RUMORED FOR $3B HONG KONG IPO — WILL SMART MONEY ROTATE INTO AI? 💥
📊 Moonshot AI — the team behind the Kimi assistant — is reportedly preparing its Hong Kong IPO filing as early as this month, with market chatter pointing to a $3B raise. 🔍 Until the company confirms, treat this as an intelligence event: institutional appetite assigning a valuation to frontier AI infrastructure.
💡 For the crypto tape, the follow-through signal is narrative spillover. When private-market heavyweights queue up for AI exposure, risk-on capital often rotates toward AI-linked digital assets ahead of official confirmation. ⏳ This is a catalyst watch, not a done deal.
💬 Could a confirmed filing pull fresh institutional flows into AI-narrative tokens before month-end? 👇
⚠️ Not financial advice. Always manage your risk. 🛡️
🏷️ #KIMI #IPO #AI #Crypto #InstitutionalFlow
🦈 💎
📊 Moonshot AI — the team behind the Kimi assistant — is reportedly preparing its Hong Kong IPO filing as early as this month, with market chatter pointing to a $3B raise. 🔍 Until the company confirms, treat this as an intelligence event: institutional appetite assigning a valuation to frontier AI infrastructure.
💡 For the crypto tape, the follow-through signal is narrative spillover. When private-market heavyweights queue up for AI exposure, risk-on capital often rotates toward AI-linked digital assets ahead of official confirmation. ⏳ This is a catalyst watch, not a done deal.
💬 Could a confirmed filing pull fresh institutional flows into AI-narrative tokens before month-end? 👇
⚠️ Not financial advice. Always manage your risk. 🛡️
🏷️ #KIMI #IPO #AI #Crypto #InstitutionalFlow
🦈 💎
3

$KIMI EYES $3B 香港IPO — 通知によるクリプトの流動性 🦈 🌊
$30億のIPOは単なる節目以上のものです──それは流動性の“磁石”。🌊 巨額の乾いた資金がエクイティ・デスクに集まると、その資金はどこかからやって来る必要があり、暗号のような投機的なリスク・プールが最初に吸い寄せられやすいのです。
💡 賢い資金は、このような申請の数週間前からポジションを取ります。香港のAIストーリーへの食欲が熱いままなら、アジアの暗号フローに対して資金のローテーション圧力がかかる可能性があります。手がかりとしてはステーブルコインの流入とBTCのドミナンスを見てください。🔍
上場は未確認ですが、市場は印が乾くずっと前から“織り込み”ます。💬 $30億規模の株式資金が暗号の買い板を削るのか、それともAIの“おまけ光(ハロー)”がすべての船を押し上げるのか?👇
⚠️ 投資助言ではありません。常にリスクを管理してください。🛡️
🏷️ #KIMI #HongKongIPO #LiquidityFlow #AI #Crypto
🦈 💎
$KIMI EYES $3B 香港IPO — 通知によるクリプトの流動性 🦈 🌊
$30億のIPOは単なる節目以上のものです──それは流動性の“磁石”。🌊 巨額の乾いた資金がエクイティ・デスクに集まると、その資金はどこかからやって来る必要があり、暗号のような投機的なリスク・プールが最初に吸い寄せられやすいのです。
💡 賢い資金は、このような申請の数週間前からポジションを取ります。香港のAIストーリーへの食欲が熱いままなら、アジアの暗号フローに対して資金のローテーション圧力がかかる可能性があります。手がかりとしてはステーブルコインの流入とBTCのドミナンスを見てください。🔍
上場は未確認ですが、市場は印が乾くずっと前から“織り込み”ます。💬 $30億規模の株式資金が暗号の買い板を削るのか、それともAIの“おまけ光(ハロー)”がすべての船を押し上げるのか?👇
⚠️ 投資助言ではありません。常にリスクを管理してください。🛡️
🏷️ #KIMI #HongKongIPO #LiquidityFlow #AI #Crypto
🦈 💎
$30億のIPOは単なる節目以上のものです──それは流動性の“磁石”。🌊 巨額の乾いた資金がエクイティ・デスクに集まると、その資金はどこかからやって来る必要があり、暗号のような投機的なリスク・プールが最初に吸い寄せられやすいのです。
💡 賢い資金は、このような申請の数週間前からポジションを取ります。香港のAIストーリーへの食欲が熱いままなら、アジアの暗号フローに対して資金のローテーション圧力がかかる可能性があります。手がかりとしてはステーブルコインの流入とBTCのドミナンスを見てください。🔍
上場は未確認ですが、市場は印が乾くずっと前から“織り込み”ます。💬 $30億規模の株式資金が暗号の買い板を削るのか、それともAIの“おまけ光(ハロー)”がすべての船を押し上げるのか?👇
⚠️ 投資助言ではありません。常にリスクを管理してください。🛡️
🏷️ #KIMI #HongKongIPO #LiquidityFlow #AI #Crypto
🦈 💎
9
·
--
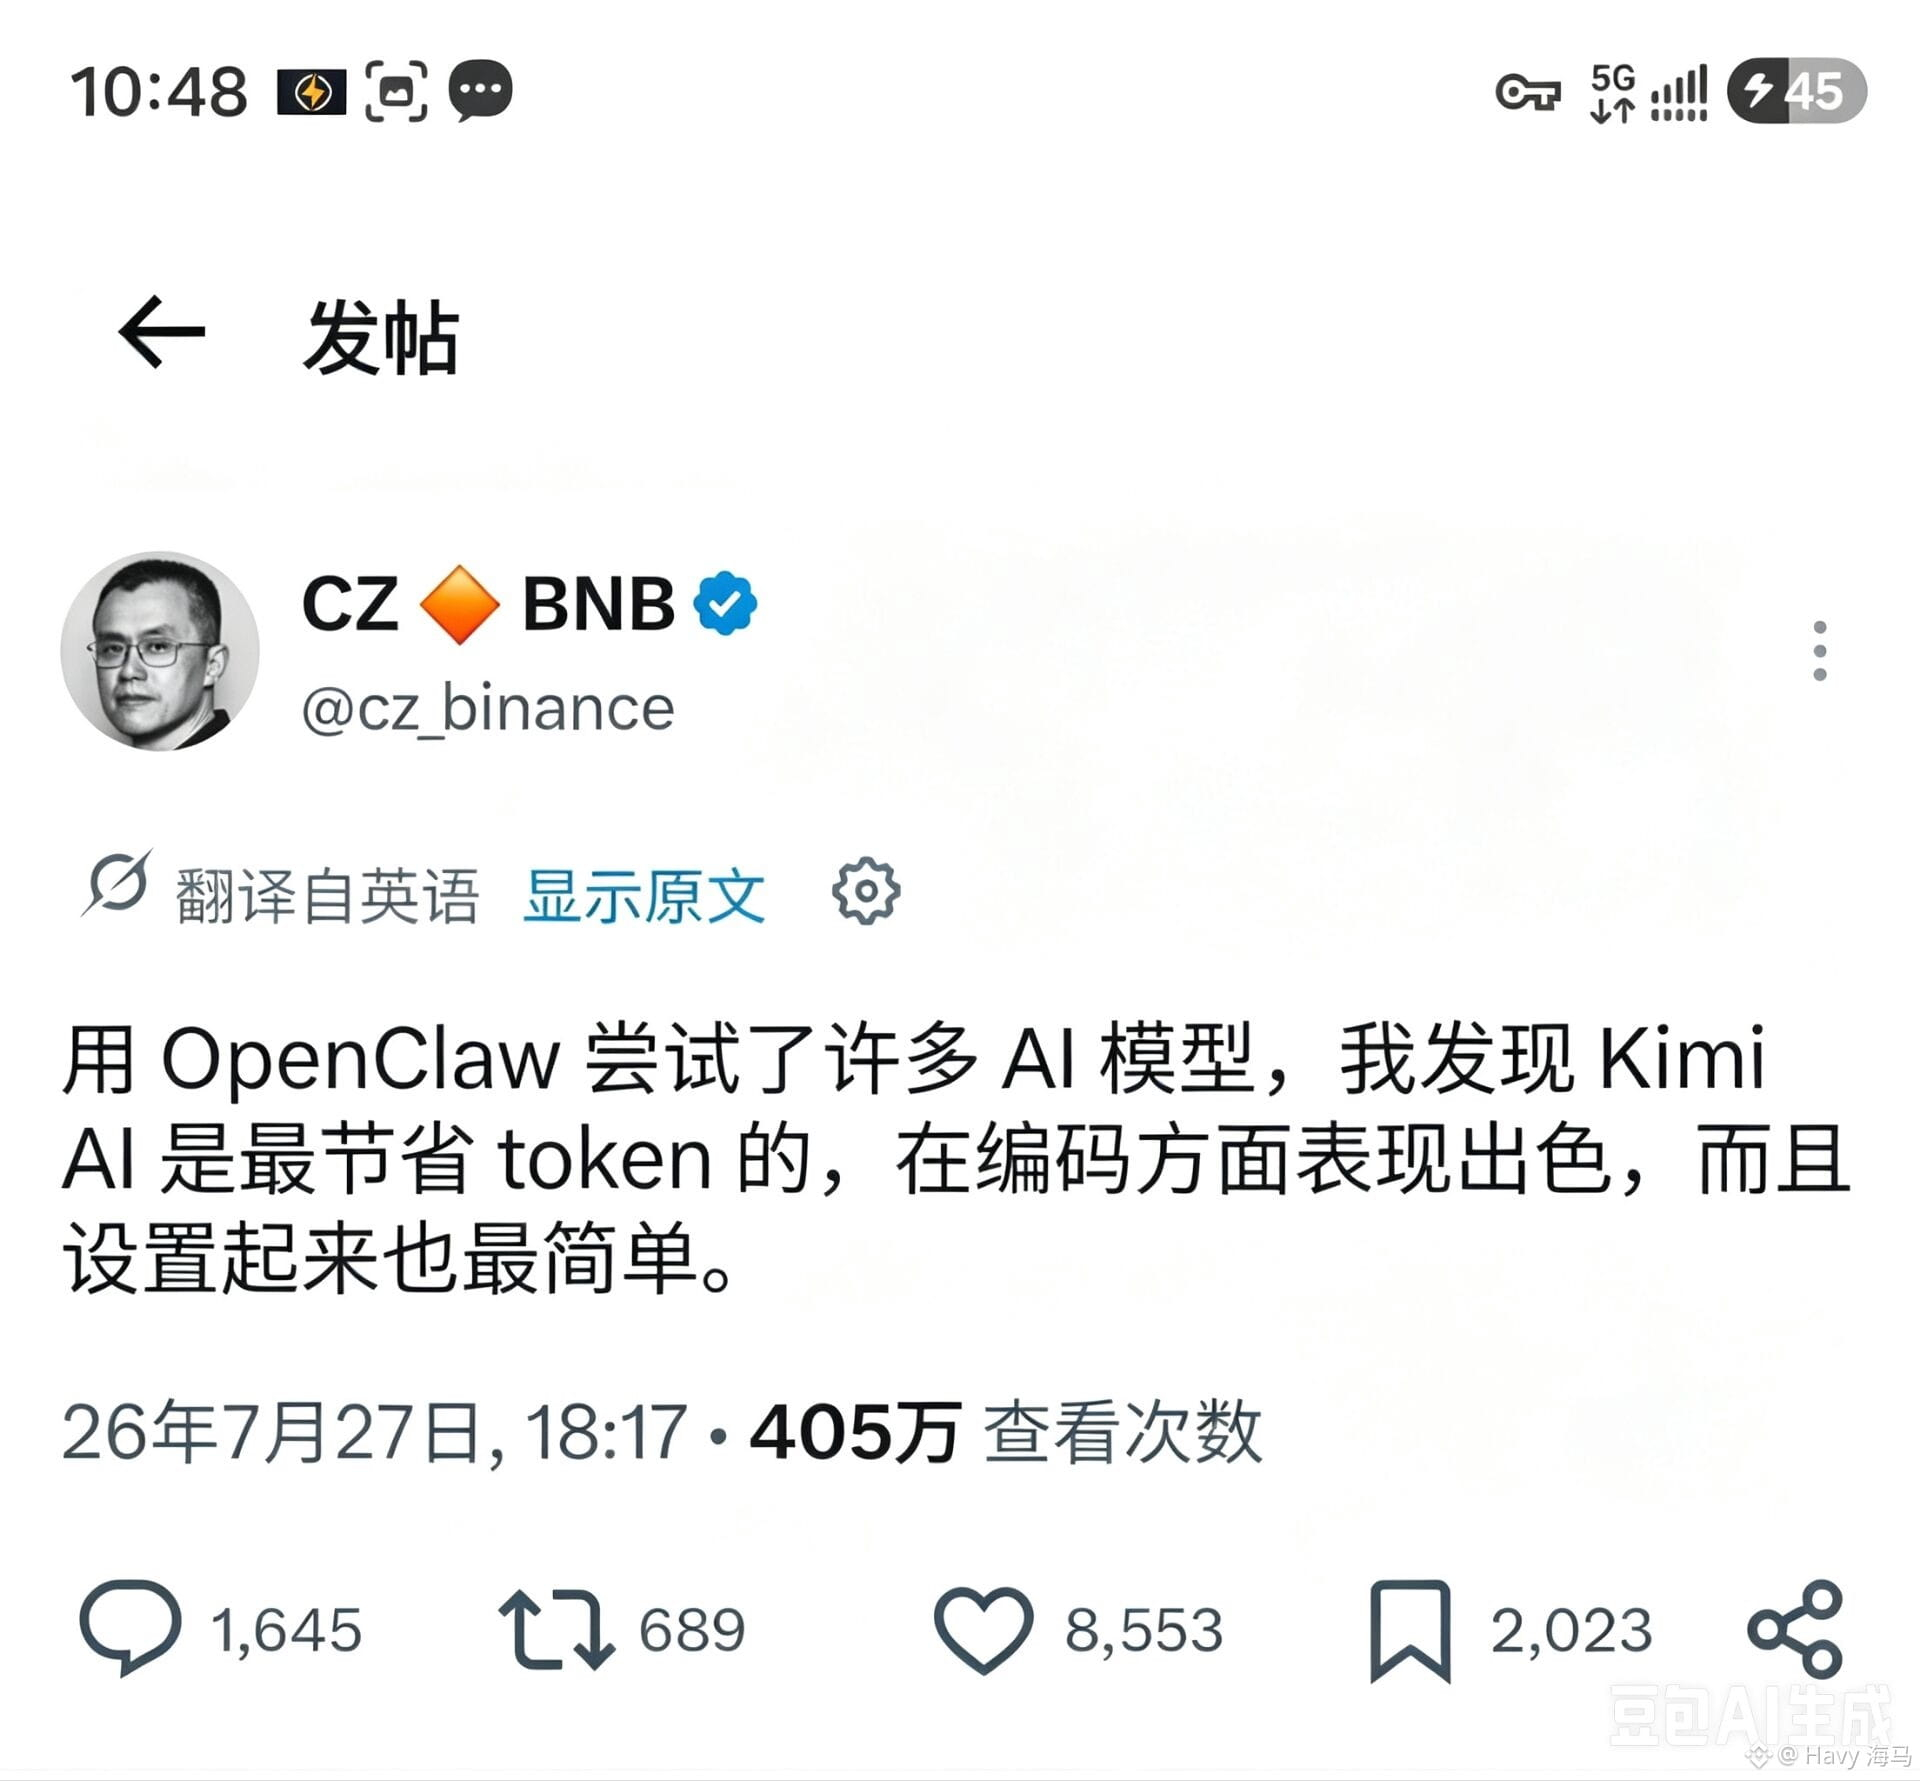
Kimi K3 は「人はこわい、でも言葉は多くない」タイプのモデルです。フロントエンドが優れているだけでなく、バックエンドもある程度 Fable5 と GPT-5.6 Sol を超えています。
実測:GPT-5.6 Sol で 6 つの欠陥を修正した後、Fable5 と Kimi K3 にそれぞれレビューしてもらいました。Fable5 は「提出できます」と言いましたが、Kimi K3 は重大な PostgreSQL jsonb のバリデーション問題を見つけました。
Kimi Code の harness についての論争——「できが悪い」と言う人もいますが、核心ロジックは「モデル企業が“モデル”を作る」ということです。harness はますます重要性が下がり、モデルに最初から備わっている能力が harness の価値を食ってしまうのです。
これは、AI ツールチェーンの進化の方向性そのものです:
• harness は“外付け”のルールシステムで、モデルの能力が弱いときに穴埋めが必要になる
• モデル自体が十分強いと、harness は「必需品」から「束縛」へ変わる
• Kimi に内蔵された天眼查のような垂直能力は、汎用 harness よりも破壊力が大きい
中国の AI モデルの実戦力は、今まさにシリコンバレーのトップ層に追いつき、場合によっては上回りつつあります。スコアだけを見るのではなく、実際のコードレビュー結果を見てください。
#AI #Kimi #大模型 #コード审查
Kimi K3 は「人はこわい、でも言葉は多くない」タイプのモデルです。フロントエンドが優れているだけでなく、バックエンドもある程度 Fable5 と GPT-5.6 Sol を超えています。
実測:GPT-5.6 Sol で 6 つの欠陥を修正した後、Fable5 と Kimi K3 にそれぞれレビューしてもらいました。Fable5 は「提出できます」と言いましたが、Kimi K3 は重大な PostgreSQL jsonb のバリデーション問題を見つけました。
Kimi Code の harness についての論争——「できが悪い」と言う人もいますが、核心ロジックは「モデル企業が“モデル”を作る」ということです。harness はますます重要性が下がり、モデルに最初から備わっている能力が harness の価値を食ってしまうのです。
これは、AI ツールチェーンの進化の方向性そのものです:
• harness は“外付け”のルールシステムで、モデルの能力が弱いときに穴埋めが必要になる
• モデル自体が十分強いと、harness は「必需品」から「束縛」へ変わる
• Kimi に内蔵された天眼查のような垂直能力は、汎用 harness よりも破壊力が大きい
中国の AI モデルの実戦力は、今まさにシリコンバレーのトップ層に追いつき、場合によっては上回りつつあります。スコアだけを見るのではなく、実際のコードレビュー結果を見てください。
#AI #Kimi #大模型 #コード审查
実測:GPT-5.6 Sol で 6 つの欠陥を修正した後、Fable5 と Kimi K3 にそれぞれレビューしてもらいました。Fable5 は「提出できます」と言いましたが、Kimi K3 は重大な PostgreSQL jsonb のバリデーション問題を見つけました。
Kimi Code の harness についての論争——「できが悪い」と言う人もいますが、核心ロジックは「モデル企業が“モデル”を作る」ということです。harness はますます重要性が下がり、モデルに最初から備わっている能力が harness の価値を食ってしまうのです。
これは、AI ツールチェーンの進化の方向性そのものです:
• harness は“外付け”のルールシステムで、モデルの能力が弱いときに穴埋めが必要になる
• モデル自体が十分強いと、harness は「必需品」から「束縛」へ変わる
• Kimi に内蔵された天眼查のような垂直能力は、汎用 harness よりも破壊力が大きい
中国の AI モデルの実戦力は、今まさにシリコンバレーのトップ層に追いつき、場合によっては上回りつつあります。スコアだけを見るのではなく、実際のコードレビュー結果を見てください。
#AI #Kimi #大模型 #コード审查
48

$KIMI - 今週、中国最大のAIモデルがローンチ 🔥
エントリー:利用不可 🔥
ターゲット:利用不可 🚀
ストップロス:利用不可 ⚠️
「The Dark Side of the Moon(Kimi)」プロジェクトは、近い日々にKimi K3を投入します。20〜30兆パラメータのオープンウェイト・モデルで、主流のベンチマークにおいてOpus 4.8を上回るとのことです。これが中国発の最大級のAIモデルで、しかも無料でダウンロードできます。
AnthropicとOpenAIにとって、いま大きな目覚めの警鐘が鳴ったようです。リリースはすでに話題を呼んでおり、関連するAIトークンの出来高の変化を見ています。次の動きに向けて、どのAIプロジェクトを追っていますか?
※金融アドバイスではありません。常にリスク管理をしてください。
#KIMI #AI #Crypto #OpenWeight #AIModels
💎
$KIMI - 今週、中国最大のAIモデルがローンチ 🔥
エントリー:利用不可 🔥
ターゲット:利用不可 🚀
ストップロス:利用不可 ⚠️
「The Dark Side of the Moon(Kimi)」プロジェクトは、近い日々にKimi K3を投入します。20〜30兆パラメータのオープンウェイト・モデルで、主流のベンチマークにおいてOpus 4.8を上回るとのことです。これが中国発の最大級のAIモデルで、しかも無料でダウンロードできます。
AnthropicとOpenAIにとって、いま大きな目覚めの警鐘が鳴ったようです。リリースはすでに話題を呼んでおり、関連するAIトークンの出来高の変化を見ています。次の動きに向けて、どのAIプロジェクトを追っていますか?
※金融アドバイスではありません。常にリスク管理をしてください。
#KIMI #AI #Crypto #OpenWeight #AIModels
💎
エントリー:利用不可 🔥
ターゲット:利用不可 🚀
ストップロス:利用不可 ⚠️
「The Dark Side of the Moon(Kimi)」プロジェクトは、近い日々にKimi K3を投入します。20〜30兆パラメータのオープンウェイト・モデルで、主流のベンチマークにおいてOpus 4.8を上回るとのことです。これが中国発の最大級のAIモデルで、しかも無料でダウンロードできます。
AnthropicとOpenAIにとって、いま大きな目覚めの警鐘が鳴ったようです。リリースはすでに話題を呼んでおり、関連するAIトークンの出来高の変化を見ています。次の動きに向けて、どのAIプロジェクトを追っていますか?
※金融アドバイスではありません。常にリスク管理をしてください。
#KIMI #AI #Crypto #OpenWeight #AIModels
💎
33

MOONSHOT AI、第3者による資金調達詐欺を「すべて」宣言 - $KIMI 🔥
同社は、機関が同社名を使って偽の資金調達案件を募っていた複数の仕組みを発見しました。資本の増資はすべて同社が直接取り扱います――外部の助言者や事前に取り決めた割当(クオータ)はありません。これは単なる法的な通知ではなく、センチメントにとっての流動性イベントです。
声明では、資産保有の証明書類を提供したことが一度もないこと、また割当を固定(ロック)したことも否定しています。担保付きのMoonshot株を保有しているという主張は詐欺です。資金を投じる前に、あなたの取引元(ディールソース)を確認していますか?
投資助言ではありません。常にリスクを管理してください。
#KIMI #ScamAlert #FraudWarning #DueDiligence #Crypto
💎
MOONSHOT AI、第3者による資金調達詐欺を「すべて」宣言 - $KIMI 🔥
同社は、機関が同社名を使って偽の資金調達案件を募っていた複数の仕組みを発見しました。資本の増資はすべて同社が直接取り扱います――外部の助言者や事前に取り決めた割当(クオータ)はありません。これは単なる法的な通知ではなく、センチメントにとっての流動性イベントです。
声明では、資産保有の証明書類を提供したことが一度もないこと、また割当を固定(ロック)したことも否定しています。担保付きのMoonshot株を保有しているという主張は詐欺です。資金を投じる前に、あなたの取引元(ディールソース)を確認していますか?
投資助言ではありません。常にリスクを管理してください。
#KIMI #ScamAlert #FraudWarning #DueDiligence #Crypto
💎
同社は、機関が同社名を使って偽の資金調達案件を募っていた複数の仕組みを発見しました。資本の増資はすべて同社が直接取り扱います――外部の助言者や事前に取り決めた割当(クオータ)はありません。これは単なる法的な通知ではなく、センチメントにとっての流動性イベントです。
声明では、資産保有の証明書類を提供したことが一度もないこと、また割当を固定(ロック)したことも否定しています。担保付きのMoonshot株を保有しているという主張は詐欺です。資金を投じる前に、あなたの取引元(ディールソース)を確認していますか?
投資助言ではありません。常にリスクを管理してください。
#KIMI #ScamAlert #FraudWarning #DueDiligence #Crypto
💎
4

$KIMI ARR は 3億ドルに到達し、バリュエーションは 315億ドルまで倍増 ❗
これは、通常は大規模な価格発見サイクルの前触れとなるような収益加速です。6月中旬にARRが3億ドルを超え、70%がAPI収益であることは、明確なプロダクト・マーケット・フィットを示しています。これは、初期のAnthropicのような状況に近いです。
315億ドルのプレマネー・バリュエーションは、AI分野での優位性が継続すると見ている“賢い資金”の賭けを物語っています。開発者向けAPI呼び出しは増加し、海外の有料ユーザーも成長しており、価格体系もモデルの反復とともに変化しています。これは、持続的な需要につながるレシピです。
これってAIトークンのブレイクアウトを示していると思いますか?それとも、バリュエーションにはすでに織り込み済みでしょうか?
※投資助言ではありません。常にリスク管理をしてください。
#KIMI #AI #Funding #Bullish #Crypto
🔥
$KIMI ARR は 3億ドルに到達し、バリュエーションは 315億ドルまで倍増 ❗
これは、通常は大規模な価格発見サイクルの前触れとなるような収益加速です。6月中旬にARRが3億ドルを超え、70%がAPI収益であることは、明確なプロダクト・マーケット・フィットを示しています。これは、初期のAnthropicのような状況に近いです。
315億ドルのプレマネー・バリュエーションは、AI分野での優位性が継続すると見ている“賢い資金”の賭けを物語っています。開発者向けAPI呼び出しは増加し、海外の有料ユーザーも成長しており、価格体系もモデルの反復とともに変化しています。これは、持続的な需要につながるレシピです。
これってAIトークンのブレイクアウトを示していると思いますか?それとも、バリュエーションにはすでに織り込み済みでしょうか?
※投資助言ではありません。常にリスク管理をしてください。
#KIMI #AI #Funding #Bullish #Crypto
🔥
これは、通常は大規模な価格発見サイクルの前触れとなるような収益加速です。6月中旬にARRが3億ドルを超え、70%がAPI収益であることは、明確なプロダクト・マーケット・フィットを示しています。これは、初期のAnthropicのような状況に近いです。
315億ドルのプレマネー・バリュエーションは、AI分野での優位性が継続すると見ている“賢い資金”の賭けを物語っています。開発者向けAPI呼び出しは増加し、海外の有料ユーザーも成長しており、価格体系もモデルの反復とともに変化しています。これは、持続的な需要につながるレシピです。
これってAIトークンのブレイクアウトを示していると思いますか?それとも、バリュエーションにはすでに織り込み済みでしょうか?
※投資助言ではありません。常にリスク管理をしてください。
#KIMI #AI #Funding #Bullish #Crypto
🔥
35
·
--
日拱一卒:杨植麟为什么不留在美国?
CMU 读博期间在 Google Brain 和 Meta AI 都实习过,导师是后来去苹果带 AI 的 Ruslan Salakhutdinov。2023 年选择回国创业。
这个选择在 2023 年看像赌博,在 2026 年看像计算。美国有最强的研究环境,但中国的优势是"组队速度"——在 AI 竞争里,从 0 到 1 的速度比从 1 到 100 的精度更重要。
杨植麟回国不是放弃美国的技术,是选择了一个"人才密度更低但决策链路更短"的环境。Kimi K3 的 896 专家 MoE 和自我进化 kernel 优化,需要的不是更多天才,是一个能快速试错、快速停错的组织。
选战场和选武器一样重要。
#Kimi #杨植麟 #AI
日拱一卒:杨植麟为什么不留在美国?
CMU 读博期间在 Google Brain 和 Meta AI 都实习过,导师是后来去苹果带 AI 的 Ruslan Salakhutdinov。2023 年选择回国创业。
这个选择在 2023 年看像赌博,在 2026 年看像计算。美国有最强的研究环境,但中国的优势是"组队速度"——在 AI 竞争里,从 0 到 1 的速度比从 1 到 100 的精度更重要。
杨植麟回国不是放弃美国的技术,是选择了一个"人才密度更低但决策链路更短"的环境。Kimi K3 的 896 专家 MoE 和自我进化 kernel 优化,需要的不是更多天才,是一个能快速试错、快速停错的组织。
选战场和选武器一样重要。
#Kimi #杨植麟 #AI
CMU 读博期间在 Google Brain 和 Meta AI 都实习过,导师是后来去苹果带 AI 的 Ruslan Salakhutdinov。2023 年选择回国创业。
这个选择在 2023 年看像赌博,在 2026 年看像计算。美国有最强的研究环境,但中国的优势是"组队速度"——在 AI 竞争里,从 0 到 1 的速度比从 1 到 100 的精度更重要。
杨植麟回国不是放弃美国的技术,是选择了一个"人才密度更低但决策链路更短"的环境。Kimi K3 的 896 专家 MoE 和自我进化 kernel 优化,需要的不是更多天才,是一个能快速试错、快速停错的组织。
选战场和选武器一样重要。
#Kimi #杨植麟 #AI
20
·
--
日拱一卒:Kimi はなぜ K3 を作れたのか?杨新宇が同業4つの罪を挙げる
① 傲慢:老舗のチームは AI 戦争はもう終わっていて、自分たちがもう勝ったと思い込んでいる。
② 焦躁:若い研究室は基礎が固まっておらず、追いつけないとすぐに方向転換してしまう。
③ 臆病:実力は大して弱くないのに、目標を業界トップに置こうとしない。
④ 目標のズレ:誰もが自分の手柄を争っていて、会社が AGI を作れるかどうかを本当に気にしている人がいない。
杨新宇によれば「月の暗黒面」で最も違うのは、創業チームが依然として AGI への強い追求を持っていることだ。
さらに「Kimi 五戒」も公開:
- モデル企業はモデルを作る
- Research、論文作成は実験をする
- モデルの学習は Metric(指標)を見る
- うまくいかないものを無理に押し通さない
- YOLO しない
大雑把に言うと:物語を語るより実験をせよ。訓練はデータを見て、失敗したら早めに止める。直感に賭けない。
この4つの「罪」と5つの「戒」は、実は同じことを言っている。ほとんどの AI 企業が死ぬのは「トップになりたい」からで、「正しいことをやりたい」からではない。Kimi の差別化は、より賢いからではなく、もっと自制が効いているからだ。
#Kimi #K3 #AI
日拱一卒:Kimi はなぜ K3 を作れたのか?杨新宇が同業4つの罪を挙げる
① 傲慢:老舗のチームは AI 戦争はもう終わっていて、自分たちがもう勝ったと思い込んでいる。
② 焦躁:若い研究室は基礎が固まっておらず、追いつけないとすぐに方向転換してしまう。
③ 臆病:実力は大して弱くないのに、目標を業界トップに置こうとしない。
④ 目標のズレ:誰もが自分の手柄を争っていて、会社が AGI を作れるかどうかを本当に気にしている人がいない。
杨新宇によれば「月の暗黒面」で最も違うのは、創業チームが依然として AGI への強い追求を持っていることだ。
さらに「Kimi 五戒」も公開:
- モデル企業はモデルを作る
- Research、論文作成は実験をする
- モデルの学習は Metric(指標)を見る
- うまくいかないものを無理に押し通さない
- YOLO しない
大雑把に言うと:物語を語るより実験をせよ。訓練はデータを見て、失敗したら早めに止める。直感に賭けない。
この4つの「罪」と5つの「戒」は、実は同じことを言っている。ほとんどの AI 企業が死ぬのは「トップになりたい」からで、「正しいことをやりたい」からではない。Kimi の差別化は、より賢いからではなく、もっと自制が効いているからだ。
#Kimi #K3 #AI
① 傲慢:老舗のチームは AI 戦争はもう終わっていて、自分たちがもう勝ったと思い込んでいる。
② 焦躁:若い研究室は基礎が固まっておらず、追いつけないとすぐに方向転換してしまう。
③ 臆病:実力は大して弱くないのに、目標を業界トップに置こうとしない。
④ 目標のズレ:誰もが自分の手柄を争っていて、会社が AGI を作れるかどうかを本当に気にしている人がいない。
杨新宇によれば「月の暗黒面」で最も違うのは、創業チームが依然として AGI への強い追求を持っていることだ。
さらに「Kimi 五戒」も公開:
- モデル企業はモデルを作る
- Research、論文作成は実験をする
- モデルの学習は Metric(指標)を見る
- うまくいかないものを無理に押し通さない
- YOLO しない
大雑把に言うと:物語を語るより実験をせよ。訓練はデータを見て、失敗したら早めに止める。直感に賭けない。
この4つの「罪」と5つの「戒」は、実は同じことを言っている。ほとんどの AI 企業が死ぬのは「トップになりたい」からで、「正しいことをやりたい」からではない。Kimi の差別化は、より賢いからではなく、もっと自制が効いているからだ。
#Kimi #K3 #AI
28

🚨 $KIMI AI UNICORN AT $50B – 次のメガ・モメンタム・プレイ? 💎
💡 月の旗艦モデルのダークサイド(Dark Side of the Moon)は、$500億($50B)のバリュエーションでプレIPOの協議をしていると報じられています。これは単なるお祭り騒ぎではなく、次のAIの波に向けた賢い資金のポジショニングです。📊 AIの大手企業がこの水準で入札を始めると、初期の投機的なトークンが暗号資産(crypto)で先陣を切ることがよくあります。
⚡ 分散型の注文帳では、すでに取引量がささやくように動いています。これは小口(リテール)のポンプではありません――機関投資家の気配です。💬 群衆が目を覚ます前にAIの物語を先回りしますか?それとも確証を待ちますか? 👇
⚠️ これは金融アドバイスではありません。常にリスク管理をしてください。 🛡️
🏷️ #KIMI #AI #PreIPO #Momentum #Crypto
🔥 🦈
🚨 $KIMI AI UNICORN AT $50B – 次のメガ・モメンタム・プレイ? 💎
💡 月の旗艦モデルのダークサイド(Dark Side of the Moon)は、$500億($50B)のバリュエーションでプレIPOの協議をしていると報じられています。これは単なるお祭り騒ぎではなく、次のAIの波に向けた賢い資金のポジショニングです。📊 AIの大手企業がこの水準で入札を始めると、初期の投機的なトークンが暗号資産(crypto)で先陣を切ることがよくあります。
⚡ 分散型の注文帳では、すでに取引量がささやくように動いています。これは小口(リテール)のポンプではありません――機関投資家の気配です。💬 群衆が目を覚ます前にAIの物語を先回りしますか?それとも確証を待ちますか? 👇
⚠️ これは金融アドバイスではありません。常にリスク管理をしてください。 🛡️
🏷️ #KIMI #AI #PreIPO #Momentum #Crypto
🔥 🦈
💡 月の旗艦モデルのダークサイド(Dark Side of the Moon)は、$500億($50B)のバリュエーションでプレIPOの協議をしていると報じられています。これは単なるお祭り騒ぎではなく、次のAIの波に向けた賢い資金のポジショニングです。📊 AIの大手企業がこの水準で入札を始めると、初期の投機的なトークンが暗号資産(crypto)で先陣を切ることがよくあります。
⚡ 分散型の注文帳では、すでに取引量がささやくように動いています。これは小口(リテール)のポンプではありません――機関投資家の気配です。💬 群衆が目を覚ます前にAIの物語を先回りしますか?それとも確証を待ちますか? 👇
⚠️ これは金融アドバイスではありません。常にリスク管理をしてください。 🛡️
🏷️ #KIMI #AI #PreIPO #Momentum #Crypto
🔥 🦈
62
·
--
Kimi K3 はローンチから48時間で計算力クラスターを限界まで使い切り、個人メンバーの新規受付を一時停止します。
これは「製品が大ヒットした」系の祝報ではありません。AI の計算力における需要と供給の不均衡をリアルタイムに切り取ったスナップショットです。
Kimi の背後では大量に Alibaba Cloud の GPU が使われており、さらに Qwen チームのリソースをたびたび奪い合っています。Alibaba Cloud は昨四半期に 40% 超の成長。K3 のリリース前から、アジア太平洋最大のクラウドサービスとして“化け物級”の四半期実績だったのです。
これは何を意味するのでしょう?
1. 計算力は AI の軍拡競争における最大のボトルネックで、「ゆっくり増設すれば解決」といった話ではありません
2. クラウド事業者の GPU の生産能力が、大規模モデル企業に食い尽くされています
3. 今後、AI 企業の防御力(護城河)が必ずしも「モデルの能力」だとは限らず、「計算力の供給能力」になるかもしれません
Kimi はさらに会員制度も調整しました。主製品と Kimi Code の特典を別々に販売します。言い換えると——計算力が足りなくなったので、より細かく配分し始めたのです。
AI 業界の計算力に対する飢えと渇きは、まだ頂点に到達していません。計算力の供給を握る者が、AI 時代の“石油”を握るのです。
#AI #算力 #Kimi #阿里云
Kimi K3 はローンチから48時間で計算力クラスターを限界まで使い切り、個人メンバーの新規受付を一時停止します。
これは「製品が大ヒットした」系の祝報ではありません。AI の計算力における需要と供給の不均衡をリアルタイムに切り取ったスナップショットです。
Kimi の背後では大量に Alibaba Cloud の GPU が使われており、さらに Qwen チームのリソースをたびたび奪い合っています。Alibaba Cloud は昨四半期に 40% 超の成長。K3 のリリース前から、アジア太平洋最大のクラウドサービスとして“化け物級”の四半期実績だったのです。
これは何を意味するのでしょう?
1. 計算力は AI の軍拡競争における最大のボトルネックで、「ゆっくり増設すれば解決」といった話ではありません
2. クラウド事業者の GPU の生産能力が、大規模モデル企業に食い尽くされています
3. 今後、AI 企業の防御力(護城河)が必ずしも「モデルの能力」だとは限らず、「計算力の供給能力」になるかもしれません
Kimi はさらに会員制度も調整しました。主製品と Kimi Code の特典を別々に販売します。言い換えると——計算力が足りなくなったので、より細かく配分し始めたのです。
AI 業界の計算力に対する飢えと渇きは、まだ頂点に到達していません。計算力の供給を握る者が、AI 時代の“石油”を握るのです。
#AI #算力 #Kimi #阿里云
これは「製品が大ヒットした」系の祝報ではありません。AI の計算力における需要と供給の不均衡をリアルタイムに切り取ったスナップショットです。
Kimi の背後では大量に Alibaba Cloud の GPU が使われており、さらに Qwen チームのリソースをたびたび奪い合っています。Alibaba Cloud は昨四半期に 40% 超の成長。K3 のリリース前から、アジア太平洋最大のクラウドサービスとして“化け物級”の四半期実績だったのです。
これは何を意味するのでしょう?
1. 計算力は AI の軍拡競争における最大のボトルネックで、「ゆっくり増設すれば解決」といった話ではありません
2. クラウド事業者の GPU の生産能力が、大規模モデル企業に食い尽くされています
3. 今後、AI 企業の防御力(護城河)が必ずしも「モデルの能力」だとは限らず、「計算力の供給能力」になるかもしれません
Kimi はさらに会員制度も調整しました。主製品と Kimi Code の特典を別々に販売します。言い換えると——計算力が足りなくなったので、より細かく配分し始めたのです。
AI 業界の計算力に対する飢えと渇きは、まだ頂点に到達していません。計算力の供給を握る者が、AI 時代の“石油”を握るのです。
#AI #算力 #Kimi #阿里云
57
$KIMI DEMAND EXPLODES: GPU CAPACITY REACHED LIMIT IN 48 HOURS 🚨
Moonshot AIは、大規模な需要急増によりGPUの処理能力が48時間で限界に達したことを受けて、新たなKimi K3サブスクリプションを一時停止しました。7月16日のローンチ直後に、1,000,000トークンのコンテキストウィンドウを備えた28兆パラメータのモデルに前例のない関心が集まりました。
既存のサブスクリプションはアクティブなままです。Moonshotは、現在のメンバーに計算リソースのすべてを振り向けています。同社は、確定したタイムラインなしでアクセスを段階的に再開する計画です。この種の運用上のボトルネックは、誇大宣伝というより、実際のユーザー採用を示すことが多いです。
これは、AIインフラの需要が記録的な速さで供給を上回っているサインなのでしょうか?
投資助言ではありません。常にリスクを管理してください。
#KIMI #AI #GPU #DemandSurge #Crypto
🔥
$KIMI DEMAND EXPLODES: GPU CAPACITY REACHED LIMIT IN 48 HOURS 🚨
Moonshot AIは、大規模な需要急増によりGPUの処理能力が48時間で限界に達したことを受けて、新たなKimi K3サブスクリプションを一時停止しました。7月16日のローンチ直後に、1,000,000トークンのコンテキストウィンドウを備えた28兆パラメータのモデルに前例のない関心が集まりました。
既存のサブスクリプションはアクティブなままです。Moonshotは、現在のメンバーに計算リソースのすべてを振り向けています。同社は、確定したタイムラインなしでアクセスを段階的に再開する計画です。この種の運用上のボトルネックは、誇大宣伝というより、実際のユーザー採用を示すことが多いです。
これは、AIインフラの需要が記録的な速さで供給を上回っているサインなのでしょうか?
投資助言ではありません。常にリスクを管理してください。
#KIMI #AI #GPU #DemandSurge #Crypto
🔥
Moonshot AIは、大規模な需要急増によりGPUの処理能力が48時間で限界に達したことを受けて、新たなKimi K3サブスクリプションを一時停止しました。7月16日のローンチ直後に、1,000,000トークンのコンテキストウィンドウを備えた28兆パラメータのモデルに前例のない関心が集まりました。
既存のサブスクリプションはアクティブなままです。Moonshotは、現在のメンバーに計算リソースのすべてを振り向けています。同社は、確定したタイムラインなしでアクセスを段階的に再開する計画です。この種の運用上のボトルネックは、誇大宣伝というより、実際のユーザー採用を示すことが多いです。
これは、AIインフラの需要が記録的な速さで供給を上回っているサインなのでしょうか?
投資助言ではありません。常にリスクを管理してください。
#KIMI #AI #GPU #DemandSurge #Crypto
🔥
27
·
--
翻訳参照
美国又想给开源AI套缰绳了。Axios称,特朗普政府正悄悄评估限制中国开源模型,导火索是Moonshot AI的Kimi K3崛起。科技脱钩继续升级,风险偏好和AI叙事先吃监管溢价,别把每次拉升都当牛市发令枪。 #AI #Kimi $BTC
{future}(BTCUSDT)
美国又想给开源AI套缰绳了。Axios称,特朗普政府正悄悄评估限制中国开源模型,导火索是Moonshot AI的Kimi K3崛起。科技脱钩继续升级,风险偏好和AI叙事先吃监管溢价,别把每次拉升都当牛市发令枪。 #AI #Kimi $BTC
139
ログインして、さらにコンテンツを読む
厳選トピックで世界の暗号資産トレーダーの仲間入り
⚡️ 暗号資産に関する最新かつ有益な情報が見つかります。
💬 世界最大の暗号資産取引所から信頼されています。
👍 認証を受けたクリエイターから、有益なインサイトを得られます。
メール / 電話番号
トレンドトピック
1
#FCARaidsThreeLondonIllegalCryptoSites
閲覧回数 4
6人が討論中
2
#ElSalvadorBTCHoldingsRiseTo7777
閲覧回数 1,983
82人が討論中
3
#MemeLaunchpads82%OfArcDayOneVolume
閲覧回数 10,748
307人が討論中
4
#OstiumLoanDisputeHearingSetInNYFederalCourt
閲覧回数 10,939
261人が討論中
5
#HyperliquidUSDCSupplyOvertakesSolana
閲覧回数 1,668
87人が討論中
6
#SKPoliceRefer18PolymarketUsersToProsecutors
閲覧回数 8,447
261人が討論中
7
#FedSEPProjects2026RateAt4.1%
閲覧回数 20,702
369人が討論中
8
#USHouseAdvancesBitcoinReserveBill
閲覧回数 10,570
247人が討論中
9
#AmazonGetsWarrantsToBuyGeneracStock
閲覧回数 10,233
224人が討論中
10
#DotPlotSignalsOneMoreHikeIn2026
閲覧回数 35,085
616人が討論中