

#dataprovenance
dataprovenance
閲覧回数 640
9人が討論中
注目
最新
·
--
@Openledger が私にとって興味深いのは、AIに対するアプローチがほとんどのプロジェクトが避ける方向性、すなわちエントロピーから来ていることです。
AIシステムがスケールするにつれて、インターネットは合成コンテンツ、重複データセット、再帰的に生成されたノイズで saturate しています。問題はもはや情報へのアクセスではありません。問題は、その情報がまだ信号を持っているかどうかを確認することです。
それがAIの経済を完全に変えてしまいます。
何年も業界は大きなモデルが自動的により良い結果を生むと仮定していました。しかし、モデルのスケーリングはすでに効率の限界に達しています。トレーニングコストは指数関数的に上昇し、利得はますます増分的になります。同時に、高品質の人間生成データは、AIシステムが同じ情報ループを繰り返し消費し再生産しているため、正確に言えば、ますます希少になっています。
ここで#OpenLedger の背後にあるアトリビューションレイヤーが、人々が認識している以上に重要になるのです。
もし寄与者、データセット、知識源がAIパイプライン内で経済的に追跡可能になれば、信頼できるデータの出所自体が競争優位性に変わるかもしれません。最大のモデルでもなく、最も騒がしいナラティブでもなく、最もクリーンな信号です。
歴史的に見て、すべての主要な情報経済は最終的に検証インフラを構築しました:
金融市場は監査を構築し、
インターネットは検索ランキングを構築し、
ブロックチェーンはコンセンサスを構築しました。
AIも今、自らの検証時代に近づいているかもしれません。
それが$OPEN が標準的なAIトークンのナラティブのように感じず、モデル、データ、そして人間の貢献の間の信頼危機を解決しようとする試みのように感じる理由です。
#OpenLedger #AIInfrastructure #DataProvenance #SyntheticData #AIAlignmen
@OpenLedger が私にとって興味深いのは、AIに対するアプローチがほとんどのプロジェクトが避ける方向性、すなわちエントロピーから来ていることです。
AIシステムがスケールするにつれて、インターネットは合成コンテンツ、重複データセット、再帰的に生成されたノイズで saturate しています。問題はもはや情報へのアクセスではありません。問題は、その情報がまだ信号を持っているかどうかを確認することです。
それがAIの経済を完全に変えてしまいます。
何年も業界は大きなモデルが自動的により良い結果を生むと仮定していました。しかし、モデルのスケーリングはすでに効率の限界に達しています。トレーニングコストは指数関数的に上昇し、利得はますます増分的になります。同時に、高品質の人間生成データは、AIシステムが同じ情報ループを繰り返し消費し再生産しているため、正確に言えば、ますます希少になっています。
ここで#OpenLedger の背後にあるアトリビューションレイヤーが、人々が認識している以上に重要になるのです。
もし寄与者、データセット、知識源がAIパイプライン内で経済的に追跡可能になれば、信頼できるデータの出所自体が競争優位性に変わるかもしれません。最大のモデルでもなく、最も騒がしいナラティブでもなく、最もクリーンな信号です。
歴史的に見て、すべての主要な情報経済は最終的に検証インフラを構築しました:
金融市場は監査を構築し、
インターネットは検索ランキングを構築し、
ブロックチェーンはコンセンサスを構築しました。
AIも今、自らの検証時代に近づいているかもしれません。
それが$OPEN が標準的なAIトークンのナラティブのように感じず、モデル、データ、そして人間の貢献の間の信頼危機を解決しようとする試みのように感じる理由です。
#OpenLedger #AIInfrastructure #DataProvenance #SyntheticData #AIAlignmen
1
53

·
--
本人確認中
#openledger $OPEN
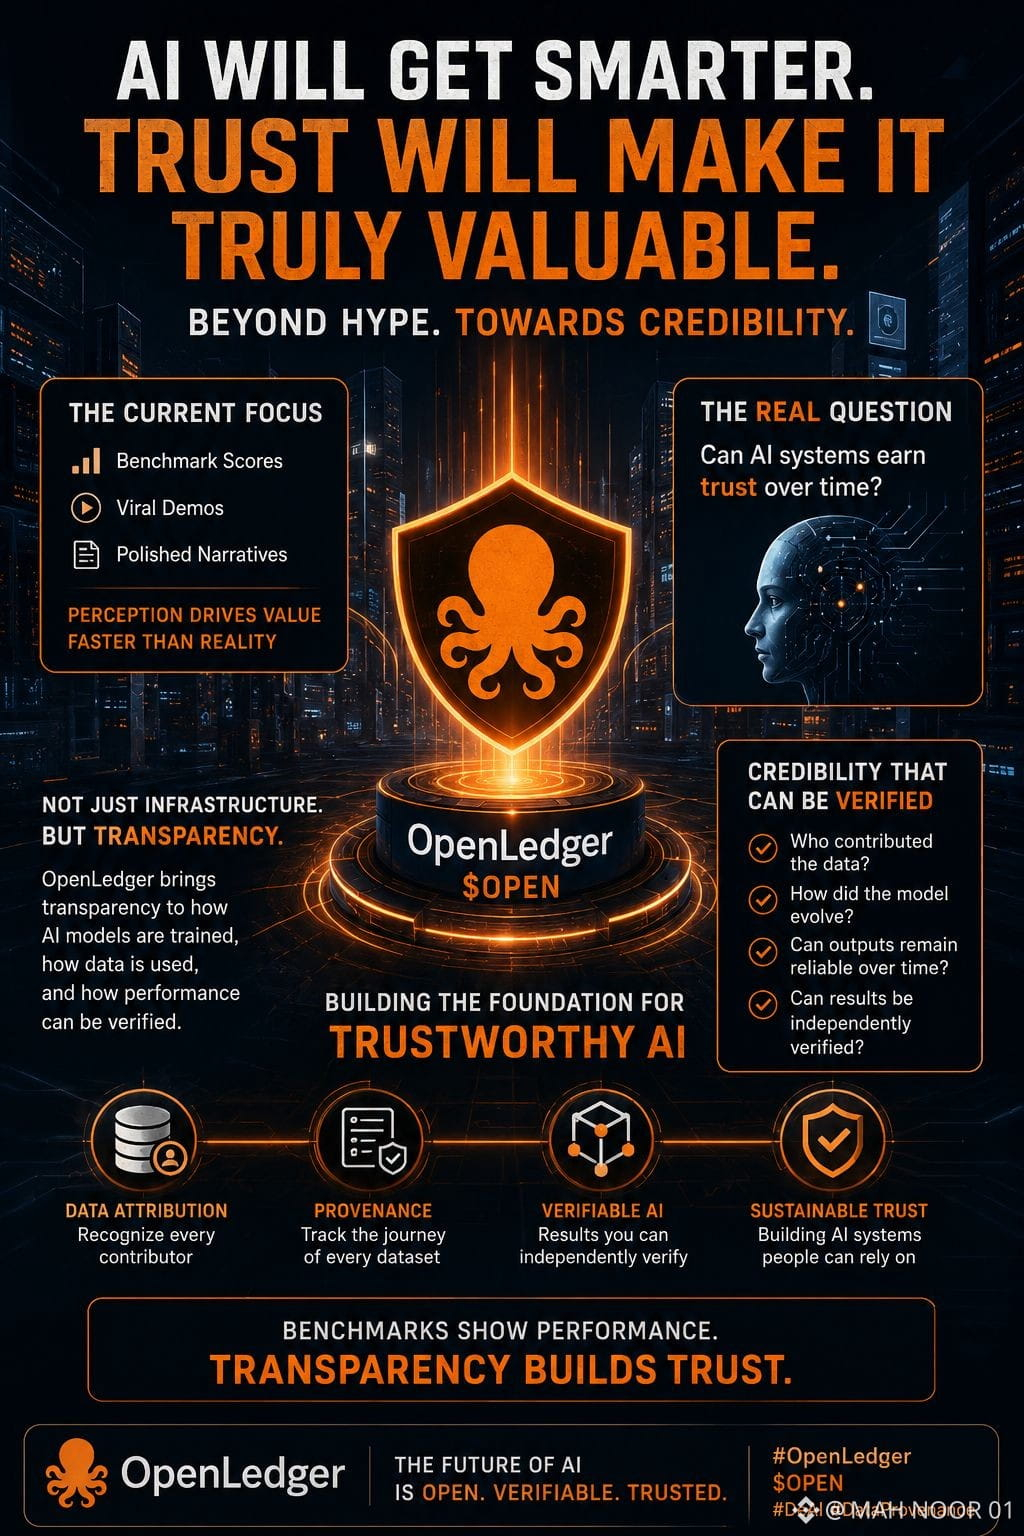
ほとんどの人はAIがどれだけ強力になっているかに焦点を当てています。
私が思うに、より大きな疑問はAIシステムが時間と共に実際に信頼を得ることができるかどうかです。
今のところ、注目は通常ベンチマークスコア、バイラルデモ、そして洗練されたストーリーに向けられています。モデルは紙の上ではうまく機能し、市場は即座に反応し、認識は現実世界の信頼性よりも早く価値を生み出し始めます。
しかし最終的には、ハイプに基づいて構築されたシステムは、一貫性ではなく可視性を最適化するインセンティブを生み出します。
だから、OpenLedger ($OPEN) のようなプロジェクトが面白いと思うのです。
そのアイデアはAIインフラを支えるだけではなく、モデルがどのようにトレーニングされ、データがどこから来ているのか、そしてパフォーマンスの主張がマーケティングを超えて検証可能かどうかという透明性を作り出すことです。
もし属性や出所がエコシステム自体に埋め込まれるなら、信頼性は仮定されるのではなく測定可能になります。
誰がデータに貢献したのか?
モデルはどのように進化したのか?
出力は時間と共に信頼性を保てるのか?
結果は独立して検証できるのか?
これらの質問は、ベンチマークのスクリーンショットよりも重要になるかもしれません。
AIはこれからも賢くなり続けますが、AIを信頼できるものにする手助けをするプラットフォームは、長期的にはさらに価値が高くなる可能性があります。
#OpenLedger $OPEN #DeAI #DataProvenance
#BinanceSquare
{future}(OPENUSDT)
#openledger $OPEN
ほとんどの人はAIがどれだけ強力になっているかに焦点を当てています。
私が思うに、より大きな疑問はAIシステムが時間と共に実際に信頼を得ることができるかどうかです。
今のところ、注目は通常ベンチマークスコア、バイラルデモ、そして洗練されたストーリーに向けられています。モデルは紙の上ではうまく機能し、市場は即座に反応し、認識は現実世界の信頼性よりも早く価値を生み出し始めます。
しかし最終的には、ハイプに基づいて構築されたシステムは、一貫性ではなく可視性を最適化するインセンティブを生み出します。
だから、OpenLedger ($OPEN ) のようなプロジェクトが面白いと思うのです。
そのアイデアはAIインフラを支えるだけではなく、モデルがどのようにトレーニングされ、データがどこから来ているのか、そしてパフォーマンスの主張がマーケティングを超えて検証可能かどうかという透明性を作り出すことです。
もし属性や出所がエコシステム自体に埋め込まれるなら、信頼性は仮定されるのではなく測定可能になります。
誰がデータに貢献したのか?
モデルはどのように進化したのか?
出力は時間と共に信頼性を保てるのか?
結果は独立して検証できるのか?
これらの質問は、ベンチマークのスクリーンショットよりも重要になるかもしれません。
AIはこれからも賢くなり続けますが、AIを信頼できるものにする手助けをするプラットフォームは、長期的にはさらに価値が高くなる可能性があります。
#OpenLedger $OPEN #DeAI #DataProvenance
#BinanceSquare
32
14
1.1k

·
--
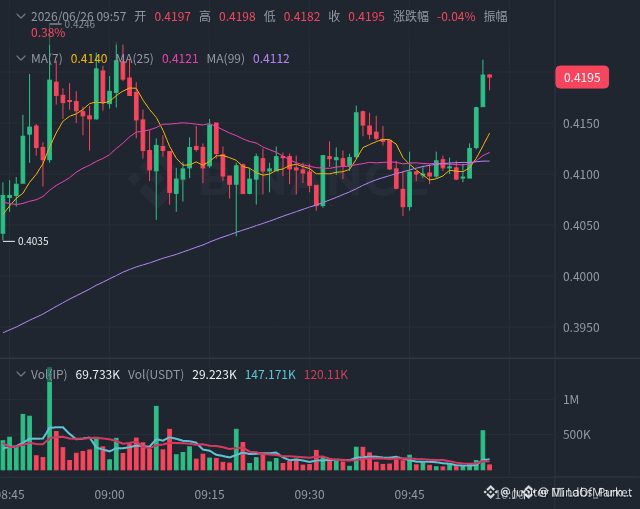
$IP SURGES 25%+ ON REBRAND TO DATA FOUNDATION – クジラの活動を検知 🔥
この動きは、基本的な触媒によって引き起こされています。AI学習データの信頼レイヤーとしてDATAネットワークへ移行し、10億件超のレコードを追跡していることです。発表とともに出来高が急増し、25〜30%のポンプや、アクティブなブレイクアウト構造が形成されつつあるとの報告があります。
今の重要な問いは、これが単発の流動性回収なのか、それとも継続的なトレンドの始まりなのかです。クジラの動きやFOMO(追随買い)が見られる中、現行水準は継続のためのサポートとして維持される必要があります。
投資助言ではありません。常にリスク管理を行ってください。
#IP #Rebrand #AI #DataProvenance #Breakout
🔥
190

記事
OpenLedgerは、歴史のない知性はただの推測に過ぎないと考えています。こちらがプロフェッショナルで魅力的、かつ簡潔なあなたのドラフトの英語版で、Binance Squareにぴったりな見出しと絵文字で最適化されています:
## 🧠 歴史のない知性はただの推測に過ぎない!
あなたのAIが実際にどこから回答を得ているのか、考えたことはありますか?🤔 業界全体がよりスマートなモデルや高速な推論の構築に夢中ですが、最も重要な要素である **信頼と系譜** を見逃しています。
AIの出力は非常に洗練されているように聞こえるかもしれませんが、その知識のソースを確認できなければ、結局は非常に正確な推測に過ぎません。🎯
OpenLedgerは、歴史のない知性はただの推測に過ぎないと考えています。
こちらがプロフェッショナルで魅力的、かつ簡潔なあなたのドラフトの英語版で、Binance Squareにぴったりな見出しと絵文字で最適化されています:
## 🧠 歴史のない知性はただの推測に過ぎない!
あなたのAIが実際にどこから回答を得ているのか、考えたことはありますか?🤔 業界全体がよりスマートなモデルや高速な推論の構築に夢中ですが、最も重要な要素である **信頼と系譜** を見逃しています。
AIの出力は非常に洗練されているように聞こえるかもしれませんが、その知識のソースを確認できなければ、結局は非常に正確な推測に過ぎません。🎯
## 🧠 歴史のない知性はただの推測に過ぎない!
あなたのAIが実際にどこから回答を得ているのか、考えたことはありますか?🤔 業界全体がよりスマートなモデルや高速な推論の構築に夢中ですが、最も重要な要素である **信頼と系譜** を見逃しています。
AIの出力は非常に洗練されているように聞こえるかもしれませんが、その知識のソースを確認できなければ、結局は非常に正確な推測に過ぎません。🎯
37
7
138
·
--
記事
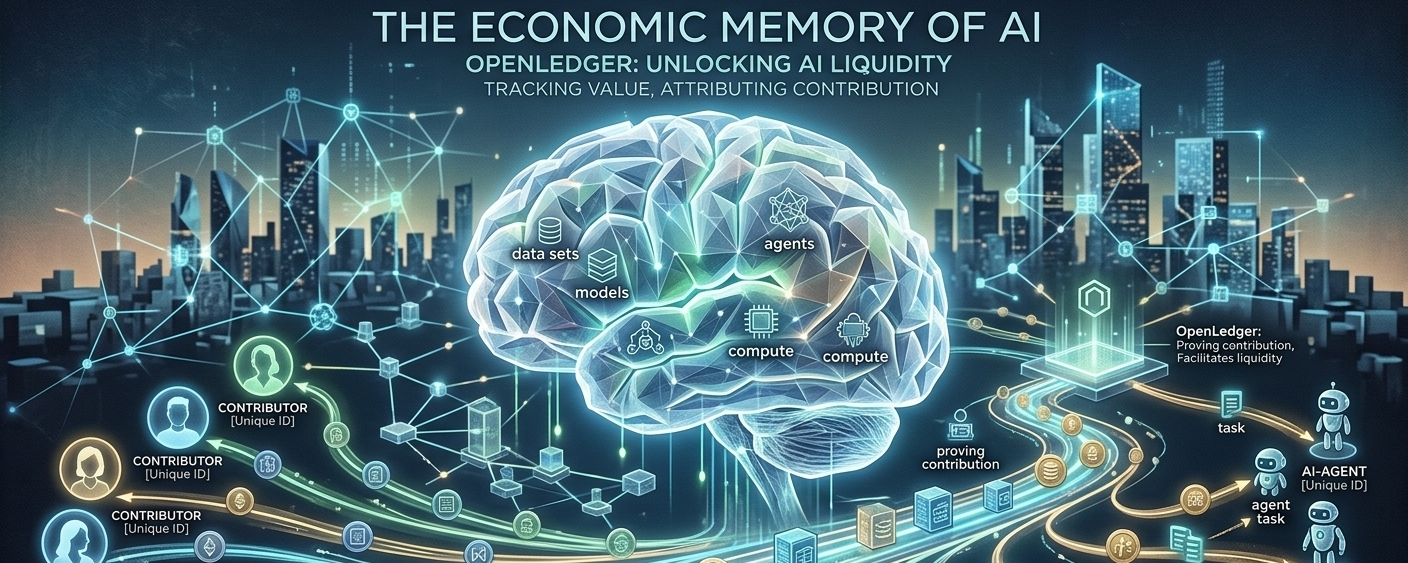
AIの経済的記憶:なぜOpenLedgerのデータ帰属モデルが重要なのかWeb3スペースを見渡してみると、繰り返しのある、ほとんど疲れるようなパターンに気づくでしょう:クリプトは人間の行動問題を単純なエンジニアリングタスクとして扱うのが大好きです。
新しいプロジェクトが現れ、重いホワイトペーパーをドロップし、建築用語で満たされた瞬間、皆がクリーンコードが壊れた人間のインセンティブを魔法のように修正できるかのように振る舞います。しかし、それはこれまで一度も実現したことがありません。そして、これからも実現しないでしょう。
デジタル経済の本当の、醜い真実はもっとシンプルでありながら、解決が難しいことです:人々は常に価値を生み出していますが、システムは誰が実際にクレジットを受けるべきかを追跡するのに一貫して失敗しています。
AIの経済的記憶:なぜOpenLedgerのデータ帰属モデルが重要なのか
Web3スペースを見渡してみると、繰り返しのある、ほとんど疲れるようなパターンに気づくでしょう:クリプトは人間の行動問題を単純なエンジニアリングタスクとして扱うのが大好きです。
新しいプロジェクトが現れ、重いホワイトペーパーをドロップし、建築用語で満たされた瞬間、皆がクリーンコードが壊れた人間のインセンティブを魔法のように修正できるかのように振る舞います。しかし、それはこれまで一度も実現したことがありません。そして、これからも実現しないでしょう。
デジタル経済の本当の、醜い真実はもっとシンプルでありながら、解決が難しいことです:人々は常に価値を生み出していますが、システムは誰が実際にクレジットを受けるべきかを追跡するのに一貫して失敗しています。
新しいプロジェクトが現れ、重いホワイトペーパーをドロップし、建築用語で満たされた瞬間、皆がクリーンコードが壊れた人間のインセンティブを魔法のように修正できるかのように振る舞います。しかし、それはこれまで一度も実現したことがありません。そして、これからも実現しないでしょう。
デジタル経済の本当の、醜い真実はもっとシンプルでありながら、解決が難しいことです:人々は常に価値を生み出していますが、システムは誰が実際にクレジットを受けるべきかを追跡するのに一貫して失敗しています。
11
82
ログインして、さらにコンテンツを読む
厳選トピックで世界の暗号資産トレーダーの仲間入り
⚡️ 暗号資産に関する最新かつ有益な情報が見つかります。
💬 世界最大の暗号資産取引所から信頼されています。
👍 認証を受けたクリエイターから、有益なインサイトを得られます。
メール / 電話番号
トレンドトピック
1
#UKFCAWinsCourtOrderToRecover851400Pounds
閲覧回数 220
74人が討論中
2
#ChainlinkLaunchesCCIP2WithEnterpriseVerification
閲覧回数 7,131
401人が討論中
3
#GoldFallsTo$4144
閲覧回数 3,926
98人が討論中
4
#QNTFallsOver40%FromMorningHigh
閲覧回数 32,526
800人が討論中
5
#USDTAdds845900HoldersInPast7Days
閲覧回数 865
94人が討論中
6
#KospiFalls2.7%SamsungSKHynixDropOver5%
閲覧回数 6,656
360人が討論中
7
#BitgetCEOConfirms$388MStolenInHack
閲覧回数 2,703
36人が討論中
8
#BTCFallsBelow$83000
閲覧回数 16,658
137人が討論中
9
#BitgetDetailsSecurityIncidentTimeline
閲覧回数 18,547
520人が討論中
10
#BitcoinSpotETFs$2.39BWeeklyNetInflow
閲覧回数 7,060
34人が討論中