

Web3スペースを見渡してみると、繰り返しのある、ほとんど疲れるようなパターンに気づくでしょう:クリプトは人間の行動問題を単純なエンジニアリングタスクとして扱うのが大好きです。
新しいプロジェクトが現れ、重いホワイトペーパーをドロップし、建築用語で満たされた瞬間、皆がクリーンコードが壊れた人間のインセンティブを魔法のように修正できるかのように振る舞います。しかし、それはこれまで一度も実現したことがありません。そして、これからも実現しないでしょう。
デジタル経済の本当の、醜い真実はもっとシンプルでありながら、解決が難しいことです:人々は常に価値を生み出していますが、システムは誰が実際にクレジットを受けるべきかを追跡するのに一貫して失敗しています。
Web2はこの抽出的な関係をマスターしました。ユーザーはデータを生成し、クリックでアルゴリズムを微調整し、デジタルランドスケープを構築しました。プラットフォームは99%の財務的利益をキャッチしました。今、人工知能がこの部屋に入ってきており、この価値捕獲の危機を無限に複雑にしています。
AIはデータを消費するだけではありません。AIは人間の貢献を消費します。
機械知能のブラックボックス
AIの出力、つまりコードの行、デジタルアートの一部、または取引戦略を見たとき、あなたは洗練された最終製品を見ています。あなたが見えないのは、その背後にある混沌とした断片化された機械です。
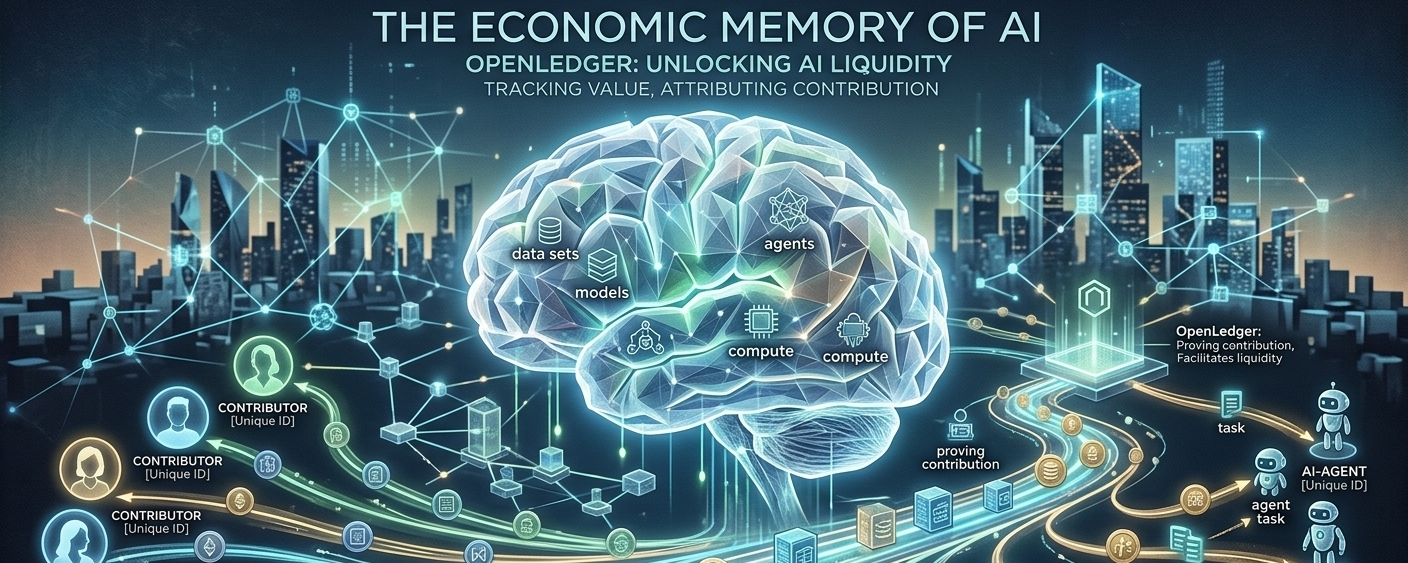
AIの出力は、別々の世界の衝突です:
データ注入:数千の個々の手によってキュレーションされた大規模なデータセット。
モデルアーキテクチャ:研究者によって設計されたニューラルネットワーク。
コンピュートインフラストラクチャ:膨大なスケールでデータを処理する重いハードウェア。
自律エージェント:マイクロタスクを実行する専門的なエンティティ。
伝統的な製造業では、供給チェーンがあります。自動車メーカーは、すべてのネジ、革の部分、マイクロチップがどこから来たのかを正確に知っています。所有権は明確で法的な境界を持っています。
AIはその境界を完全に曖昧にします。データをソースAから取り、クリエイターBからモデルを取得し、プロバイダーCからコンピュートを使用し、すべての元の貢献者が見えない完璧なユーザー体験を提供します。
これは倫理的な問題だけではなく、大きな経済的ボトルネックです。参加者が自分の入力が追跡可能な報酬を生まないことに気づくと、経済は停止します。
OpenLedgerに登場:ナラティブではなく調整レイヤーを構築する
これはOpenLedgerが修正しようとしている正確な傷です。彼らは別の空虚なAIナラティブを立ち上げるわけでも、一時的なトークンストーリーをポンプするわけでもありません。彼らは、もっと退屈でありながら完全に危険な質問をしています:
知性自体に関する経済的な記憶をどのように作成しますか?
暗号のバズワードを取り除くと、OpenLedgerの核心的な主張は単純です:AIシステムは入力に基づいて動作します。それらの入力は実際の貢献者から来ています。したがって、貢献者はそのAIの経済的ライフサイクルの中に恒久的で測定可能な足跡を持つ必要があります。
データセット、モデル、エージェントを企業のブラックボックスに消失させるのではなく、OpenLedgerは分散型の調整レイヤーとして自らを位置づけています。これらの要素を孤立したツールとしてではなく、アクティブで可視的な経済的参加者として扱います。
現代の供給チェーンの前の物流のように考えてください。工場、船、原材料は常に存在していましたが、調整は壊れていました。可視性の欠如により価値が漏れました。OpenLedgerはAIの知性を発明しようとしているのではなく、それを整理しようとしています。
トークノミクストラップ:運動と牽引を区別する
しかし、完全に率直に言いましょう。この分野での実行は地雷原であり、OpenLedgerは多くの有望なWeb3エコシステムを破壊してきた同じ存在の脅威に直面しています:インセンティブのゲーミフィケーション。
暗号は表面的なメトリックに恋をする悪い癖があります。私たちはDuneダッシュボードを見つめ、取引量、アクティブウォレットの数、爆発的なソーシャルメディアのエンゲージメントを見て、プロジェクトが勝っていると自分を納得させます。
私たちはこれを以前に見たことがあります。私たちはDeFi流動性マイニングで、Play-to-Earn(P2E)ゲームでそれを見ました。エコシステムは報酬が枯渇するまで巨大に見えましたが、その後ユーザーは一夜にして消えました。彼らはファーミングと本当の市場の需要を混同しました。
データとAIへの貢献を測定可能にした瞬間、ユーザーはマインドセットを変えます。「どうすれば本当に役立つ貢献ができるか?」ではなく、「アルゴリズムを操作して報酬を最大化するにはどうすればいいか?」と尋ね始めます。
ブロックチェーンの台帳上では、シビルボットファームと高品質な人間データ貢献者は恐ろしいほど似ているように見えることがあります。偽のボリュームはネットワークの健康を装い、本物の有機的なユーティリティはノイズに埋もれます。
OpenLedgerが答えなければならない容赦のない質問
優れた技術が市場で勝つことは稀です。便利さ、スピード、シンプルさが勝ちます。OpenLedgerがその初期のインセンティブフェーズを過ぎて生き残りたいなら、ほとんどのハイプ駆動プロジェクトが無視する地味な質問に答えなければなりません:
クオリティ対ノイズ:プロトコルは、報酬を得るためだけに設計された合成データやゴミデータをどのようにフィルタリングしますか?
細分化された帰属:AIモデルが50,000の異なるデータ入力を使用して単一の価値ある出力を生成する場合、マイクロ報酬をどのように公正に分割しますか?
プライバシー対出所:ユーザーのプライバシーを損なうことなく、データの系譜と帰属をどのように追跡しますか?
外部価値の流入:エコシステムは持続可能な外部収益をどのように引き入れ、価値が閉じ込められた投機的な循環の中で回転しないようにしますか?
結論:忘却は高くつく
OpenLedgerは保証されたホームランではありませんが、空虚なハイプマシンでもありません。それは重要な中間地点に位置しています。今後10年間で、知性自体が流動的で取引可能な資産クラスになるという長期的なマクロベットを行っています。
その賭けが正しければ、AIデータを扱う伝統的な方法は完全に持続可能ではありません。クレジットされず、追跡されない人間の貢献の上に世界的な知性の未来を築くことはできません。
最終的に、OpenLedgerの成功はここでの主なストーリーラインではないかもしれません。真の教訓は、将来のAI経済は、自らを構築した人々を記憶するシステムを絶対に必要とするということです。知性が世界的な富の主要なドライバーになるとき、それに貢献した人々を忘れることは単に高くつくことになります。