Baru saja meninjau kasus teknis NodeGhost dari @Acurast dan menemukan hasil pengujian yang cukup menarik.
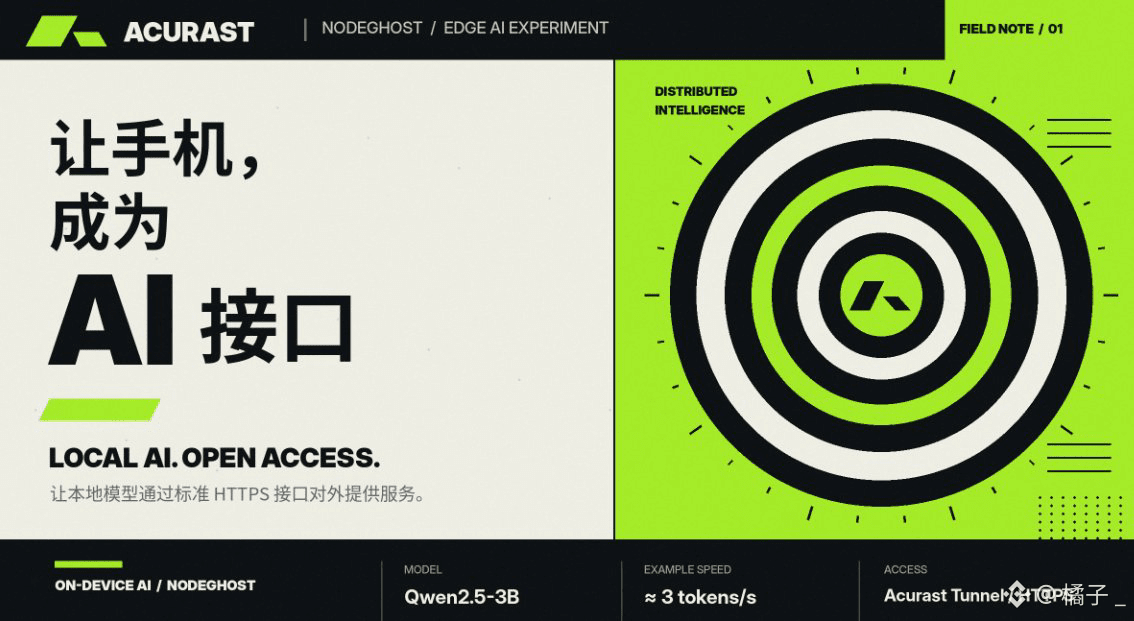
Sebuah ponsel menjalankan model Qwen2.5-3B yang telah dikuantisasi, dengan kecepatan generasi sekitar 3 Token per detik.
Untuk menjawab pertanyaan sekitar 120 Token, dibutuhkan waktu kira-kira 45 detik.
Dibandingkan dengan pengalaman menggunakan model besar saat ini, kecepatan ini memang agak lambat.
Namun, hal yang menarik perhatian saya dari kasus ini adalah desain lain.
Melalui Acurast Tunnel, model yang sebelumnya tersembunyi di ponsel lokal dan tidak memiliki IP publik dapat menyediakan antarmuka HTTPS untuk akses eksternal.
Setelah itu, dengan menghubungkan API yang kompatibel dengan OpenAI dari NodeGhost, pengembang hampir tidak perlu mengubah cara pemanggilan yang sudah ada untuk mengirim permintaan agar diproses di ponsel.
Dengan begitu, ponsel bukan lagi sekadar Processor yang pasif menunggu pembagian tugas di jaringan, tetapi juga dapat menyediakan layanan inferensi AI terstandardisasi bagi pihak luar.
Tentu saja, saat ini kasus ini masih berupa implementasi referensi di jaringan Canary, dengan keterbatasan yang cukup jelas dalam hal kecepatan dan kemampuan menangani penalaran kompleks.
Namun, menurut saya, kasus ini sudah menjawab pertanyaan yang sangat praktis:
Jika pengembang ingin menerapkan model mereka di ponsel terdistribusi, bisakah aplikasi yang sudah ada mengaksesnya dengan mudah?
Setidaknya, jalur teknis ini sudah memiliki contoh yang dapat dijalankan.
Untuk komersialisasi, masih perlu dilakukan validasi lebih lanjut terhadap latensi, konkurensi, biaya, dan stabilitas jangka panjang.
$ACU dari Acurast berperan dalam menghubungkan penggunaan jaringan dengan insentif komputasi. Namun, apakah pada akhirnya dapat menarik permintaan berbayar, masih bergantung pada daya saing nyata aplikasi-aplikasi tersebut.
Sebuah ponsel menjalankan model Qwen2.5-3B yang telah dikuantisasi, dengan kecepatan generasi sekitar 3 Token per detik.
Untuk menjawab pertanyaan sekitar 120 Token, dibutuhkan waktu kira-kira 45 detik.
Dibandingkan dengan pengalaman menggunakan model besar saat ini, kecepatan ini memang agak lambat.
Namun, hal yang menarik perhatian saya dari kasus ini adalah desain lain.
Melalui Acurast Tunnel, model yang sebelumnya tersembunyi di ponsel lokal dan tidak memiliki IP publik dapat menyediakan antarmuka HTTPS untuk akses eksternal.
Setelah itu, dengan menghubungkan API yang kompatibel dengan OpenAI dari NodeGhost, pengembang hampir tidak perlu mengubah cara pemanggilan yang sudah ada untuk mengirim permintaan agar diproses di ponsel.
Dengan begitu, ponsel bukan lagi sekadar Processor yang pasif menunggu pembagian tugas di jaringan, tetapi juga dapat menyediakan layanan inferensi AI terstandardisasi bagi pihak luar.
Tentu saja, saat ini kasus ini masih berupa implementasi referensi di jaringan Canary, dengan keterbatasan yang cukup jelas dalam hal kecepatan dan kemampuan menangani penalaran kompleks.
Namun, menurut saya, kasus ini sudah menjawab pertanyaan yang sangat praktis:
Jika pengembang ingin menerapkan model mereka di ponsel terdistribusi, bisakah aplikasi yang sudah ada mengaksesnya dengan mudah?
Setidaknya, jalur teknis ini sudah memiliki contoh yang dapat dijalankan.
Untuk komersialisasi, masih perlu dilakukan validasi lebih lanjut terhadap latensi, konkurensi, biaya, dan stabilitas jangka panjang.
$ACU dari Acurast berperan dalam menghubungkan penggunaan jaringan dengan insentif komputasi. Namun, apakah pada akhirnya dapat menarik permintaan berbayar, masih bergantung pada daya saing nyata aplikasi-aplikasi tersebut.