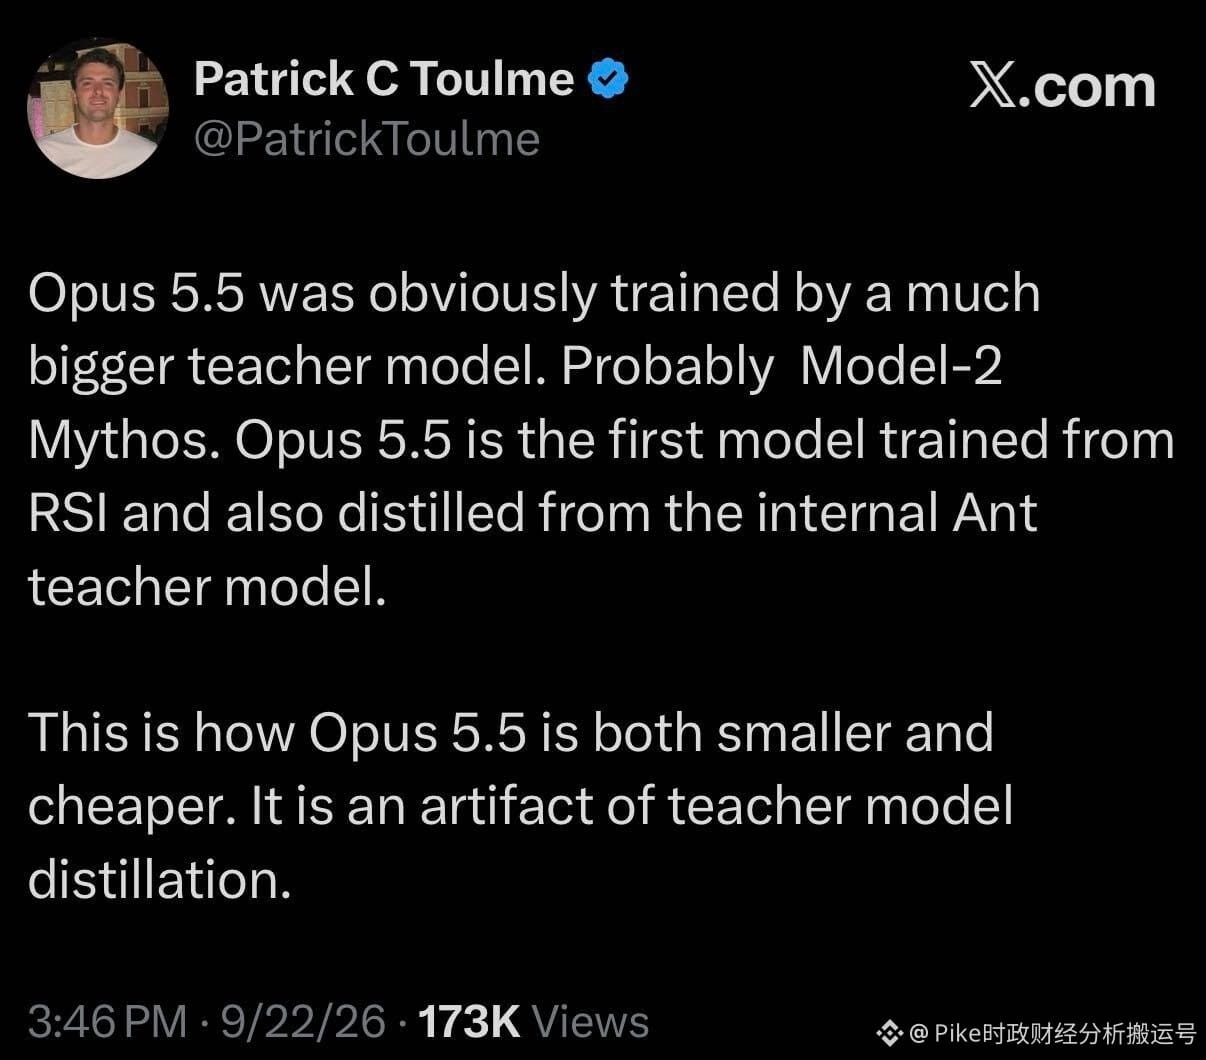
Baru-baru ini, seorang insinyur perangkat lunak dari tim Google TPU bernama Patrick C. Toulme membagikan sebuah pandangan yang menarik perhatian. Ia berpendapat bahwa Opus 5.5 bisa mempertahankan performa yang sangat baik meski ukurannya lebih kecil dan biayanya lebih rendah, kemungkinan besar berkat teknologi RSI (recursive self-improvement) dan diproses melalui teknik distilasi dengan sebuah model guru internal yang ukurannya jauh lebih besar. Menurut dugaannya, model guru misterius tersebut mungkin adalah Model-2 Mythos. Namun, terkait jalur pelatihan spesifik ini, pihak resmi Anthropic saat ini belum memberikan bukti yang pasti.
Terhadap spekulasi semacam ini, saya pribadi sangat setuju. Menggabungkan RSI dengan teknik distilasi menandai sebuah gagasan riset yang sangat menjanjikan: melibatkan model yang kemampuannya paling unggul dalam pengembangan AI generasi berikutnya, lalu memindahkan kemampuan kuat yang telah terbukti itu ke produk dengan biaya yang lebih ramah. Ini berarti laboratorium riset di garis depan bisa menjalankan dua hal sekaligus—terus menerobos dan memperbesar skala pelatihan model-model terdepan sambil secara efektif menurunkan biaya inferensi yang benar-benar ditanggung pengguna akhir. Dua pekerjaan ini bukan saling bertentangan, melainkan bisa berjalan seiring.
Selain itu, LLM yang paling mutakhir mampu menurunkan biaya inferensi tanpa mengorbankan performa, yang jelas semakin memperkuat logika bullish bahwa unit economics laboratorium AI bisa lebih baik daripada perkiraan pasar. Selama harga yang lebih terjangkau berhasil mendorong lonjakan skala penerapan di sisi perusahaan serta meningkatnya jumlah pemanggilan Agent, dan laju pertumbuhan tersebut cukup untuk menutup bagian penurunan konsumsi komputasi yang terkait dengan satu tugas, maka itu akan memberikan dorongan berkelanjutan bagi infrastruktur dasar seluruh rantai industri. Dengan demikian, permintaan pasar—termasuk untuk semikonduktor AI, perangkat penyimpanan, dan perangkat keras jaringan—akan mendapat dukungan yang lebih kuat.