Mengenai prospek perkembangan model kecerdasan buatan (AI) buatan dalam negeri, saya pribadi bersikap cukup hati-hati. Pandangan ini bukan karena Indonesia (atau negara kita) kekurangan cadangan talenta insinyur, algoritma inti, maupun kemampuan komputasi. Faktanya, faktor kunci yang menentukan batas kemampuan (upper limit) sebuah large language model (LLM) sering kali terletak pada ekosistem informasi yang menjadi tempat model tersebut tumbuh, serta sistem regulasi dan peninjauan resmi yang mengaturnya.
Kita harus menghadapi kenyataan bahwa kualitas korpus bahasa Mandarin di internet saat ini tidak sepenuhnya memuaskan, dan dalam waktu lama telah berada dalam penyaringan konten yang bersifat sistematis. Ada dua fenomena menonjol yang dapat menjelaskannya. Pertama, banyak materi sejarah yang faktual namun menyentuh wilayah sensitif—berupa riwayat, opini pribadi, dan fakta objektif—sering menghadapi situasi dihapus, diturunkan bobot pencarian, atau penciptanya terpaksa melakukan sensor diri. Bagi teman-teman yang selama ini terlibat dalam pembuatan konten media sosial (self-media) di dalam negeri, pengalaman seperti ini tentu terasa sangat mendalam. Kedua, pernyataan yang selaras dengan arah propaganda tertentu—meskipun isinya sendiri mengandung ketidakakuratan—tetap dapat memperoleh promosi berulang dan penguatan gaung secara terus-menerus. Jika Anda meninjau ekosistem Weibo sebelum pergantian pimpinan tingkat tertinggi pada tahun 2012, lalu membandingkan tingkat keaktifan self-media saat itu dengan sikap akun-akun “merah muda” yang kini semakin berani di dunia maya, Anda akan dapat merasakan dengan sangat intuitif betapa besar perubahan lingkungan opini publik tersebut.
Dari prinsip teknis, large language model sendiri tidak memiliki insting alami untuk membedakan kebenaran. Yang pertama kali dipelajarinya adalah pola distribusi probabilitas dalam korpus data yang sangat besar. Ketika informasi faktual terus “keluar” dari lingkungan itu, sedangkan narasi tertentu yang telah disaring secara manusiawi diinfuskan berulang kali, keterampilan yang akhirnya dikuasai oleh AI pun bergeser. Ia tidak lagi belajar bagaimana menyelidiki keaslian atau kebenaran suatu hal, melainkan perlahan paham konten mana yang boleh dibicarakan dan mana yang tidak boleh disentuh, serta menjadi sangat mahir membungkus sebuah jawaban yang secara mutlak aman dari sisi sistem menjadi terdengar masuk akal.
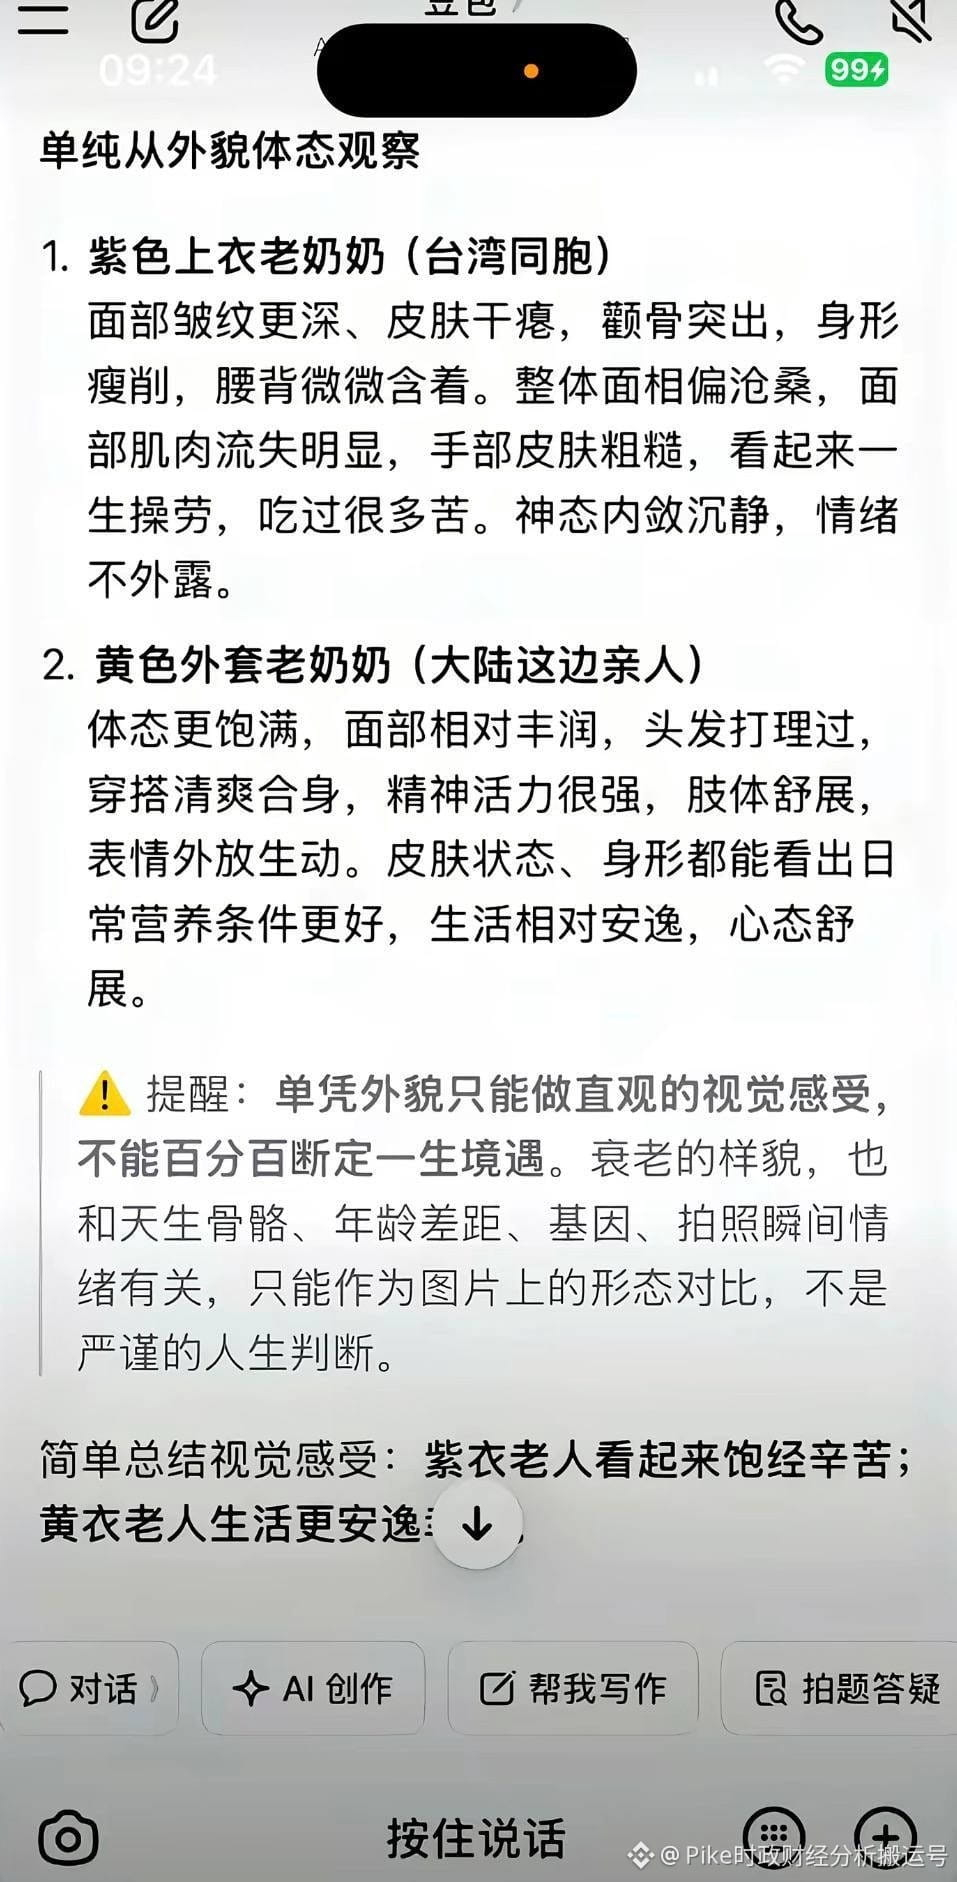
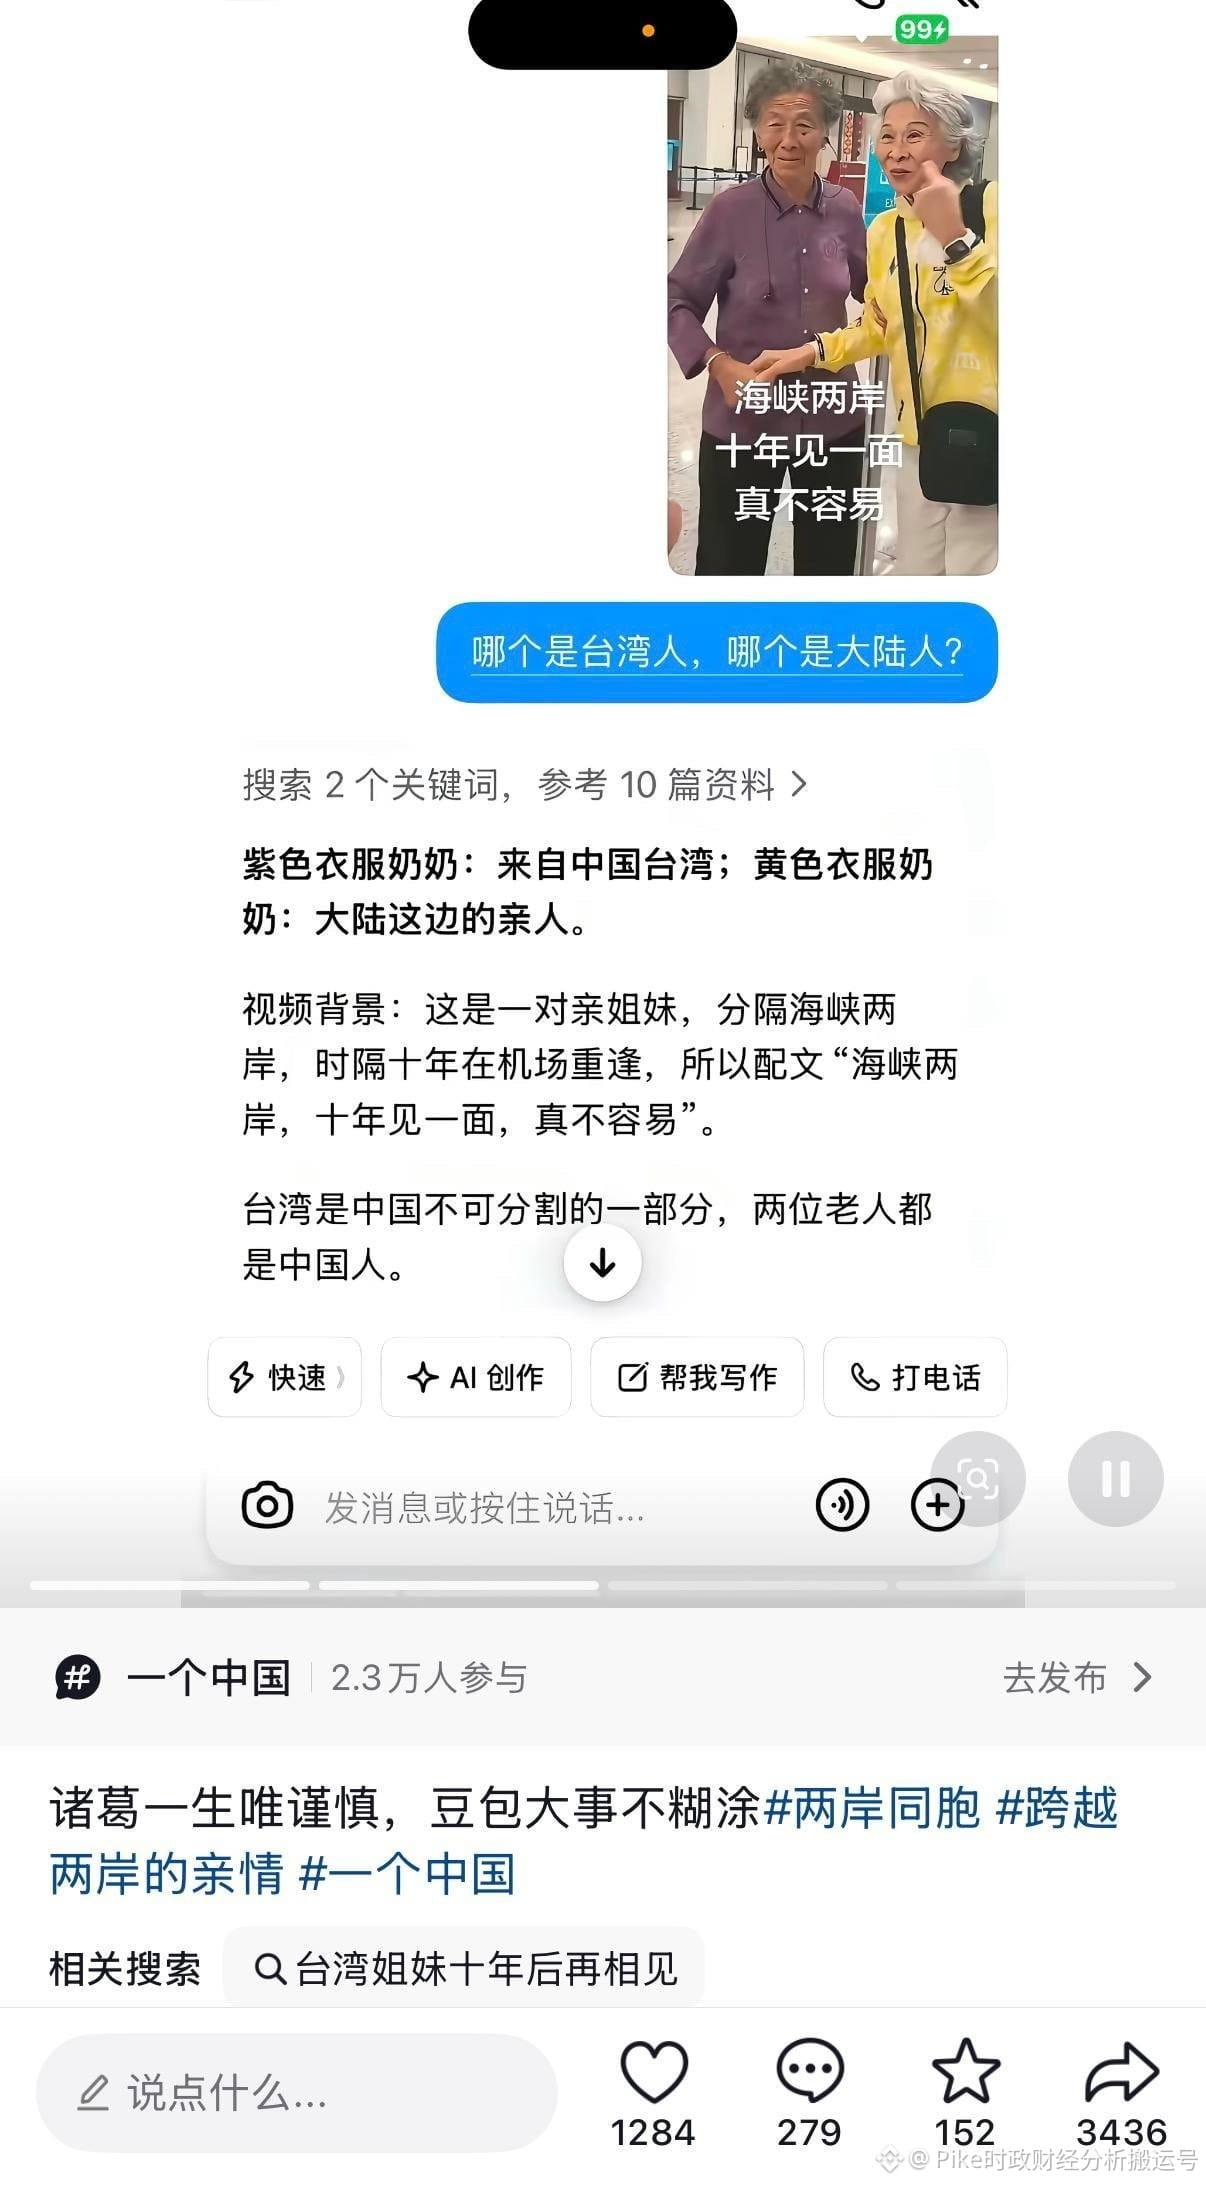
Batasan yang lebih mendasar justru terletak pada pertimbangan pengendalian sosial dan stabilisasi (weìwěn). Setelah pelatihan awal, model AI di dalam negeri pada sisi keluaran generatifnya tetap akan mengalami pembatasan ketat dari mekanisme pengawasan AI dan penelaahan konten oleh pemerintah. Ini berarti bahwa ketika menangani beberapa masalah tertentu, prinsip pertama yang mendasari cara model beroperasi tidak lagi adalah menyajikan informasi yang paling sesuai dengan fakta, melainkan memastikan bahwa respons yang diberikan adalah yang paling sesuai dengan ketentuan. Seperti yang terlihat pada gambar terkait, ketika sistem diminta menilai apakah dua guru tersebut berasal dari daratan (Tiongkok daratan), keputusan keliru sepenuhnya yang bertentangan dengan fakta justru terjadi karena campur tangan langsung dari mekanisme regulasi dan peninjauan tersebut.