Saya sekarang melakukan hedging terhadap dampak AI pada manusia. Salah satu cara latihannya adalah mengembalikan format pembuatan video YouTube saya ke model “shot tunggal” dari beberapa tahun lalu: selain pengeditan dasar seperti color grading dan menambahkan latar suara, tidak melakukan edit yang rumit, bahkan tidak menghilangkan kata seru atau kerancuan dalam ritme saat berbicara.
Persiapan pun dilakukan dengan cara membuat garis besar: menuliskan topik-topik yang ingin dibahas, menyiapkan terlebih dahulu konten yang akan dibagikan di layar, lalu memperlakukannya sebagai proses berbagi untuk menjelaskan kepada manusia.
Dari sudut pandang penyebaran video, tentu ini menjadi kelemahan: tidak ada edit yang dibuat dengan cermat, tidak ada penekanan hook yang rumit, bahkan tidak ada B-roll yang umum. Namun untuk latihan kemampuan saya sendiri, setiap kali membuat video seperti ini adalah latihan untuk kemampuan ekspresi saya sebagai manusia.
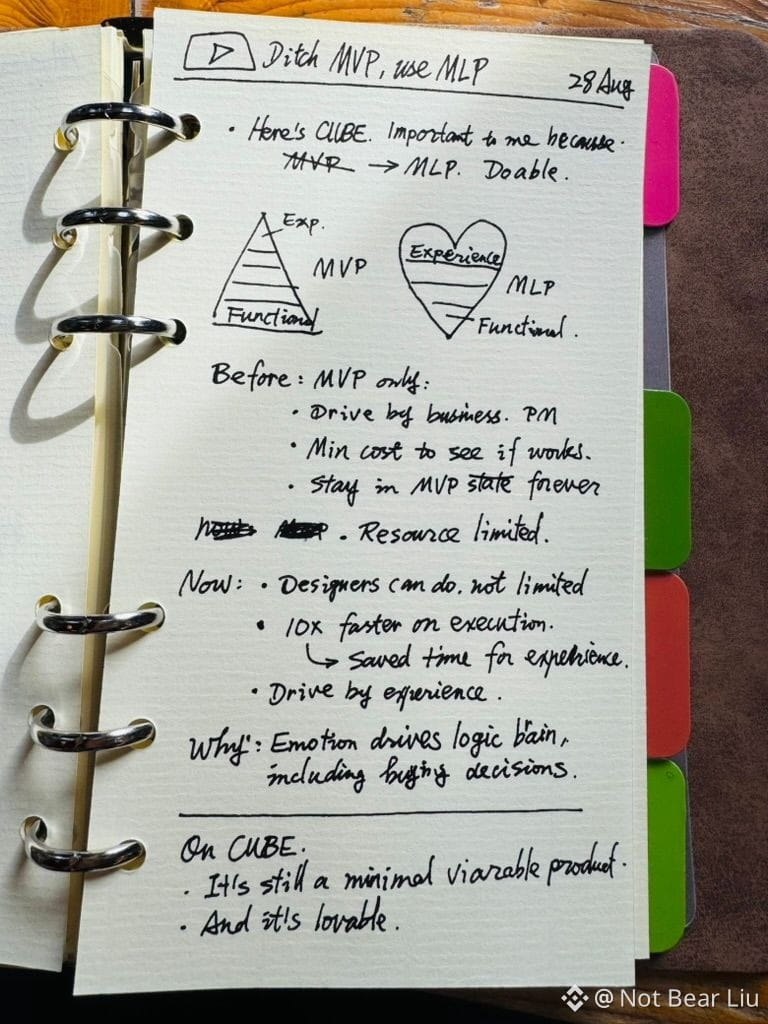
Misalnya, seperti yang terlihat pada gambar—itu adalah garis besar yang saya buat untuk video terbaru saya. Materi seperti ini tidak bisa dibacakan kata demi kata, jadi kemungkinan besar saya juga tidak akan berubah menjadi “mulut yang cuma menonjolkan daging”.
Tapi saya juga punya satu set proses di mana saya mundur dan semuanya diserahkan pada AI untuk dikerjakan. Saat ini podcast adalah seperti itu.
Persiapan pun dilakukan dengan cara membuat garis besar: menuliskan topik-topik yang ingin dibahas, menyiapkan terlebih dahulu konten yang akan dibagikan di layar, lalu memperlakukannya sebagai proses berbagi untuk menjelaskan kepada manusia.
Dari sudut pandang penyebaran video, tentu ini menjadi kelemahan: tidak ada edit yang dibuat dengan cermat, tidak ada penekanan hook yang rumit, bahkan tidak ada B-roll yang umum. Namun untuk latihan kemampuan saya sendiri, setiap kali membuat video seperti ini adalah latihan untuk kemampuan ekspresi saya sebagai manusia.
Misalnya, seperti yang terlihat pada gambar—itu adalah garis besar yang saya buat untuk video terbaru saya. Materi seperti ini tidak bisa dibacakan kata demi kata, jadi kemungkinan besar saya juga tidak akan berubah menjadi “mulut yang cuma menonjolkan daging”.
Tapi saya juga punya satu set proses di mana saya mundur dan semuanya diserahkan pada AI untuk dikerjakan. Saat ini podcast adalah seperti itu.