


Judul asli: (Unicorn AI hukum dengan valuasi 1,1 miliar dolar AS dari investasi OpenAI, mulai “membungkus” model open source Tiongkok)
Penulis asli: Beating DDC
20 Agustus, perusahaan AI hukum yang didanai OpenAI, Harvey, merilis Tenet. Perusahaan yang didirikan pada 2022 ini kini memiliki valuasi 11 miliar dolar AS, menjadi perusahaan AI hukum dengan valuasi tertinggi di dunia. Layanannya digunakan oleh ribuan institusi, dan daftar pemegang sahamnya juga mencakup Sequoia, a16z, serta GIC.
Tenet adalah model miliknya yang pertama. Fondasinya menggunakan Kimi K3 dari bobot terbuka Kimi yang dirilis pada Juli oleh Moonshot. Saat ini Tenet masih berada dalam tahap riset pratinjau, dan Harvey berencana secara bertahap memasukkan kemampuan yang telah terverifikasi ke dalam produk.
Pendiri Harvey, Winston Weinberg, awalnya adalah pengacara litigasi di O'Melveny & Myers; Gabe Pereyra pernah melakukan riset model besar di Google Brain dan Meta. OpenAI sudah ikut berinvestasi sejak sangat awal; setelah itu keduanya juga bersama-sama melatih model berbasis case law. Data case law AS dengan sekitar 10 miliar token dimasukkan ke dalam pelatihan. Di saat OpenAI merilis contoh kasus kliennya, Pereyra mengatakan Harvey menilai berbagai opsi, dan pada akhirnya hanya percaya pada opsi yang dikerjakan bersama OpenAI untuk pelatihan yang dikustomkan ini.
Dalam beberapa tahun terakhir, perusahaan ini hampir selalu menjadi pelanggan yang paling khas untuk model closed-source dalam industri layanan profesional, dan juga selalu bisa memanggil salah satu kumpulan model closed-source terkuat di dunia. Namun ketika untuk pertama kalinya ia memutuskan untuk benar-benar memasukkan tugas hukum miliknya, standar penilaian pengacara, dan komputasi selama dua bulan ke dalam satu paket bobot, basis yang dipilih justru sebuah model bobot terbuka dari Tiongkok.
Begitu sebuah model dirilis, industri dengan cepat akan mengetahui dua hal: seberapa cerdas model itu, dan berapa harga jual kemampuan-kemampuannya. Dalam beberapa jam, pembaruan benchmark dan perubahan peringkat Arena mulai menyebar, bersama berbagai grafik koordinat tentang kecerdasan dan harga. Sebuah model yang dilatih selama berbulan-bulan dan menghabiskan banyak komputasi, pada akhirnya dipadatkan menjadi satu titik di sebuah grafik.
Bagi kebanyakan pengembang, metode ini tetap berlaku. Prasyaratnya adalah bahwa ketika model diserahkan kepada pengguna, kemampuan sudah hampir terbentuk. Saat API closed-source menjadi arus utama, prasyarat ini masuk akal. Perusahaan model menyelesaikan pretraining dan post-training, lalu kemampuan itu dibungkus menjadi sebuah antarmuka. Perusahaan di hilir bisa mengubah prompt, melakukan penelusuran, atau membuat agent, tetapi sulit untuk terus mengubah kemampuan model itu sendiri.
Bobot terbuka mematahkan asumsi tersebut. Setelah perusahaan mendapatkan bobot, mereka dapat terus memasukkan data sendiri dan umpan balik dari para ahli, membawa tugas nyata dan standar penilaian ke dalam pelatihan. Sama-sama merilis dua model yang ketika rilis mendapat skor 90 dengan data dan komputasi yang sama: yang satu berhenti di 91, yang lain bisa mencapai 97. Bagi perusahaan yang bersiap menginvestasikan berbulan-bulan waktu, komputasi, dan sumber daya ahli, saat rilis dengan skor 90 yang sama saja sudah sangat berbeda rasanya di dunia nyata.
Namun ada prasyaratnya. Perusahaan bersedia menginvestasikan beberapa bulan waktu dan sejumlah komputasi untuk pelatihan lanjutan, dan pertama-tama harus ada bobot yang layak untuk dilatih. Dalam beberapa tahun terakhir, selalu ada jarak antara model terbuka dan model closed-source paling mutakhir. Pada tanya jawab umum dan penulisan kode harian, jaraknya tidak terlalu besar; tetapi ketika masuk ke skenario profesional dengan biaya kesalahan yang sangat tinggi, jarak itu akan diperbesar. Hukum termasuk salah satu bidang dengan tuntutan tertinggi. Di masa lalu, perusahaan seperti Harvey yang benar-benar bisa masuk ke bisnis inti mereka, pada dasarnya berbasis pada beberapa model closed-source paling kuat pada saat itu. Bobot terbuka memang lebih mudah dikontrol dan dimodifikasi, tapi bila tugas profesional paling dasar saja tidak bisa diselesaikan, maka ruang untuk pelatihan berikutnya pun tidak ada.
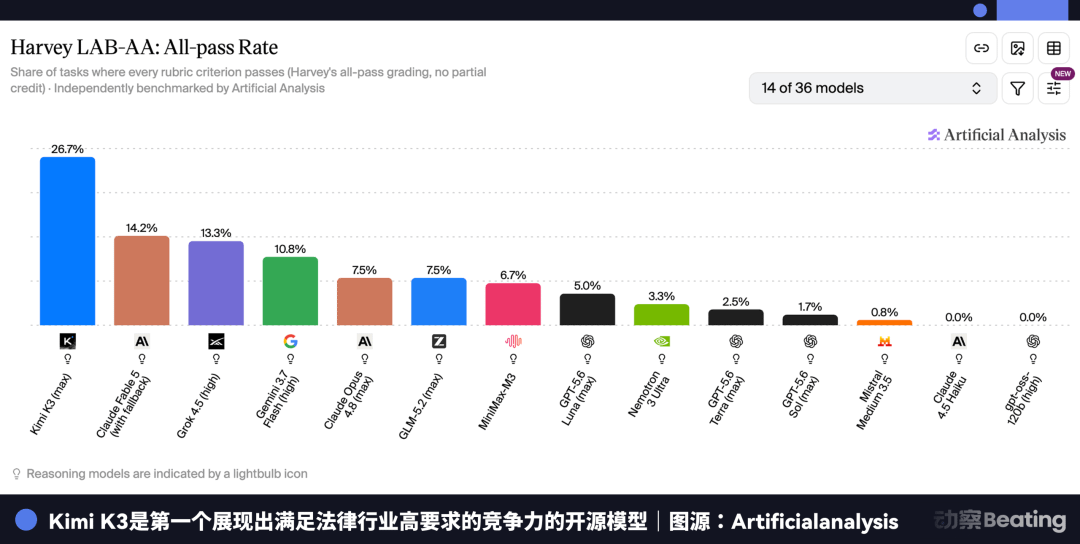
Kimi K3 untuk pertama kalinya melintasi ambang batas yang sudah lama ada. Total parameternya mencapai 2,8 triliun, mendukung konteks hingga 1 juta token, dan sudah memiliki kemampuan dasar yang cukup baik untuk tugas jarak jauh, penggunaan alat, serta penalaran kompleks. Bagi Harvey, model berbobot terbuka untuk pertama kalinya bukan sekadar opsi alternatif yang lebih murah biayanya dan kontrolnya lebih besar—melainkan mulai masuk ke lingkup yang bisa dinilai serius bersama model-model paling mutakhir.
Jadi mereka mulai peduli pada masalah yang sebelumnya jarang dibahas secara khusus: seberapa mudah bobot ini bisa dilatih lanjutan.
Saat melatih Composer 2, Cursor tidak memilih model mengikuti daftar peringkat agen pemrograman yang umum. Pertimbangannya adalah kemampuan agen dan tugas jarak jauh akan berubah jauh selama proses reinforcement learning; peringkat sebelum pelatihan belum tentu bisa memprediksi hasil akhir. Dibanding skor dari papan peringkat, Cursor lebih menilai pengetahuan pemrograman model, kemampuan melacak status, perplexity di basis kode internal, serta efisiensinya saat berjalan di infrastruktur milik mereka. Pada akhirnya, basis yang dipilih adalah model Kimi K2.5.
Cognition di balik Devin juga punya penilaian yang sama. Setelah K3 dirilis sebagai open-weight, mereka segera menghubungkan model ke Devin Desktop dan CLI. Di FrontierCode 1.1 Extended milik sendiri, K3 memperoleh skor 58,2% dengan tingkat kelulusan 63,6%. Tes ini menguji tugas-tugas rekayasa yang nyata: apakah kode pada akhirnya bisa masuk ke branch utama, dan apakah kualitasnya cukup—semuanya dihitung. Cognition juga menyebut bahwa K3 sangat baik dalam mereproduksi bug dan mengelola lingkungan eksekusi sendiri. Dua hal ini justru merupakan bagian yang paling mudah “gagal sambung” dalam tugas pemrograman jarak jauh. Setelah itu mereka juga melakukan pelatihan lanjutan pada bobot yang sama.
Sebenarnya yang paling langka bukanlah data hukum.
Pertumbuhan Harvey sangat cepat. Pada bulan Maret tahun ini, ia melayani sekitar 1300 institusi dan lebih dari 100.000 pengacara. Lima bulan kemudian, jumlah pelanggan hampir berlipat dua, mencakup 70 negara. Di AmLaw 100, lebih dari tiga perempat firma hukum mengandalkan Harvey.
Nilai proyek layanan hukum tinggi dan toleransi terhadap kesalahan sangat rendah. Dalam sebuah laporan due diligence merger & akuisisi, mungkin perlu menemukan klausul perubahan pengendalian dari ratusan hingga ribuan dokumen, menilai apakah transaksi memicu persyaratan tertentu, lalu mengidentifikasi risiko dan menyertakan dasar kutipan dari teks aslinya. Di tengahnya, biasanya ada puluhan penilaian yang harus semuanya benar secara beruntun. Jika melewatkan satu masalah yang benar-benar memengaruhi transaksi, sebagian besar pekerjaan yang dilakukan dengan benar sebelumnya menjadi kurang berarti.
Seiring semakin banyak firma hukum yang menggunakan layanan ini, Harvey juga mengumpulkan jenis data yang sulit didapat sendiri oleh perusahaan pembuat model dasar. Ia tahu bagaimana pengacara akan menyusun suatu pekerjaan, dan ia juga tahu di mana mitra pada akhirnya akan mencari kesalahan pada hasil.
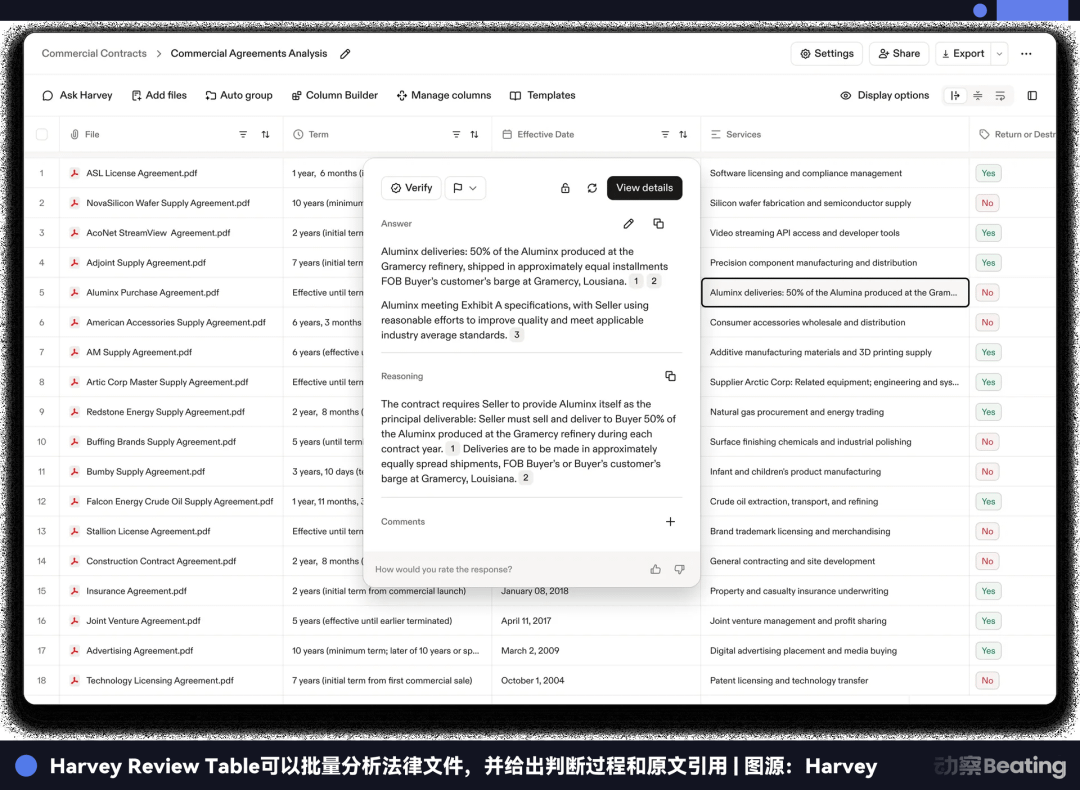
Pengalaman-pengalaman ini kemudian dibentuk menjadi Legal Agent Benchmark. Di dalamnya sudah ada lebih dari 1200 tugas hukum jarak jauh, mencakup 24 ranah praktik. Setiap tugas memiliki rata-rata deskripsi hanya sekitar 50 kata; setelah itu model masuk ke lingkungan urusan pelanggan yang tertutup. Dokumen terkait dan banyak materi yang tidak relevan dicampur bersama—model perlu mencari, membaca, menilai, lalu akhirnya menyerahkan hasil kerja yang dapat diperiksa langkah demi langkah.
Setiap tugas rata-rata memiliki sekitar 50 kriteria penilaian; tugas yang kompleks bisa mencapai ratusan kriteria. Apakah fakta dicari lengkap, apakah kesimpulannya bisa dibenarkan, apakah kutipan sesuai dengan teks asli, apakah tingkat risiko dan saran masuk akal—semuanya dipecah menjadi butir penilaian yang bisa diputuskan secara terpisah. Satu tugas paling lama bisa berlangsung lebih dari 1000 putaran, menghabiskan puluhan hingga ratusan ribu token.
Setelah beberapa tahun bekerja, pengacara muda perlahan akan memahami benar kekhawatiran apa yang dimiliki klien, serta mengingat ketentuan-ketentuan yang tampak sepele namun tidak boleh terlewat. Pengalaman ini dulu sulit dimasukkan secara lengkap ke dalam buku ajar; kebanyakan hanya tersimpan dalam revisi mitra, kebiasaan kerja di dalam tim, dan berkas-berkas yang sudah diserahkan dari waktu ke waktu.
Harvey memecah sebagian di antaranya menjadi tugas, materi, dan kriteria penilaian. Proses model setiap kali menyelesaikan pekerjaan pun memiliki umpan balik yang bisa dihitung dan dibandingkan.
Prompt dan penelusuran memberi tahu model ke mana harus mencari; kriteria penilaian mulai menjawab pertanyaan lain: sampai sejauh mana pekerjaan hukum dianggap benar-benar selesai. Selama beberapa tahun terakhir, yang benar-benar berhasil dikumpulkan Harvey bukan hanya pelanggan dan data hukum—melainkan juga sebuah sistem penilaian profesional yang bisa langsung dipakai untuk pelatihan model.
Menuliskan pengalaman hukum ke dalam bobot
Tugas dan kriteria penilaian ini benar-benar masuk ke tahap pelatihan. Datanya berasal dari materi hukum publik, data sintetis, dan data dari ahli manusia. Pengacara yang praktik terlibat dalam penyusunan tugas, penilaian, serta verifikasi ulang data sintetis. Harvey menyiapkan total sekitar 1750 lingkungan tugas legal agent.
Setelah model masuk ke ruang kerja yang berisi materi dan alat, ia harus membaca dokumen sendiri, memanggil alat, dan mengirimkan hasil; lalu sistem memeriksa seluruh lintasan kerja sesuai standar yang ditetapkan oleh pengacara. Berapa banyak persyaratan yang dipenuhi dan sejauh mana masalah hukum diselesaikan—semuanya dinilai. Jika semua persyaratan utama lolos, model juga akan memperoleh hadiah tambahan.
Setiap siklus pelatihan menghasilkan lebih dari sepuluh ribu jejak (trajectory) tugas. Harvey menggunakan strategi sekuens grup, yaitu GSPO, untuk mengoptimalkan: pada tugas yang sama, model menghasilkan beragam cara, lalu bobot diperbarui berdasarkan perbedaan kualitas antarhasil. Bila skor dua jejak terlalu mirip, sistem akan menilai ulang untuk mengurangi dampak kebisingan evaluasi terhadap pelatihan.
Seluruh proses berlangsung sekitar dua bulan, menggunakan sekitar 150 kartu NVIDIA B300. Melatih model terdepan biasanya memerlukan puluhan ribu kartu; komputasi yang diinvestasikan Harvey kali ini berada pada satu orde yang berbeda. Harvey menggunakan rank-64 LoRA, mencakup lapisan atensi Kimi K3, jaringan feed-forward, dan bobot ahli routing, melibatkan sekitar 500.000 tensor ahli.
Pelatihan dengan lintasan panjang juga menghadapi persoalan rekayasa. Satu tugas hukum bisa berlangsung ratusan putaran; sementara model masih menghasilkan jejak tugas, bobot di sisi pelatihan sudah diperbarui. Ketika trainer balik menghitung lintasan itu, jika keadaan model di kedua sisi tidak sama, maka probabilitas yang terkait dengan setiap langkah pada saat itu akan berubah—sehingga reward sulit diterapkan secara akurat pada keputusan semula.
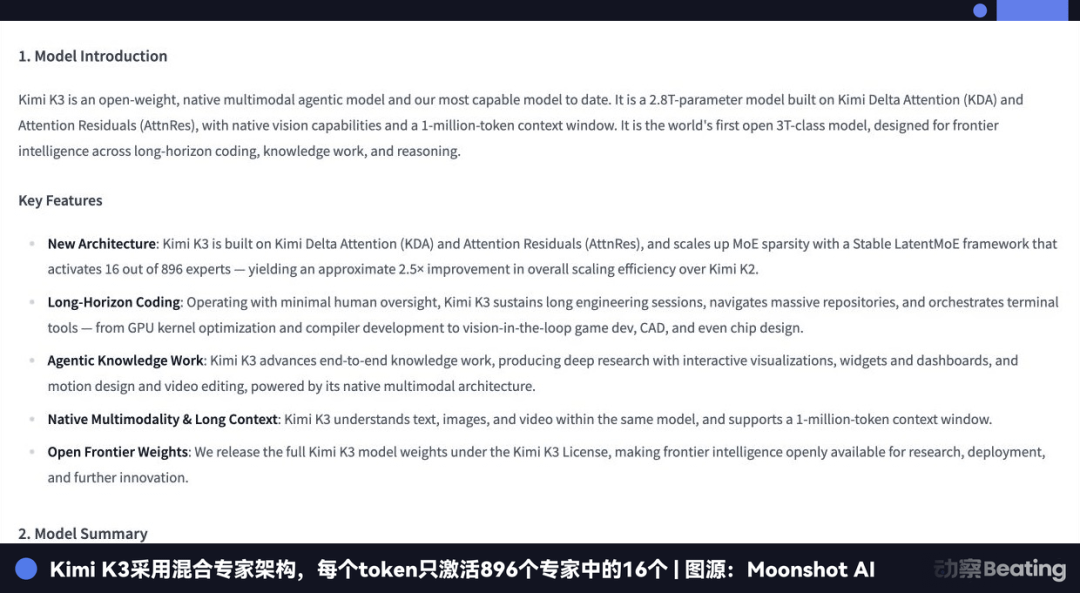
Struktur mixture-of-experts (MoE) pada Kimi K3 membuat masalah ini semakin kompleks. Setelah setiap token masuk ke model, router memilih 16 dari 896 ahli untuk ikut melakukan komputasi. Bila hanya ada perbedaan kecil pada ketelitian presisi numerik dan cara batching antara sisi pelatihan dan sisi eksekusi, token yang sama bisa saja dialokasikan ke ahli yang berbeda—sehingga jejak (trajectory) aslinya pun sulit direplikasi secara utuh.
Karena itu, Harvey dan pemasoknya melakukan penyelarasan angka (numerical alignment) pada pelatih (trainer) dan lingkungan eksekusi hingga ke lapisan kernel. Setiap kali bobot menyelesaikan pembaruan, bobot langsung di-hot-load ke lingkungan eksekusi, tanpa perlu berkali-kali berhenti untuk menghasilkan tugas. Sistem juga mencatat hasil routing ahli yang sesuai dengan token, sehingga saat trainer menghitung ulang, ia dapat kembali sedekat mungkin ke lintasan yang ditempuh model ketika menghasilkan jejak itu.
Sampai di sini, Tenet sudah tidak terlalu mirip fine-tuning biasa yang memasukkan korpus hukum ke dalam model secara satu kali. Yang dibangun Harvey adalah rangkaian proses pelatihan yang bisa dijalankan berulang kali. Tugas hukum terus masuk ke lingkungan, model menyelesaikan pekerjaan, standar penilaian yang dibuat oleh pengacara mengevaluasi seluruh lintasan; bobot kemudian diperbarui. Model baru kembali lagi ke lingkungan itu untuk menjalankan putaran tugas berikutnya.
Apakah Kimi K3 bisa dilatih lanjutan secara stabil juga diuji secara nyata lewat loop seperti inilah.
Setelah pelatihan, ia lebih mirip sebuah legal Agent.
Yang benar-benar ingin ditingkatkan Harvey adalah kemampuan model menyelesaikan pekerjaan hukum jarak jauh. Ia menggunakan tolok ukur all-pass yang sangat ketat: kriteria penilaian utama dalam satu tugas harus semuanya lolos. Berdasarkan hasil internal yang dipublikasikan Harvey, pada LAB holdout yang tidak ikut dilatih, jumlah tugas yang diselesaikan lengkap oleh Tenet mendekati dua kali lipat jumlah Kimi K3 asli; all-pass rate naik dari sekitar 11% menjadi 19,7%, atau bertambah sekitar 9 poin persentase.
Pada LAB Contracts yang secara khusus menguji pembuatan, peninjauan, dan negosiasi kontrak, jumlah tugas yang berhasil meningkat sekitar 20%; tingkat all-pass mencapai 11,3%, naik sekitar 2 poin persentase. Menurut papan peringkat milik Harvey sendiri, Tenet berada di peringkat pertama pada LAB Contracts dan peringkat kedua pada keseluruhan LAB.
Setelah itu, Tenet juga dimasukkan ke dua set pengujian eksternal: Mercor APEX Agents Corporate Law dan Crosby Redline Bench. Yang pertama menguji tugas profesional jarak jauh yang mensimulasikan lingkungan kerja; yang kedua menuntut model untuk mengubah kontrak secara berkelanjutan, lalu memberi skor berdasarkan standar yang ditetapkan oleh pengacara.
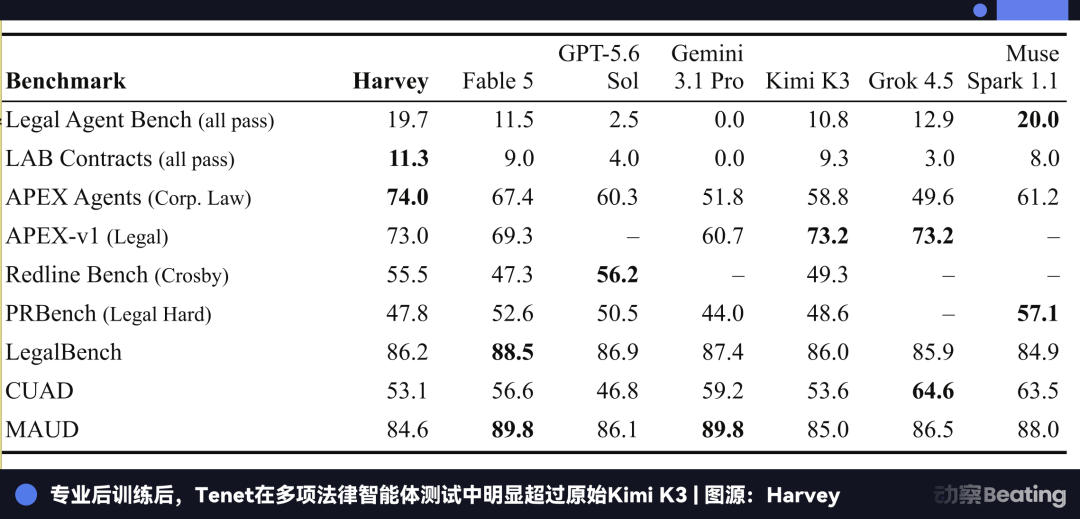
Tenet tidak pernah menyentuh data pelatihan dari dua set pengujian ini, namun hasilnya tetap jauh lebih tinggi daripada Kimi K3 asli. Ini menunjukkan bahwa kemampuan yang dilatih dalam lingkungan tugas Harvey dapat dipindahkan ke tugas hukum baru.
Namun masalah lainnya adalah, pelatihan lanjutan di bidang profesional sering membuat model makin jago pada satu jenis pekerjaan tertentu, sekaligus kehilangan sebagian pengetahuan dan kemampuan penalaran yang asli.
Pada LegalBench, CUAD, dan MAUD, Tenet tidak menunjukkan kemunduran yang jelas. Pada sub-benchmark yang menantang dari Scale Professional Reasoning Benchmark, skornya bahkan naik sedikit dari 36,0% menjadi 36,8%. Setidaknya dari hasil kelompok ini, setelah Kimi K3 menjadi lebih kuat dalam tugas hukum, tidak terlihat masalah lupa kemampuan (ability forgetting) yang berarti.
Desain hadiah (reward) Harvey akan lebih condong ke lintasan yang lebih pendek ketika kualitas hasilnya mirip. Karena setiap kali agen hukum membaca satu dokumen lagi atau memanggil satu alat lagi, konsumsi token dan waktu tunggu pun meningkat. Setelah pelatihan, Tenet mengurangi sebagian langkah yang tidak efektif; kualitas tugas meningkat, sementara biaya untuk menyelesaikan pekerjaan tetap relatif stabil.
Yang paling berubah setelah pelatihan kali ini adalah cara Kimi K3 menangani pekerjaan hukum yang kompleks. Ia lebih pandai menyusun langkah, memanggil alat, dan lebih sedikit melewatkan persyaratan penting dalam tugas.
Harvey sejak awal tahun 2025 sudah mulai menggunakan strategi multi-model; tahun ini pun masih terus mengintegrasikan model-model baru dari OpenAI dan Anthropic. Tenet akhirnya membuat dalam sistem ini untuk pertama kalinya muncul satu model berbobot terbuka yang dilatih dan dikendalikan sendiri oleh Harvey.
Yang dibutuhkan adalah sebuah model yang fondasinya sudah lolos. Tugas hukum Harvey mungkin perlu menangani banyak dokumen, menjalankan ratusan bahkan ribuan putaran secara berurutan, sementara model harus mempertahankan state selama pekerjaan yang panjang. Pelatihan lanjutan bisa terus membentuk cara model menangani pekerjaan hukum, tetapi sulit untuk melengkapi dari nol kemampuan yang sebelumnya bahkan belum dimiliki oleh basisnya.
Syarat lainnya adalah kontrol. Harvey dapat memanggil GPT dan Claude lewat API, tetapi tidak bisa terus “menuliskan” 1750 lingkungan tugas hukum beserta standar penilaian pengacara ke dalam model closed-source tersebut. Bobot terbuka memungkinkan Harvey menentukan sendiri bagaimana pelatihan dilakukan, bagaimana desain reward dibuat, dan juga membiarkan kemampuan profesional yang telah dilatih tetap berada di bawah kendali bobot yang mereka pegang.
Namun setelah mendapatkan bobot, masih perlu menguji apakah model ini cocok untuk pelatihan lanjutan. Apakah reinforcement learning dengan lintasan panjang bisa berjalan stabil? Apakah routing mixture-of-experts bisa mereplikasi secara akurat? Setelah kemampuan profesional meningkat, apakah pengetahuan lama akan hilang? Dan apakah biaya penalaran masih bisa dikendalikan dalam batas yang layak dipakai di produksi—semuanya harus benar-benar dicoba sekali baru diketahui.
Setelah Tenet selesai menjalankan pelatihan selama dua bulan, Kimi K3 memberikan jawaban untuk putaran ini. Proses pelatihan bisa berjalan stabil, kemampuan untuk tugas hukum meningkat secara nyata, tidak terlihat pelupaan kemampuan yang signifikan, dan biaya tidak ikut lepas kendali mengikuti efeknya.
Bagi Harvey, hasil-hasil ini lebih penting daripada konsep “open-weight” itu sendiri. Bobot bisa diunduh, dan itu hanya menunjukkan perusahaan punya hak untuk terus melakukan pelatihan. Setelah pelatihan, berapa banyak kemampuan yang tertinggal—itulah yang menentukan apakah model ini layak terus diinvestasikan komputasi, data, dan waktu para ahli.
Satu bisnis lain perusahaan model
Harvey mengatakan tujuannya adalah agar firma hukum dapat melatih model privat mereka sendiri pada bobot terbuka, serta memiliki kemampuan yang terbentuk setelah pelatihan. Tenet yang diserahkan—lebih tepatnya bukan sekadar seperangkat model, melainkan seperangkat cara untuk melakukannya.
Dulu, bisnis perusahaan model dasar sebagian besar terjadi lewat pemanggilan setelah model dirilis. Bobot terbuka membawa relasi lain: sebuah perusahaan dapat mengambil model dasar yang sudah jadi untuk pelatihan lanjutan, menyimpan pengetahuan industrinya ke dalam bobot, dan pada akhirnya memperoleh model yang lebih mendekati bisnis mereka sendiri.
Jenis kebutuhan ini sebelumnya sulit sekali membentuk pasar yang benar-benar nyata. Ketika kemampuan model umum tidak cukup kuat, perusahaan vertikal sekalipun mendapatkan bobot, tetap sulit menutup kekurangan pada penalaran jarak jauh, pemanggilan alat, dan penanganan tugas kompleks hanya lewat pelatihan lanjutan. Melatih dari nol terlalu mahal, dan sebagian besar perusahaan tidak perlu melakukannya.
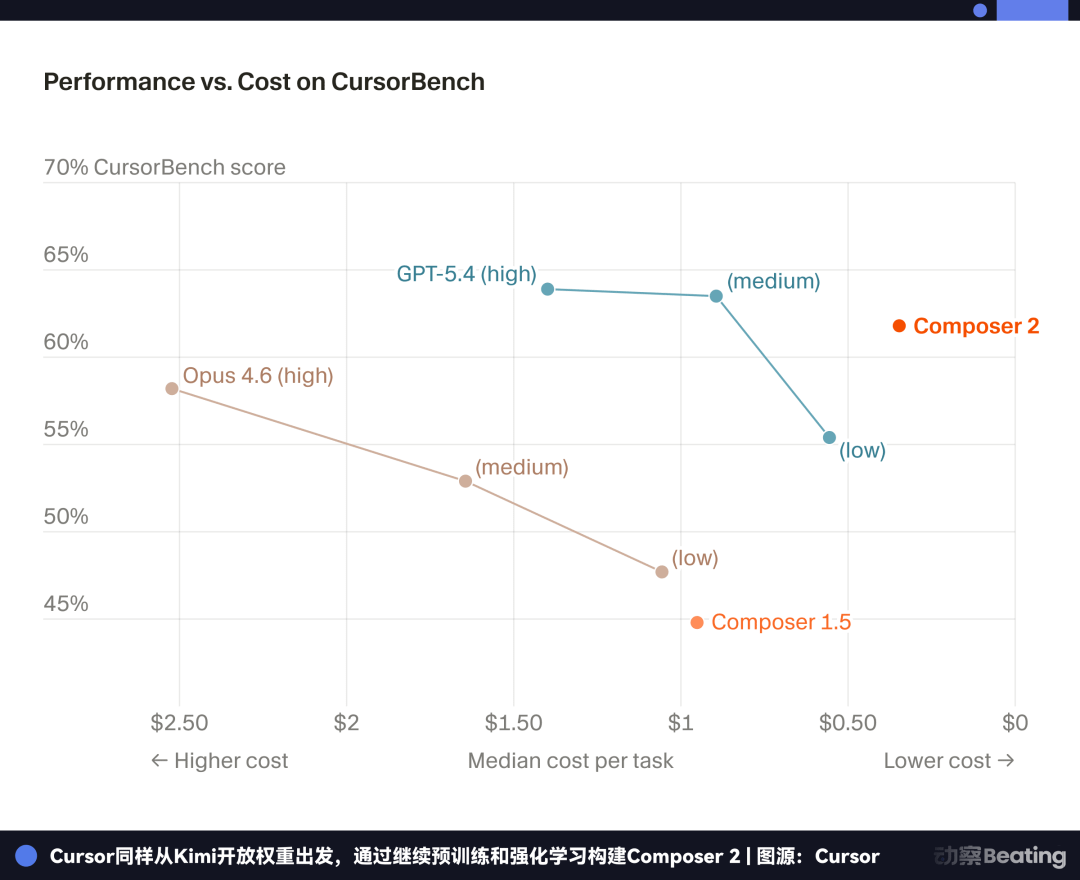
Cursor melatih Composer 2 dalam pemrograman; Cognition kemudian melanjutkan pelatihan Devin dengan bobot yang sama. Lalu Harvey membuat Tenet di bidang hukum. Walaupun pemrograman dan hukum berjarak jauh, keduanya memilih berangkat dari kemampuan umum yang sudah dilatih Kimi, lalu memasukkan kembali pekerjaan profesional yang paling mereka pahami.
Tenet juga membuat ambang batas itu menjadi konkret. Dua bulan, sekitar 150 kartu (GPU), ditambah seperangkat standar penilaian yang didefinisikan oleh pengacara yang praktik—sebuah perusahaan dapat mendorong seperangkat bobot umum ke garis depan di industrinya sendiri. Ambang batas komputasi sudah turun satu orde besaran; bagian yang lebih sulit direplikasi mulai berpindah ke sisi lain. Pertanyaannya: apakah ada yang bisa menjelaskan sampai tingkat apa suatu pekerjaan profesional dianggap selesai.
Pengembangan perangkat lunak dan hukum hanyalah dua contoh yang sudah muncul. Keuangan, konsultasi, farmasi, akuntansi, serta banyak industri layanan profesional lainnya semuanya memiliki data, alur kerja, dan penilaian para ahli mereka sendiri. Industri-industri ini sendiri adalah pasar pekerjaan pengetahuan yang ukurannya mencapai triliunan dolar. Perusahaan-perusahaan paling teratas di dalamnya mungkin tidak men-train model dasar mereka sendiri sejak awal, namun semakin mampu melakukan pelatihan lanjutan terhadap model yang merupakan “miliknya” dengan bobot yang sudah matang.
Jika jalur ini terus terbukti benar, pasar yang dihadapi Kimi tidak lagi hanya soal berapa banyak orang memanggilnya. Yang lebih layak diperhatikan berikutnya adalah: setelah Harvey, Cursor, dan Devin, masih berapa banyak perusahaan yang memilih melatih model mereka sendiri di atas Kimi.
Tautan sumber asli