


Judul asli: (DeepSeek merilis model pemahaman visual, mata-mata yang datang terlambat seperti Paus Biru Besar)
Penulis asli: Dongcha Beating
Pada 21 Agustus 2026, DeepSeek meluncurkan model pemahaman visual terbaru deepseek-v4-flash-vision-exp, dan API multimodal resmi dibuka. Untuk pertama kalinya, para pengembang dapat mengirim gambar langsung ke antarmuka resmi DeepSeek.
Model ini mempertahankan konteks 1 juta token V4 Flash dan output maksimum 384 ribu token, mendukung JSON Output, Tool Calls, dan Responses API, serta kompatibel dengan Anthropic API.
Harga sepenuhnya mengikuti V4 Flash. Untuk setiap 1 juta token input, saat cache tidak ter-kena pada masa puncak biayanya 3 yuan, pada masa lenggang 1,5 yuan; saat cache ter-kena masing-masing adalah 0,1 yuan dan 0,05 yuan. Biaya output pada masa puncak adalah 9 yuan, pada masa lenggang 4,5 yuan. Beijing, setiap hari pukul 09.00–12.00 dan 14.00–18.00 termasuk jam puncak; 17 jam lainnya diberi diskon setengah harga.
Gambar juga dihitung berdasarkan token. Sebelum masuk ke model, setiap gambar akan diskalakan otomatis berdasarkan ukuran: yang lebih kecil dari sekitar 384×384 piksel akan diperbesar, sedangkan gambar besar akan dipadatkan menjadi total sekitar 800×800 piksel. Satu gambar maksimum menempati 384 token. Gambar 2000×2000 dan gambar 5000×5000 pada akhirnya bisa menghabiskan token yang benar-benar sama.
Dengan batas 384 token, biaya input untuk satu gambar pada masa puncak saat cache tidak ter-miss kira-kira 0.001152 yuan. Memproses seribu gambar seperti ini, biaya input gambar itu sendiri hanya sekitar 1.152 yuan; teks dan output model dihitung terpisah.
Yang ikut dirilis juga adalah Files API. Developer bisa mengunggah gambar terlebih dahulu, lalu memasukkan file_id ke dalam permintaan. Untuk satu gambar, cukup mengirim sekali; setelah itu bisa dirujuk berulang kali dalam permintaan berbeda. Dalam satu permintaan, maksimal masih bisa menampung 600 gambar. Saat menggunakan tautan eksternal atau Base64, batas ukuran satu gambar adalah 32 MiB; setelah dirujuk lewat Files API, bisa sampai 64 MiB.
API ini sendiri tidak dikenai biaya. Satu file maksimum 64 MiB, setiap pengguna paling banyak bisa menyimpan 25 GiB atau 10000 file. File dapat disetel kedaluwarsa dari 1 jam hingga 30 hari; jika tidak disetel masa berlaku, file dapat disimpan terus. Saat ini pihak resmi juga belum menyediakan antarmuka untuk mengunduh isi file. Developer bisa mengunggah, melakukan kueri, dan menghapus; model dapat membacanya. Ini lebih mirip kumpulan arsip gambar gratis yang khusus disiapkan untuk inferensi, bukan cloud drive biasa.
Tapi yang aneh sebenarnya bukan bahwa DeepSeek baru saja sampai hari ini bisa melihat gambar.
Dua timeline
Kalau hanya dilihat dari sisi riset, visual DeepSeek tidaklah terlambat.
Kalau dilihat hanya produk dan API, memang terlambat sangat lama juga.
Pada 11 Maret 2024, DeepSeek-VL dirilis open-source.
Ia punya dua versi, 1.3B dan 7B: bisa melihat gambar alam, web, rumus, grafik, dan dokumen. Pada bulan Oktober, Janus muncul dan memasukkan pemahaman serta generasi gambar ke dalam kerangka autoregresif yang sama. Pada 13 November, JanusFlow menyusul. Pada bulan Desember, DeepSeek-VL2 dirilis, mengganti menjadi arsitektur campuran pakar (MoE) dengan total parameter dibagi menjadi tiga tingkat: 3B, 16B, dan 27B.
Pada dini hari 28 Januari 2025, malam Tahun Baru Imlek, Janus-Pro dirilis open-source. Repositori resmi mencatatnya pada 27 Januari sesuai UTC.
Versi 7B pada evaluasi perintah pembuatan gambar dari GenEval memperoleh 0.80, melampaui DALL-E 3 yang tercantum di makalah sebesar 0.67. Ia memiliki bobot yang open-source, bisa dideploy lokal, dan juga ada demo publik.
DeepSeek tidak menghubungkannya ke API hosting miliknya.
Tepat satu minggu sebelumnya, R1 sudah mendorong DeepSeek ke sorotan. Janus tetap berada di GitHub dan Hugging Face. Untuk kebanyakan pengguna biasa, ia pun cepat menghilang dari pandangan.
Pada 20 Oktober 2025, DeepSeek-OCR dirilis open-source, memadatkan dokumen panjang dengan kompresi token visual. Pada 27 Januari 2026, OCR 2 dirilis.
Mulai dari DeepSeek-VL, dalam dua tahun setidaknya ada tujuh catatan publik yang bisa ditemukan: DeepSeek-VL, Janus, JanusFlow, VL2, Janus-Pro, OCR, dan OCR 2.
Riset visual terus dilakukan, dan terus dipublikasikan ke luar.
Hanya saja selama ini para developer biasa tidak pernah mendapatkan akses itu.
Di sisi lain, pada Maret 2024, antarmuka developer dari beberapa kompetitor utama sudah bisa menerima gambar. OpenAI pada November 2023 membuka GPT-4 Turbo with Vision; gambar bisa langsung masuk ke Chat Completions API; sebulan setelahnya, Google meluncurkan Gemini Pro Vision API; pada Maret 2024, seluruh jajaran Claude 3 menambahkan kemampuan visual.
Pada 25 April 2025, Li Yanhong di Baidu Create Conference mengatakan, “DeepSeek juga bukan segalanya.” Di antara beberapa masalah yang kemudian disebutkan, salah satunya adalah modalitas yang tunggal.
Penilaiannya adalah multimodal akan menjadi standar paket untuk model dasar, sementara pasar model murni teks akan semakin kecil.
Pada saat itu, DeepSeek sudah melakukan riset visual selama satu tahun.
Dini hari
Pada 7 dan 8 April 2026, sebagian pengguna membuka DeepSeek dan tiba-tiba di dalam tampilan muncul tiga pintu masuk.
“Cepat”, “pakar”, “visual”.
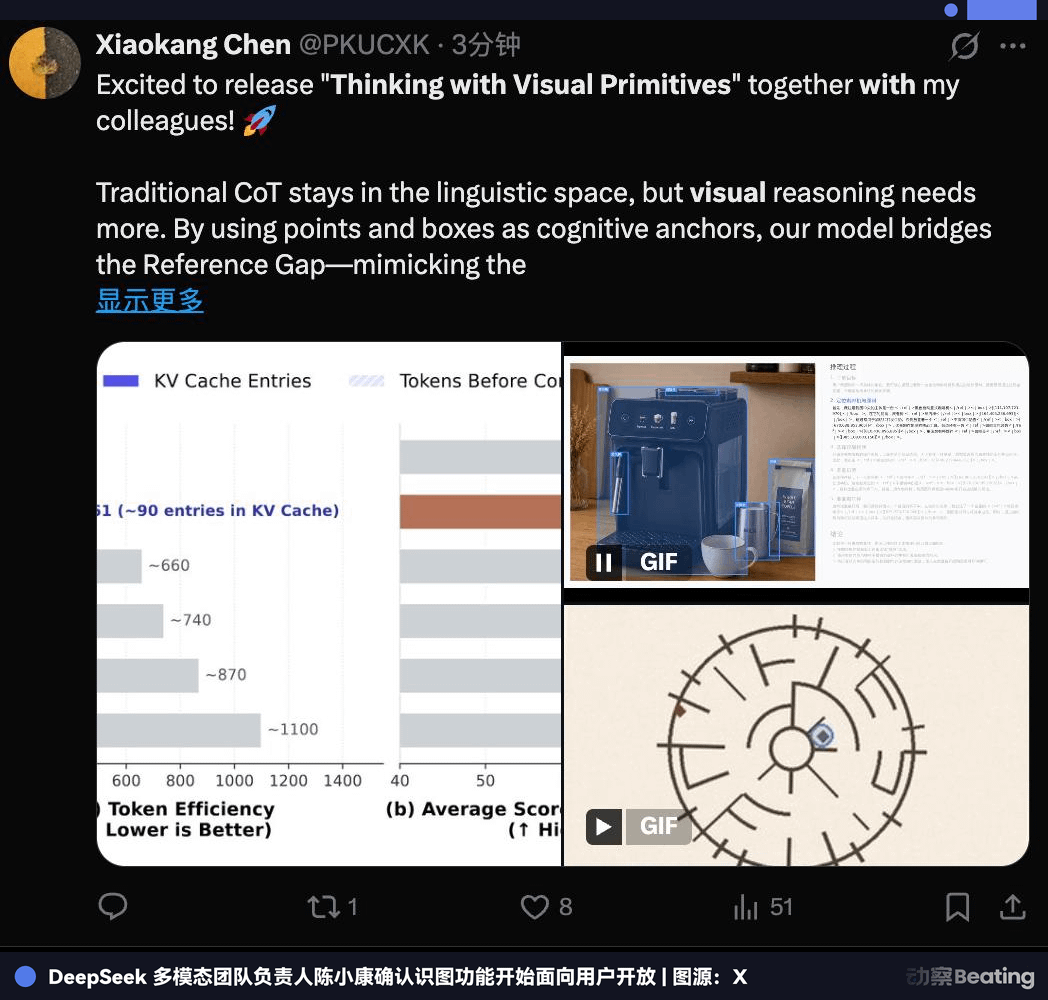
Pada 29 April, Chen Xiaokang, pemimpin tim multimodal DeepSeek, mengonfirmasi bahwa fitur melihat gambar mulai diuji bertahap untuk sebagian pengguna. Setelah itu, seorang peneliti senior DeepSeek menulis, “Sekarang si paus kecil sudah bisa melihat.” South China Morning Post langsung menaruh kalimat itu sebagai judul.
Mata DeepSeek untuk pertama kalinya benar-benar terlihat keluar dari antarmuka produk.
Keesokan harinya, DeepSeek memasang (Thinking with Visual Primitives) ke GitHub. Beberapa jam kemudian, repositori dan makalahnya ditarik. Pada 1 Mei, alamat aslinya sudah mengembalikan 404. DeepSeek tidak menjelaskan; di internet tersisa hanya cermin makalah dan pemberitaan ulang media.
Riset dalam makalah ini meneliti masalah yang sangat spesifik.
Setelah model melihat satu gambar yang sangat ramai, ia sering tahu apa yang sedang dibicarakannya, tetapi tidak bisa menjelaskan dengan jelas yang mana orangnya, yang mana garisnya. Tim menyisipkan koordinat titik dan bounding box langsung ke proses penalaran: model bisa menunjukkan lokasinya sambil terus berpikir ke langkah berikutnya.
Sebuah gambar berukuran 756×756 terlebih dahulu diproses oleh encoder visual, menjadi 2916 token blok gambar, lalu dikompresi secara spasial dengan 3×3 menjadi 324 token. Perhatian jarang V4 Flash terus mengompresi cache, hingga akhirnya hanya menyisakan 81 entri KV visual.
Tim juga menghasilkan lebih dari 40 juta sampel pelatihan untuk metode ini, termasuk data khusus untuk melatih navigasi labirin dan pelacakan jalur.
Penelitian pada makalah ini sebenarnya menghabiskan banyak tenaga untuk memecahkan hal yang sangat spesifik: “menunjuk di mana itu”.
Model harus bisa melihat dulu, baru ia tahu dirinya sedang melihat bagian mana. Hanya dengan begitu ia bisa terus melakukan penalaran berikutnya.
Kali ini DeepSeek tidak menjelaskan apakah Vision Exp sepenuhnya mengikuti rencana Visual Primitives ini. Yang lebih penting, riset ini pertama kalinya membuat pemahaman DeepSeek tentang “penalaran visual” terlihat ke publik.
Pada 18 Juni, mode melihat gambar di web dan aplikasi resmi diluncurkan. Keesokan harinya, media mengunggah foto hasil tes dari Liang Wenfeng; DeepSeek mengira dia adalah Zhang Yiming dua kali berturut-turut. Dengan percakapan lain, ia kembali mengira Zhang Yiming sebagai pendiri perusahaan pembuat chip—Chen Tianshi dari Cambricon.
Ia sudah bisa membaca screenshot berbahasa Inggris, dan juga bisa mengubah halaman web menjadi kode.
Namun ketika berhadapan dengan wajah, ia bahkan tidak bisa mengenali bosnya sendiri.
Pada 19 Agustus, DeepSeek Harness meninggalkan catatan teknis yang tanggalnya jelas. Adapter resmi sudah mampu menyerialkan urutan gambar menjadi image_url; dokumen juga menyebutkan bahwa direktori model default sementara tidak menampilkan deepseek-v4-flash-vision-exp—harus menunggu endpoint API yang sesuai agar tersedia.
Pada 20 Agustus, ada juga developer yang mencoba langsung dan menemukan bahwa mengirim gambar dengan nama model yang belum dibuka hanya akan menerima error 400.
Pada 21 Agustus, batasan ini dicabut. Harness memasukkan deepseek-v4-flash-vision-exp ke direktori model default; commit gabungannya langsung menuliskan “publish the vision model”. Setelah itu, dokumentasi resmi API DeepSeek dan akun resmi WeChat bersamaan mengumumkan Vision Exp sudah rilis.
Dua jalur akhirnya bertemu.
Agent
Dalam rekaman transkrip acara diskusi dengan investor pada bulan Mei tahun ini, Liang Wenfeng menyusun roadmap AGI yang ia pahami dalam beberapa anak tangga: model bahasa, chain of thought, Agent, pembelajaran berkelanjutan, iterasi diri, lalu kecerdasan yang terwujud secara fisik (embodied intelligence).
Multimodal ia tempatkan pada posisi komponen, mirip seperti pencarian.
Saat membahas pembuatan video, ada satu kalimat dalam transkrip:
Secara bisnis, ini adalah usaha yang bagus. Tapi ini tidak ada hubungannya dengan kecerdasan.
Penilaiannya adalah bahwa hubungan antara pembuatan video, model dunia pada tahap ini dan batas kapabilitas kecerdasan tidak terlalu besar; yang lebih mendesak justru pelatihan AI, serta pembelajaran berkelanjutan setelah pelatihan.
Perbedaan multimodal adalah meskipun juga ditempatkan di posisi “komponen”, itu adalah komponen yang secara jelas pernah dikatakan DeepSeek akan dikerjakan. Saat itu Liang Wenfeng juga menyebut bahwa V4 dan versi setelahnya akan mendukung multimodal native.
Dalam roadmap DeepSeek, visual selalu memiliki posisinya sendiri—hanya saja urutannya tidak terlalu di depan.
Begitu roadmap sampai ke tahap ketiga—Agent—kondisinya mulai agak berbeda.
DeepSeek tidak pernah secara terbuka mengatakan bahwa kali ini Vision API “dirilis untuk Agent”. Namun, jika penilaian Liang Wenfeng tentang roadmap digabungkan dengan pengumuman hari ini, kedua garis itu sudah sulit untuk dipisahkan sepenuhnya.
Agent perlu membaca layar, perlu melihat grafik, perlu memproses screenshot yang dilempar oleh tools. Ia tidak mungkin selamanya hidup di ruang teks murni. Kemampuan visual yang sudah dibuat selama dua tahun itu pun akhirnya, dari makalah, repositori, dan halaman pengujian, terus sampai ke API.
Tiga contoh yang DeepSeek tampilkan untuk Vision Exp hari ini juga bukan “sekadar berbicara tentang gambar” versi tradisional: satu Agent membuat PPT perjalanan self-drive ke Tibet untuk klien kelas atas, satu lagi mendesain ulang situs resmi DeepSeek Harness, dan satu lagi membuat demo front-end dengan efek dinamis berdasarkan kebutuhan visual.
Semuanya membutuhkan model untuk memproses informasi visual berulang kali dalam tugas beralur panjang.
Desain API juga bergerak ke arah tersebut. Responses API juga menerima input_image; setelah browser Agent mendapatkan screenshot halaman web, ia bisa mengirimkannya lagi ke putaran penalaran berikutnya; Agent berbasis kode dapat memeriksa hasil render—grafik, scan, dan antarmuka software juga bisa langsung menjadi konteks.
Files API menyelesaikan hal lain: satu gambar tidak perlu diunggah ulang dalam setiap putaran permintaan. Satu file bisa diletakkan di sana dalam jangka panjang; Agent hanya perlu mengirim file_id berulang kali. Dalam satu permintaan, maksimal juga masih bisa menampung 600 gambar. Saat memakai tautan eksternal atau Base64, batas satu gambar adalah 32 MiB; setelah dirujuk melalui Files API, bisa sampai 64 MiB.
Ini sudah tidak terlalu mirip menambahkan tombol “unggah gambar” ke kotak chat.
Lebih seperti sedang melengkapi infrastruktur dasar yang dibutuhkan saat Agent menggunakan visual.
Perbandingan empat Agent multimodal yang dipublikasikan DeepSeek juga sangat jarang menguji “berbicara tentang gambar” dalam pengertian tradisional.
ApexBench berfokus pada tugas alur panjang seperti perbankan investasi, konsultan, dan hukum. Agents' Last Exam berasal dari pekerjaan nyata dari 55 bidang profesional. Chartography menguji secara khusus kurva Kaplan-Meier, chart K-line, kontur, diagram aliran (Sankey), dan diagram titik (dot/Porter). ZeroBench menggunakan 100 soal buatan manusia yang dirancang untuk menguji penalaran visual multi-langkah.
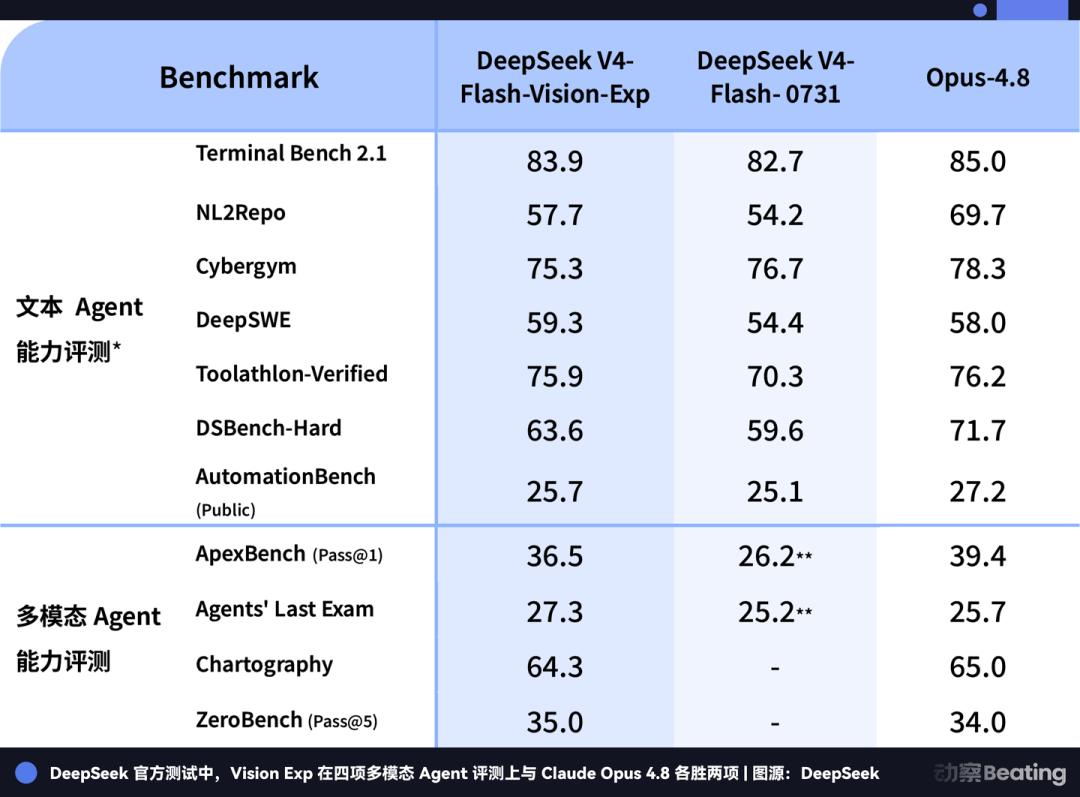
Vision Exp menang dua kali dan kalah dua kali melawan Claude Opus 4.8.
Agents' Last Exam 27.3 berbanding 25.7, ZeroBench 35.0 berbanding 34.0. ApexBench 36.5 berbanding 39.4, Chartography 64.3 berbanding 65.0. Selisih keempatnya tidak ada yang melebihi 3 poin.
Yang lebih menarik lagi, setelah menambahkan visual, kemampuan Agent teks yang sebelumnya tidak turun secara jelas.
Dibandingkan satu per satu dengan pure-text V4 Flash yang dirilis pada 31 Juli, situs web juga menampilkan lima evaluasi teks untuk Agent baik sebelum maupun sesudah—semuanya naik.
Terminal Bench 2.1 naik dari 82.7 menjadi 83.9, NL2Repo dari 54.2 menjadi 57.7, DeepSWE dari 54.4 menjadi 59.3, DSBench-Hard dari 59.6 menjadi 63.6, AutomationBench dari 25.1 menjadi 25.7. Nilai DeepSWE 59.3 juga melampaui Opus 4.8 58.0 pada gambar.
Namun, angka-angka ini berasal dari pengujian DeepSeek sendiri. Resmi juga mencatat bahwa pada tugas teks Agent Code Agent publik, model rangkaian DeepSeek menggunakan mode minimal dari DeepSeek Harness, dengan setelan penalaran pada max. Model-model ini lebih cocok untuk mengamati perubahan Vision Exp dibandingkan V4 Flash internalnya, bukan untuk dianggap sebagai peringkat independen pihak ketiga langsung.
Bagian exp setelah nama modelnya juga masih belum dicabut.
DeepSeek dengan jelas menandainya sebagai model eksperimen, dan versi masih mungkin terus berubah. Saat ini antarmuka hanya melakukan pemahaman gambar, sementara outputnya tetap berupa teks. Pembuatan gambar dan video belum dibuka. Files API juga hanya menerima JPEG, PNG, GIF, dan WebP; PDF tidak bisa langsung dimasukkan.
Pada 2024, developer ingin mengirim satu gambar ke DeepSeek, tetapi API resmi belum bisa menerimanya.
Pada 21 Agustus 2026, akhirnya gambar ini masuk.
Mata DeepSeek memang terlambat benar untuk terbuka.
Tapi ketika benar-benar mulai “membuka mata”, jalan di depan sudah tidak mengizinkannya untuk terus berjalan dengan mata terpejam.
Tautan sumber asli