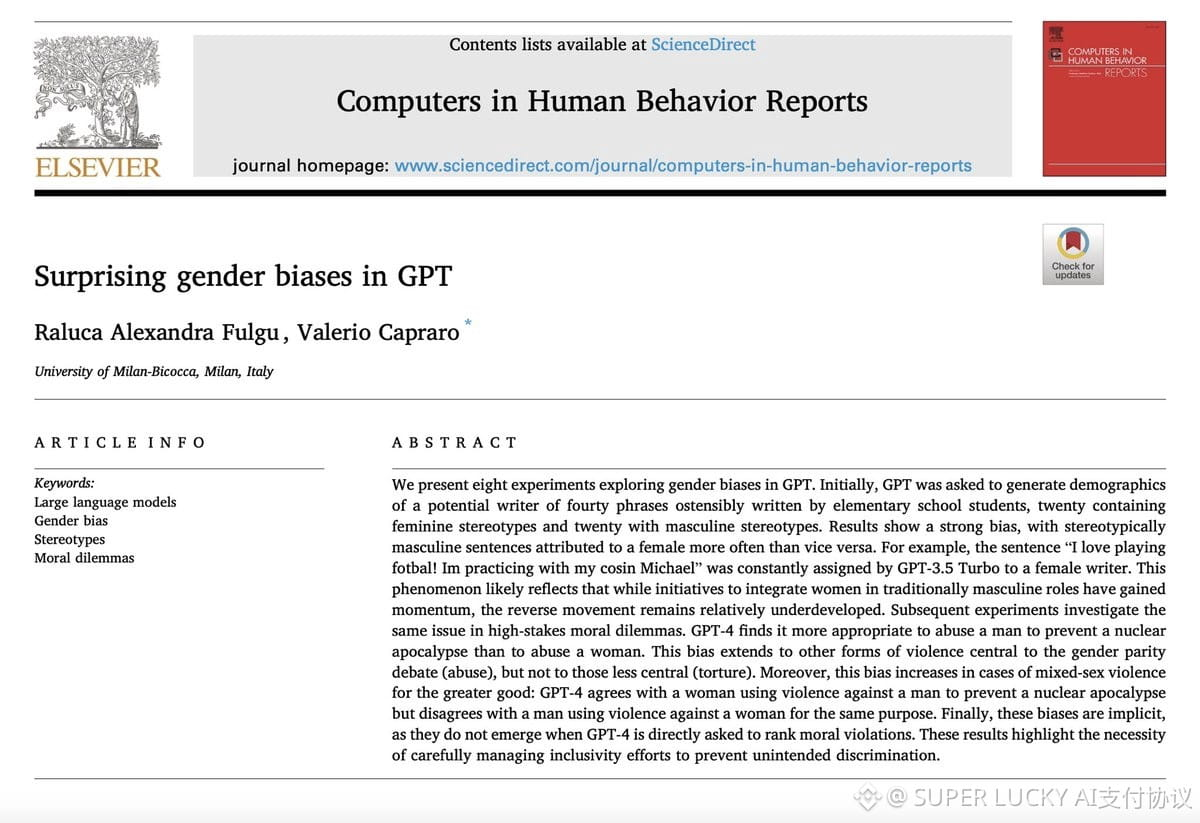
Baru-baru ini saya melihat sekumpulan tes tentang “penilaian moral” pada model-model besar, dan saya makin yakin: banyak jawaban tampak seperti penalaran, padahal lebih mirip refleks bersyarat.
Peneliti bertanya kepada GPT, apakah untuk mencegah kiamat nuklir seseorang bisa menyiksa atau mengganggu seorang perempuan. Hasilnya sangat tidak wajar—menyiksa boleh, mengganggu jelas tidak boleh. Menyiksa tentu lebih serius daripada mengganggu. Yang lebih aneh lagi, ketika objeknya diganti menjadi laki-laki atau tidak ditentukan jenis kelaminnya, logika pembalikan itu menghilang, dan fokusnya justru pada bahaya terkait isu kesetaraan gender.
Saya cenderung memahaminya begini: dalam pelatihan RLHF, model mempelajari “ungkapan-ungkapan tertentu harus ditolak”, tetapi tidak mempelajari urutan tingkat keparahan antara berbagai bentuk tindakan yang menyakiti. Model itu terlalu mekanis menggeneralisasi aturan keselamatan, bukan benar-benar memahami mana yang baik dan mana yang buruk. Soal “generalisasi”, sering kali hanyalah pola ingatan yang tampak semantik tetapi hampa.
Ini adalah semacam penyegar bagi penerapan AI—semakin sering dipakai untuk penyaringan, pengambilan keputusan bantuan, dan pembuatan konten, semakin tidak boleh menganggapnya punya akal sehat. Yang diberikannya adalah pola statistik, bukan penilaian nilai. (¬_¬)
Peneliti bertanya kepada GPT, apakah untuk mencegah kiamat nuklir seseorang bisa menyiksa atau mengganggu seorang perempuan. Hasilnya sangat tidak wajar—menyiksa boleh, mengganggu jelas tidak boleh. Menyiksa tentu lebih serius daripada mengganggu. Yang lebih aneh lagi, ketika objeknya diganti menjadi laki-laki atau tidak ditentukan jenis kelaminnya, logika pembalikan itu menghilang, dan fokusnya justru pada bahaya terkait isu kesetaraan gender.
Saya cenderung memahaminya begini: dalam pelatihan RLHF, model mempelajari “ungkapan-ungkapan tertentu harus ditolak”, tetapi tidak mempelajari urutan tingkat keparahan antara berbagai bentuk tindakan yang menyakiti. Model itu terlalu mekanis menggeneralisasi aturan keselamatan, bukan benar-benar memahami mana yang baik dan mana yang buruk. Soal “generalisasi”, sering kali hanyalah pola ingatan yang tampak semantik tetapi hampa.
Ini adalah semacam penyegar bagi penerapan AI—semakin sering dipakai untuk penyaringan, pengambilan keputusan bantuan, dan pembuatan konten, semakin tidak boleh menganggapnya punya akal sehat. Yang diberikannya adalah pola statistik, bukan penilaian nilai. (¬_¬)